n8n 静态数据与执行数据:核心区别与实战用法

n8n中执行数据仅限单次运行,静态数据跨运行持久,需按场景正确选择。
文章区分了 n8n 中两类关键数据:执行数据与工作流静态数据。执行数据是单次执行流水线内的临时负载,承载节点间传递的 API 响应、中间结果等,运行结束即清空;静态数据则挂载在工作流层面,跨多次执行持久保存,用于记录时间戳水位线、分页游标、去重 ID 等状态。判断标准很简单:下次运行是否需要?需要则存静态数据,否则用执行数据。实战中两者协同,如增量同步时读静态数据发起请求,用执行数据承载响应,最后写回新状态。常见误区包括用执行数据做持久化、忘记写回游标、静态数据当缓存滥用以及忽略并发竞争。
n8n 静态数据与执行数据:核心区别与实战用法
在 n8n 中构建自动化工作流时,数据管理是决定流程可靠性的关键。很多初学者会把「工作流静态数据」(Workflow Static Data)和「执行数据」(Execution Data)混为一谈,结果在跨次运行的状态保持上频频踩坑。本文基于 YouTube 教程频道对这两个概念的拆解,帮你建立清晰的心智模型。
为什么必须区分这两种数据
n8n 的节点在运行时会产生大量临时信息:HTTP 响应、数据库查询结果、文件内容等。这些信息绝大多数只服务于当前这一次执行(execution),任务结束后就没有保留价值。
但有一类信息需要跨越多次执行存活,比如上次同步到的时间戳、分页游标、去重用的 ID 集合。如果把它们混在普通执行数据里,工作流每次重新触发都会「失忆」,导致重复抓取或漏抓数据。
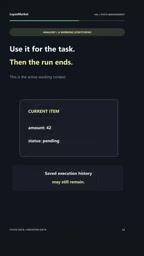
教程中用了一个很贴切的比喻:工作流静态数据像一本持久笔记本,写下的标记在多次运行之间一直保存;执行数据则像桌上的草稿纸,当前任务一结束就被彻底清空。 理解这个分界,才能正确选择数据存放位置。
执行数据:单次运行的临时载体
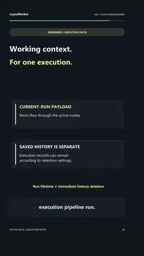
执行数据(Execution Data)是节点之间传递的 payload。当一个节点输出数据,下个节点接收处理,这些数据都属于同一次 execution 的生命周期。
它的典型特征:
- 作用域限定在单次执行内:工作流跑完,执行数据随之消失。
- 承载业务负载:API 返回的 JSON、待处理的记录列表、转换后的中间结果,都走这条通道。
- 不适合存长期状态:如果拿执行数据记录「上次同步位置」,下次触发时它会回到初始状态。
据视频讲解,执行数据严格存在于一条执行流水线的运行期间("lives strictly for the duration of a single execution pipeline run")。这意味着任何依赖前次运行结果的逻辑,都不能指望它。
实践中常见的误用是:用 Set 节点保存一个计数器,期望它在下一次定时触发时继续累加。结果每次都从零开始,因为执行数据已经被重置。
理解执行数据的生命周期,需要了解 n8n 的执行模型。n8n 工作流由多个节点串联而成,每个节点接收上游传入的数据项(item),处理后输出给下游。这些数据以 JSON 对象数组的形式存在,构成了执行数据的主体。工作流的每次触发——无论是定时器、Webhook 还是手动点击运行——都会生成一个独立的执行实例,拥有自己的数据空间。如果开启保存执行记录,这些数据会以历史日志形式留存供调试查看,但节点本身无法读取历史执行的数据,新的执行始终从空白状态开始。这一点与编程语言中函数局部变量的行为类似:函数每次调用都重新初始化局部变量,调用结束后变量即被销毁。
工作流静态数据:跨执行的持久状态
工作流静态数据(Workflow Static Data)解决的是状态持久化问题。它挂载在工作流层面,不会随着单次执行结束而清除。
视频给出的两类典型场景:
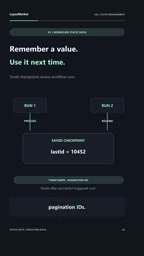
- 高水位时间戳(high-watermark timestamp):记录上次抓取到的时间点,下次只拉取增量数据,避免全量重复。
- 分页游标/ID 集合:记录上次翻到第几页,或已处理过的记录 ID,用于断点续跑与去重。
它的核心价值在于保留状态与记忆("preserves state and memory across multiple workflow invocations")。对于定时轮询、增量同步、分页抓取这类需要「记住上次做到哪」的流程,静态数据几乎是必备工具。
需要注意的是,静态数据的写入通常通过节点内部的静态数据接口完成,而不是像执行数据那样在节点间自然流动。这意味着使用它时需要明确地读取和更新,而不是被动接收。
工作流静态数据在 n8n 的实现中,通过 Code 节点提供的 $getWorkflowStaticData() 方法访问,支持两种存储类型:global(所有工作流共享)和 node(仅当前节点可见,为默认值)。返回的是一个普通 JavaScript 对象,你可以像操作字典一样读写其中的键值对,n8n 会在执行完成后将其持久化到数据库。值得注意的是,静态数据在活跃的工作流中会自动保存,但在编辑未激活的工作流时不会写入,因此调试时需留意这一行为差异。对于需要存储大量数据或需要强一致性保证的场景,建议使用外部数据库(如 Redis、PostgreSQL)替代静态数据。
一张对比表看清差异
| 维度 | 执行数据 | 工作流静态数据 |
|---|---|---|
| 生命周期 | 单次执行 | 跨多次执行持久保存 |
| 作用范围 | 单次流水线内的节点间传递 | 整个工作流级别 |
| 典型用途 | API 响应、中间结果、待处理列表 | 时间戳水位线、分页游标、去重 ID |
| 结束行为 | 执行完成后清空 | 保留,直到被显式更新或清除 |
| 比喻 | 桌上草稿纸 | 持久笔记本 |
这张表可以作为速查参考:判断一份数据该放哪里,只需问一句——下次运行还需要它吗? 需要就放静态数据,不需要就走执行数据。
实战中如何选择
在真实工作流设计里,两者往往协同工作。一个增量同步流程可能长这样:
- 从工作流静态数据中读取上次同步的时间戳。
- 用该时间戳向 API 发起增量请求(执行数据承载响应)。
- 对返回记录做转换、过滤、写入目标库(全程走执行数据)。
- 把本次同步的最新时间戳写回静态数据,供下次使用。
这里第 1 步和第 4 步操作的是静态数据,中间的 2、3 步全是执行数据。清晰的分工让流程既不会重复处理,也不会丢失进度。
反过来,如果你的流程是无状态的——比如每次收到 webhook 就独立处理一条消息、不需要记住历史——那完全可以只用执行数据,不必引入静态数据增加复杂度。
常见误区提醒
- 把静态数据当缓存用:静态数据适合存少量状态标记,不适合塞入大批量业务数据,否则会拖慢工作流并难以维护。
- 忘记更新游标:读取了静态数据却没在成功后写回,断点续跑就失效了。
- 依赖执行数据做持久化:这是最典型的错误,尤其在定时触发类工作流中。
- 忽略并发场景:多个执行同时读写同一份静态数据时,可能产生竞争,需要评估是否加锁或改用外部存储。
掌握这两种数据的边界,是写出可靠 n8n 工作流的基本功。记住那个比喻——持久笔记本与草稿纸,选择时就不会犹豫。
并发竞争问题在 n8n 中比表面看来更复杂。由于静态数据的读写并非原子操作,如果两个执行几乎同时读取同一个游标值、各自处理后分别写回,后写入的会覆盖先写入的,导致一条执行进度丢失。缓解思路包括:在流程中串行化对同一工作流的触发(例如使用队列机制)、或将状态迁移到支持原子操作的外部存储。此外,如果工作流非常频繁地触发(比如每分钟多次),静态数据的频繁读写也会增加数据库负担,此时应评估是否改用更专业的缓存或状态服务。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。