n8n工作流平台深度解析:核心能力与国内适用性评估

什么是n8n?不只是AI工具
提到n8n,很多人第一反应会将它与AI工作流画等号,但这其实是一个常见的误解。n8n本质上是一个通用的低代码工作流自动化平台,它可以支持各种各样的工作流场景——数据清洗、网页爬取、内容发布、消息推送等等,这些场景与AI没有任何关系。
所谓低代码(Low-Code)平台,是一种通过可视化界面和最少手写代码来构建应用程序的开发方式。工作流自动化则是指将重复性的业务流程通过软件系统自动执行,减少人工干预。n8n将这两个概念结合,用户通过拖拽节点、连接数据流的方式来定义自动化逻辑,而无需编写大量代码。这类平台的兴起源于企业数字化转型中对效率的追求——据Gartner预测,到2025年70%的新应用将使用低代码/无代码技术开发。n8n采用Apache 2.0许可证开源,支持自托管部署,这使得它在数据隐私和定制化方面具有显著优势。与纯SaaS模式的自动化工具不同,自托管意味着所有数据流转都在用户自己的服务器上完成,不经过第三方平台,这对于金融、医疗等对数据合规要求严格的行业尤为重要。
当然,n8n同样可以与AI进行深度集成,帮助你构建AI Agent、RAG应用等智能化工作流。但理解它的定位非常重要:n8n是一个基础设施级别的工作流平台,AI只是它众多能力中的一个方向。
n8n的三大核心特点
强大的集成能力:500+节点生态
n8n的工作流由一个个"节点"组成,每个节点负责不同的功能。比如某个节点负责向视频网站发布视频,某个节点负责从网页爬取数据,某个节点负责从新闻网站获取资讯。
n8n的节点架构本质上是一种iPaaS(集成平台即服务,Integration Platform as a Service)设计模式。iPaaS是云计算时代兴起的一种中间件概念,旨在解决不同SaaS应用之间的数据孤岛问题。每个节点封装了对特定服务API的调用逻辑,包括认证(如OAuth 2.0授权流程)、数据格式转换和错误处理。这种设计让用户无需了解底层API的技术细节即可完成集成。与Zapier、Make(原Integromat)等同类商业产品相比,n8n的差异化在于其开源特性和自托管能力——Zapier按任务执行次数收费,高频使用场景下成本可能迅速攀升,而自托管的n8n则没有这一限制。节点之间通过JSON格式的数据流进行通信,每个节点接收上游数据、处理后传递给下游,形成有向无环图(DAG)结构的工作流。DAG是一种在数据工程领域广泛使用的执行模型,Apache Airflow等知名数据编排工具也采用了类似架构,它确保了工作流的执行顺序明确且不会出现死循环。
目前n8n支持的节点数量至少在500个以上,部分统计甚至认为已超过1000个。相比之下,我们日常使用的Dify或Coze等平台,即便算上社区开发的插件,节点丰富度也很难与n8n相提并论。这种庞大的节点生态,意味着n8n几乎可以对接你能想到的大部分主流服务和平台。值得一提的是,n8n还支持社区节点(Community Nodes)机制,开发者可以通过npm包的形式发布自定义节点,其他用户可以一键安装使用,这种开放的生态模式进一步扩展了n8n的集成边界。
高度灵活可控:复杂业务逻辑的承载者
在构建工作流的过程中,n8n提供了极高的定制自由度。你可以通过各种逻辑节点来组合出复杂的业务流程:
- 分支节点:根据条件走不同的处理路径(类似编程中的if-else逻辑,支持多条件组合判断)
- 循环节点:对批量数据进行迭代处理(例如遍历一个包含1000条记录的列表,逐条执行操作)
- 错误处理:当某个环节出错时的容错机制(支持重试策略、错误分支路由和告警通知,确保工作流不会因单点故障而完全中断)
- 数据转换:在不同格式之间灵活转换数据(支持JSON、XML、CSV等格式互转,还内置了JavaScript/Python代码节点,允许用户编写自定义转换逻辑)
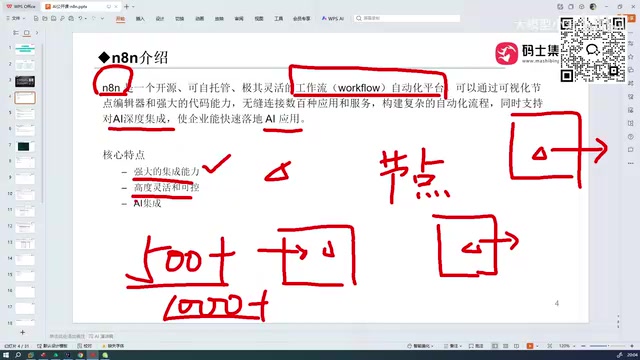
这种灵活性使得单个n8n工作流就能承载非常复杂的业务场景,各种节点可以自由组合来服务你的具体需求。在实际企业应用中,一个成熟的n8n工作流可能包含数十甚至上百个节点,处理包括数据采集、清洗、转换、存储、通知在内的完整业务链路。n8n还支持子工作流(Sub-workflow)调用,允许将常用的流程封装为可复用的模块,这与软件工程中的函数封装思想一脉相承,大大提升了工作流的可维护性。
AI集成:Agent与RAG的构建能力
n8n的AI集成能力是当前最受关注的亮点。基于n8n,你可以构建:
- AI Agent:具备自主决策和工具调用能力的智能体
AI Agent(智能体)是指能够感知环境、自主决策并采取行动的AI系统,它代表了从"AI作为工具"到"AI作为协作者"的范式转变。在n8n中构建AI Agent,核心机制是ReAct(Reasoning and Acting)框架——大语言模型先进行推理思考(Reasoning),然后决定调用哪个工具(Acting,即n8n中的其他节点),再根据工具返回的结果进行观察(Observation)并继续推理,形成思考-行动-观察的循环。这意味着AI不再只是被动回答问题,而是能主动调用数据库查询、发送邮件、调用API等操作来完成复杂任务。例如,一个客服Agent可以先理解用户问题,然后自主决定查询订单数据库、检索退货政策文档,最终综合信息给出回答。n8n通过将LangChain框架集成到其节点系统中,实现了这种Agent能力的可视化编排。LangChain是目前最流行的LLM应用开发框架之一,它提供了链式调用、记忆管理、工具绑定等核心抽象,n8n将这些能力封装为可拖拽的节点,极大降低了Agent开发的门槛。
- RAG应用:结合检索增强生成技术的知识问答系统
RAG(Retrieval-Augmented Generation,检索增强生成)是解决大语言模型知识局限性的关键技术。大语言模型的训练数据存在时效性截止和领域知识缺失的问题,RAG通过引入外部知识源来弥补这一不足。其工作原理分为三步:首先将企业文档(PDF、Word、网页等)切分为小块(通常每块500-1000个token),并通过Embedding模型(如OpenAI的text-embedding-ada-002)将文本转换为高维向量,存储在向量数据库中——这些向量本质上是文本语义的数学表示,语义相近的文本在向量空间中距离更近;当用户提问时,系统先将问题同样转换为向量,然后通过相似度搜索(如余弦相似度)从向量数据库中检索最相关的文档片段;最后将检索到的内容作为上下文(Context)与用户问题一起送入LLM生成回答。这样LLM就能基于最新的、特定领域的知识来回答问题,而非仅依赖训练数据。n8n支持对接Pinecone、Qdrant、Supabase、Weaviate、Chroma等主流向量数据库,配合文档加载器(支持PDF、Google Drive、Notion等数据源)和文本分割节点(支持按字符数、递归分割等策略),可以完整构建从文档摄入到智能问答的RAG流水线。
这也是n8n近两年持续火热的核心原因——它将传统的工作流自动化与AI能力无缝融合,让非开发者也能零代码构建AI应用。在GitHub上,n8n的Star数已超过5万,其AI相关模板的使用量在2024年增长了数倍,反映出市场对"AI+自动化"组合方案的强烈需求。
n8n在国内的适用性:不可忽视的局限
尽管n8n功能强大,但在国内企业中的实际采用率却并不高。这背后有一个关键原因:n8n是一个国外平台,其节点生态主要服务于海外应用场景。
节点生态的"水土不服"
具体来说,n8n的500+节点中,绑定的大多是海外主流服务:
| 功能场景 | n8n支持(海外) | n8n支持(国内) |
|---|---|---|
| 视频发布 | YouTube ✅ | B站/抖音 ❌ |
| 即时通讯 | Telegram、Slack ✅ | 微信/钉钉 ❌ |
| 在线表格 | Google Sheets、Airtable ✅ | 飞书表格/腾讯文档 ❌ |
| 数据库 | PostgreSQL、MySQL ✅ | 达梦数据库 ❌ |
| 社交媒体 | Instagram、Twitter ✅ | 微博/小红书 ❌ |

可以看到,n8n原生支持YouTube发布视频、向Telegram发送消息、将数据写入Google Sheets或Airtable等在线表格,但对于国内的微博、微信、飞书表格、达梦数据库等服务,完全没有对应的原生节点支持。
这种现象并非n8n独有,而是整个海外开源工具生态的共性问题。中国互联网形成了独特的应用生态——微信而非WhatsApp、支付宝而非PayPal、飞书而非Slack——这些平台的API体系、认证机制和数据规范都与海外服务存在显著差异。此外,部分国内平台的开放API能力本身就相对有限,或者对第三方接入设置了较高的门槛(如微信公众号API需要企业认证),这进一步增加了集成难度。

国内用户该如何应对?
对于国内用户来说,n8n的节点生态需要经过大量"过滤"。那些与海外平台深度绑定的集成节点,在国内场景下基本无法直接使用。如果你的业务主要围绕国内生态展开,n8n的集成优势会大打折扣。
不过,这并不意味着n8n在国内完全无用。以下场景仍然值得考虑:
- AI工作流构建:n8n的AI Agent和RAG能力与地域无关,调用OpenAI、Claude等API不受节点生态限制。即使考虑到网络访问问题,也可以通过对接国内大模型API(如通义千问广告、文心一言、智谱GLM等)来实现,n8n的HTTP Request节点或自定义节点可以轻松完成这些对接。
- 通用数据处理:数据清洗、格式转换、API调用等通用能力不依赖特定平台。n8n内置的Code节点支持JavaScript和Python,可以处理几乎任何数据转换需求。
- 自建HTTP节点:通过HTTP Request节点手动对接国内服务的API,虽然需要额外配置,但技术上可行
HTTP Request节点是n8n中最通用的集成方式,它允许用户直接构造HTTP请求来调用任何提供REST API的服务。用户可以自定义请求方法(GET/POST/PUT/DELETE)、请求头(Headers)、请求体(Body)和认证方式(如Bearer Token、Basic Auth、API Key等)。对于国内服务,虽然没有原生节点的便利性(如OAuth自动认证、数据结构自动映射、友好的参数配置界面),但只要目标服务提供了开放API文档,就可以通过HTTP Request节点手动实现对接。例如,飞书提供了完善的开放平台API,通过HTTP Request节点配置正确的认证Token和请求格式,完全可以实现消息发送、文档读写等操作。这需要用户具备一定的API调用基础知识,包括理解JSON数据格式、HTTP协议和API认证机制(如Token、签名等)。对于需要复杂签名算法的API(如部分支付接口),还可能需要在Code节点中编写签名计算逻辑。
- 内部系统集成:企业内部的数据库、API服务等可以通过通用节点对接。n8n原生支持MySQL、PostgreSQL、MongoDB、Redis等主流数据库,这些在国内企业中同样广泛使用,因此内部数据系统的集成不受地域限制。
总结与选型建议
n8n作为一个低代码工作流平台,其核心价值在于将复杂的自动化流程可视化,降低了技术门槛。它的500+节点生态、灵活的逻辑编排能力以及AI集成特性,使其成为全球范围内最受欢迎的开源工作流工具之一。
但对于国内用户,需要理性看待:如果你的核心需求是构建AI Agent或处理通用数据任务,n8n依然是优秀的选择;如果你需要大量对接国内互联网平台和服务,可能需要结合其他国产低代码平台(如Dify、Coze)来互补使用。实际上,一种常见的混合架构是:用n8n作为核心编排引擎处理AI逻辑和数据流转,同时通过Webhook或API与国产平台对接,各取所长。
在技术选型时,还需要考虑团队的技术能力和运维成本。n8n的自托管部署虽然带来了灵活性,但也意味着需要自行维护服务器、处理版本升级和保障系统稳定性。对于技术团队较小的企业,n8n Cloud(官方托管版本)或者选择国产替代方案可能是更务实的选择。
选择工具的关键不在于它有多强大,而在于它是否适配你的实际场景。
相关推荐
ChatGPT Space 发布:团队协作与 Pages 新功能解析
ChatGPT Space 是 OpenAI 推出的团队协作新功能,核心包含 Pages 页面、实时协作和 Slack/Google Drive 数据同步。本文解析其隐私设计、多平台集成与从对话到文档的完整工作流,帮助团队理解如何用 AI 统一项目管理与内容创作。

用AI Agent将Apache Spark UDF迁移到GPU加速
NVIDIA 开发者博客介绍如何用 AI Agent 将 Apache Spark UDF 重写为 GPU 加速版本,涵盖可迁移算子的判断标准、Agent 改写与验证流程,以及结果一致性、CPU-GPU 传输开销等落地陷阱。

Zed 编辑器 v0.40.4-rc2 发布:无需升级即可使用启动额度
Zed 编辑器发布 v0.40.4-rc2 候选版本,核心改动是允许用户在不升级付费计划的情况下使用启动额度(usage credits)调用 AI 功能,降低试用门槛。