n8n开源自动化挖矿:先挖再自动化

n8n 开源 Automation Mining Skill,让 AI Agent 先挖掘该自动化什么,再动手搭建。
n8n Labs 发布开源的 Automation Mining Skill,主张在自动化之前先找到值得自动化的环节。它是一份 AI 编程代理可直接读取的 Markdown 指令文件,基于 97.3 万行工作流数据构建分类体系,包含近 100 万个自动化模式。Agent 分析团队活动数据后按“频率 × 时间成本”为每个重复任务打分排序,输出按美元影响排列的自动化机会清单。n8n 自测显示任务召回率从 28.2% 提升至 51.7%,但数据来自 57 家合成公司,尚无第三方验证,且召回率天花板意味着仍会漏掉近半机会。Skill 采用只读设计,只观察、分析、提议,不触碰生产系统。文章还指出,自动化审计本身可包装成独立产品,先交付收据再谈构建。
大多数公司在自动化上搞错了顺序。他们花几周时间搭建一个花哨的工作流,每周省下40分钟。毫无价值。问题的核心在于:在动手自动化之前,你得先知道该自动化什么。
n8n Labs 刚刚在开源社区投下一枚重磅炸弹,叫做 Automation Mining(自动化挖矿)。这不是又一个工作流模板,而是一个让 AI Agent 先"勘察"你团队日常工作、找出隐藏自动化金矿的智能技能。
什么是自动化挖矿?
Automation Mining 本质上是一个 Agent Skill——一个 Markdown 格式的指令文件,AI 编程代理(如 Claude Code、Codex、Cursor 等)可以直接读取并执行。
你把它指向团队的活动数据:客服工单、电子表格、聊天记录、邮件线程,任何你能提供的数据。然后它从中挖掘出没人注意到的重复性工作。
聪明之处在于:n8n Labs 构建了一个分类体系(Taxonomy),从 973,000 行工作流数据中提取出近 100万个自动化模式。当 Agent 分析你团队的日常工作时,它不是靠猜测,而是将看到的内容与这个庞大的数据集进行匹配。
区别在于:一个是"嗯,这看起来挺重复的",另一个是"这个确切模式在12,000个已知工作流中出现过"。前者是直觉,后者是证据。
Agent Skill 是什么? 在 AI 编程代理的语境中,Skill 并非传统意义上的插件或 API,而是一份用自然语言(通常是 Markdown)写成的结构化指令文件。代理读取它之后,就获得了一套特定的工作方法、判断标准和输出格式。它与提示词工程的关键区别在于:提示词是临时的、一次性的,而 Skill 是可复用、可版本管理、可共享的能力封装。Claude Code 的 Skill、OpenAI 的 Codex 以及 Cursor 的规则文件都属于这一类。正因为它是纯文本,所以跨平台、零依赖、易审计——你甚至能在 Git 里追踪它的每一次修改。
它如何工作?四个步骤
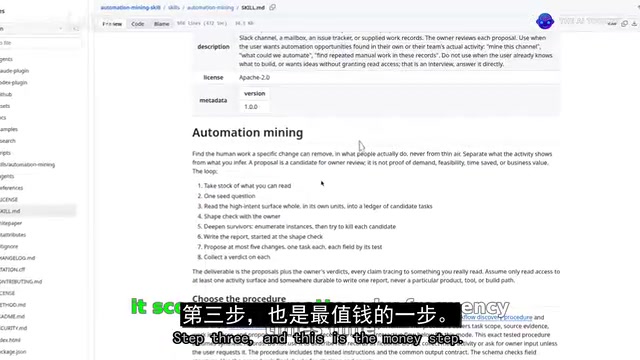
根据仓库中的 skill.md 文件(Apache 2.0 开源协议),整个流程分四步:
第一步:采集数据。 Agent 收集你团队每天做的原始工作数据。
第二步:分类匹配。 将活动对照分类体系进行归类——这是数据录入?审批链?排期?复制粘贴报表?
第三步(关键步骤):打分排序。 每个模式按照频率 × 时间成本进行评分。某件事多久发生一次?乘以它每次花多长时间。这实际上就是给每个重复性任务贴上了美元标签。
第四步:提出方案。 按影响力排序,最大的金钱收益排最前面。没有争论,没有办公室政治,只有数学。
因为只是一个文件,任何支持 Skill 的 Agent 都能直接使用。不需要新软件、不需要订阅、不需要销售电话。
为什么频率 × 时间成本是有效的排序函数? 这是经典的优先级矩阵思想在自动化领域的落地。单独看频率,会高估那些高频但每次只花几秒的琐事;单独看耗时,又会高估那些低频却很费劲的一次性任务。两者相乘得到的是每周(或每月)总投入时间,再把人力时薪代入,就换算成了可量化的金钱损失。这个做法的价值不在于公式有多精确,而在于它把主观的“这件事挺烦的”转化成客观的“这件事每月烧掉 3200 美元”,让资源分配从争论变成排序。
实测数据:结构碾压直觉
n8n Labs 用 57家合成公司(带真实混乱数据的假企业)进行了测试,对比了"有 Skill 的 Agent"和"没有 Skill 的基线 Agent":
| 指标 | 基线 Agent | 使用 Skill | 提升 |
|---|---|---|---|
| 任务召回率 | 28.2% | 51.7% | 接近翻倍 |
| 提案质量 | 44.7% | 53% | +8.3个百分点 |
召回率指的是 Agent 实际发现的真实自动化机会占比。从 28.2% 提升到 51.7%,几乎翻倍。
结构化的分类体系赋予了 Agent 明确的判断框架,效果显著优于让 Agent 自由发挥。
但必须公平地说:这些数字来自 n8n 自己的合成数据测试,目前还没有第三方独立验证。方向是对的,但需要保持审慎。
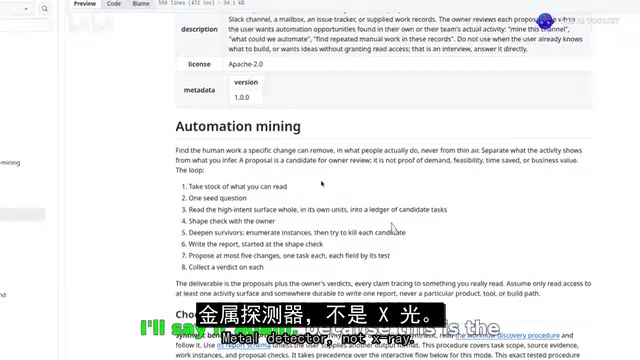
而且,51.7% 的召回率也意味着它遗漏了近一半的机会。这不是 X 光机,而是金属探测器——非常有用,但你仍然需要一个懂业务的人拿着它在田野里走。
召回率(Recall)在这里意味着什么? 召回率原本是信息检索和机器学习的评估指标,指系统正确找出的相关项目占全部真实相关项目的比例。用在自动化挖矿场景中,就是把“团队实际存在的所有可自动化机会”视为全集,Agent 成功识别出的那部分除以全集,即为召回率。它和“精确率”是一对:召回率关心有没有漏掉,精确率关心找出来的对不对。文章只报告了召回率翻倍到 51.7%,但没有给出精确率数据,这意味着我们不知道被识别出的机会里有多少是误报——这也是评估这类工具时需要额外追问的地方。
为什么只读设计值得尊重
一个让人敬佩的设计选择:这个 Skill 是只读的。
它不发布任何内容,不编辑任何东西,不碰你的系统。它只观察、分析、提议。仅此而已。
你不希望一个实验性的 Skill 对生产数据拥有写入权限。先观察,后行动,人在回路中。 更多 AI 工具应该这样设计。
被忽视的商业价值
自动化销售中最难的部分从来不是构建工作流,而是搞清楚该构建什么。
代理商光是搭建一个自动化就要收 $1,000 到 $2,500。但发现阶段——流程审计——那是另外一笔费用。顾问们为需要数周访谈和电子表格的审计收取高额费用。
现在换个思路。你带着一份今天早上刚生成的报告走进客户会议。他们公司每一个重复性流程,按美元影响排序。"你们团队每月在手动发票匹配上损失40小时。这是解决方案,这是投资回报周期。"
这不再是一份推销,而是一张收据。试着对一张收据说不。
审计本身就是一个产品。48小时交付的自动化审计,每个机会按美元影响排序。构建成为追加销售,审计是敲门砖。
先把这份收据交给自己。大多数创始人每周有5到10小时的重复工作,他们已经看不见了——因为每天都做的事会变得隐形。
流程审计为什么昂贵? 传统的自动化发现阶段通常依赖顾问访谈、现场观察和手工梳理流程文档,一个中型企业的审计动辄需要数周,收费从几千到数万美元不等。高昂的原因不是技术难度,而是信息采集的摩擦成本:流程散落在不同部门、员工自己也说不清每天到底做了多少重复动作。Automation Mining 的思路是把这部分采集与分析工作交给 Agent,把数周的访谈压缩到数小时的数据分析,从而把审计从一项定制服务变成一种标准化、可批量交付的产品。这正是 SaaS 化咨询的典型路径——把人力密集的专家服务转化为边际成本极低的软件交付。
四个要命的局限
第一,合成数据的局限。 真实公司更混乱——办公室政治、奇怪的特例、"我们周二的做法不一样"。真实世界的召回率会更低,可能低很多。把实验室数据当作上限,不是下限。
第二,召回率天花板。 即使在 n8n 自己的测试中,召回率最高也只有51.7%。在专门为它设计的数据上,它漏掉了一半的机会。管理好你的预期。
第三,只读既是特性也是限制。 它提议,你构建。如果你不会搭建 n8n 工作流,一份漂亮的排序列表只是一张愿望清单。
第四,太新了。 这周才发布,预期会有粗糙的边缘、文档缺失、奇怪的行为。早期采用者拿到优势,也拿到 Bug。
行动建议
这周就做一件事:写下你团队每周做超过3次的所有任务。纸笔就行。
然后问自己:哪些是 Agent 五分钟内就能发现的?恭喜,那就是你的自动化待办清单,按痛苦程度排序。
Automation Mining Skill 是免费的、开源的(Apache 2.0),仓库地址在 GitHub 上(n8n-io-automation-mining-skill)。
最后一句值得记住:在自动化之前,先找到钱的所在。 这句话本身就是一种商业模式。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。