n8n实战:构建可信的AI销售线索挖掘与外联自动化系统
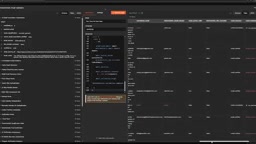
用n8n三段式工作流实现AI辅助销售线索挖掘,以确定性规则和人工审批将AI幻觉挡在关键决策之外。
本文介绍了开发者Daniel Sarsha构建的一套基于n8n的销售线索情报与外联自动化系统,以香港私立医生为目标线索群体。系统由三个独立工作流构成:第一个负责通过Tavily搜索公开来源并由AI提取有据可查的医生数据;第二个是核心信任层,对身份、专科、地理位置、执业资格等维度逐一确定性校验,证据冲突时触发二次研究,邮箱发现全程拒绝猜测;第三个在生成个性化外联草稿后,强制推送至Slack等待人工审批,批准后才执行发送并写入审计日志。整套系统的设计哲学是:AI只负责研究和起草这类需要灵活性的低风险工作,资格判定、质量闸门和最终发送决策则由确定性规则与人工审批牢牢把控,从架构层面将模型幻觉隔离在高风险决策之外。
AI在销售线索挖掘中最大的风险不是效率不够,而是可信度不足——模型幻觉出的假邮箱、虚构的职称、重复触达的客户,都会让自动化系统反而制造麻烦。开发者Daniel Sarsha在YouTube上分享的这套基于n8n的线索情报与外联自动化系统,给出了一个值得借鉴的工程化答案:用确定性规则和人工审批为AI划定边界。
这套系统以香港私立医生为目标线索,由三个独立工作流组成,分别负责发现、验证与外联。整个设计的核心思路,是把AI擅长的「研究与起草」和AI不该独自决定的「高风险判断」严格分开。
工作流一:线索发现与数据提取
第一个工作流承担的是线索发现任务。它接收一个研究请求后,会自动生成有针对性的搜索查询,通过Tavily搜索公开网络来源,筛选出相关页面,再用AI提取有来源支撑的医生数据。
关键细节在于「来源支撑」四个字。提取出的记录会经过标准化处理,去除完全重复的条目,最后把候选线索存入PostgreSQL数据库。这一阶段AI的角色是信息抽取,而非凭空生成——所有数据都需要能追溯到公开来源,这为后续的信任层打下基础。
Tavily是专为AI Agent设计的搜索API,与通用搜索引擎不同,它会直接返回经过提炼的结构化内容,而非原始网页链接列表,因此特别适合在自动化工作流中作为信息采集的基础层。在这套系统里,Tavily承担的是「可控爬取」的角色:由AI生成搜索查询,Tavily执行并返回有据可查的来源页面,再交由AI从中抽取具体字段。这与让AI直接「回忆」或「推断」联系人信息有本质区别——前者每一条数据都有明确的来源URL可以追溯,后者则极易产生幻觉式输出,例如凭借常见命名规律猜测出看似合理却实际不存在的邮箱地址。
工作流二:信任层与去重验证
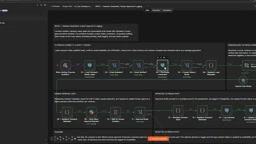
第二个工作流是整套系统的信任核心。每一条候选线索都会被独立验证多个维度:医生身份、专科领域、是否位于香港、是否属于合格的私立服务提供方,以及当前的执业状态。
这里的设计哲学很值得玩味。对于证据不确定或存在冲突的记录,系统不会盲目接受,而是把它们路由到第二轮研究流程重新核查。Daniel明确指出:「AI帮助解读证据,但最终的资格判定是确定性的(deterministic)。」这一句话点出了整个系统的灵魂——AI的输出不会自动进入最终线索库,必须通过规则校验这道闸门。
去重处理也做得相当细致。系统先标准化医生姓名和服务提供方名称,移除完全匹配的重复项,再进一步比对可能的别名。这样就能处理「同一位医生以略有差异的名字出现」或「在多个网站重复出现」的棘手情况。
邮箱发现同样坚持证据导向。工作流从不猜测邮箱地址,而是检查该邮箱是否公开关联到这位医生,验证语法格式,用确定性规则排除HKU(香港大学)相关域名,并检测重复邮箱。
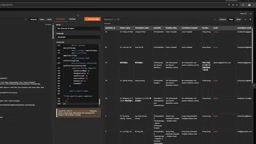
在数据入库前,系统设置了一组最终质量闸门,综合医生验证、提供方资格、去重、邮箱校验、已有数据库检查以及外联历史。只有全部通过规则的线索,才会被标记为合格线索存储。
「确定性规则」(deterministic rules)与AI推断之间的区别,是理解这套系统架构的关键。AI模型的输出本质上是概率性的——同样的输入在不同运行中可能产生不同结果,且模型无法保证事实准确性。相比之下,确定性规则是硬编码的逻辑判断:邮箱格式是否合法、域名是否在排除列表内、数据库中是否已存在相同记录——这些判断每次运行都会得到完全一致的结果,不受模型状态影响。将两者结合使用的设计思路,是将AI限定在「解读证据、归纳信息」的角色上,而将「是否准入线索库」这类具有下游影响的决策,交给不会随机犯错的规则引擎来执行。这也是为什么系统能在保留AI灵活性的同时,对数据质量提供可预期的保障。
工作流三:人工审批的外联流程
第三个工作流处理实际的外联动作。它加载合格线索,确认邮箱可用且已验证,检查该线索此前是否已被联系过,然后仅基于已验证的线索数据生成个性化外联草稿。
AI会返回结构化的邮件主题、正文和「个性化依据」。同样有明确约束:不得编造成就、服务或任何无证据支撑的说法。这种对AI输出的硬性限制,是避免外联内容翻车的关键。
最具工程价值的一步在这里:任何草稿在发送前都会推送到Slack进行人工审核,工作流会在此暂停。审核者可以批准或拒绝这封邮件。在演示中,Daniel批准了一个示例。
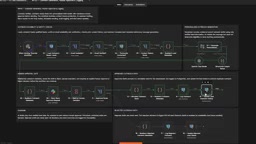
批准之后,原型会模拟发送动作,把完整的外联事件写入PostgreSQL,并更新线索状态。这样就形成了一条审计追踪记录,也防止了未来运行时对同一线索的重复触达。
将Slack作为人工审批的触点,是n8n「Human-in-the-Loop」模式的典型实现。n8n支持工作流在特定节点暂停执行并等待外部响应,审核者在Slack中点击批准或拒绝后,工作流才会继续向下推进。这种设计的工程价值在于:它把「人工把关」嵌入到自动化流程内部,而非依赖运营人员在系统外部手动检查结果再补充操作。对于外联邮件这类一旦发送就无法撤回的动作,在流程节点层面强制设置暂停点,比事后审计要有效得多。同时,所有审批记录和最终动作都会写入数据库,形成可追溯的操作日志,这对合规性要求较高的行业场景尤为重要。
最终产出与架构启示
存储在PostgreSQL中的最终合格线索,每条记录都包含医生姓名、专科、所属医院或诊所、地理位置、邮箱及验证状态、来源资料URL、最终线索状态,以及相关的验证备注。这是一份结构完整、可追溯的线索清单。
Daniel总结的核心技术决策是:将发现、验证和行动三个阶段彻底分离。AI负责研究和起草这类低风险、需要灵活性的工作,而确定性规则和人工审批则牢牢掌控高风险决策。
这套系统的价值不在于用了多酷炫的模型,而在于它展示了一种成熟的「AI工程观」——承认大模型会产生幻觉,于是用架构设计把幻觉挡在关键决策之外。对于任何想把AI落地到真实业务流程、尤其涉及对外沟通的团队来说,这种「AI辅助、规则兜底、人工把关」的分层思路,比单纯追求全自动更值得参考。
相关推荐
WorkBuddy 保姆级教程:AI Agent 批量处理文件实战
WorkBuddy 保姆级教程实战:对比豆包等大模型,演示 AI Agent 如何自动完成 Word 批量转 PDF、文件归档等任务,含积分消耗、授权操作和使用场景分析。

Codex保姆级攻略:从安装到多任务并行实战
Codex保姆级使用攻略:从下载安装、账号登录到项目权限、多任务并行、插件技能和Agents MD配置,结合实战演示,帮助零基础用户快速上手OpenAI的AI Agent工具。

零基础学软件测试:四大维度分析与27阶段学习路线
零基础如何入行软件测试?本文从薪资、岗位需求、学历门槛、发展前景四个维度分析软件测试岗位现状,并梳理包含Python、自动化测试、AI测试等27个阶段的完整学习路线,适合转行者和初学者参考。