n8n自动化:会议记录10秒变跟进草稿,零邮件发送的AI工作流
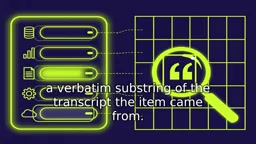
n8n八步工作流将会议转录10秒内转为带证据引用的Gmail跟进草稿,架构上无法发送邮件。
本文介绍了一个基于n8n的AI自动化工作流,能在会议转录落地后10秒内生成带负责人、截止日期和证据引用的Gmail跟进草稿,且整个流程不含发送节点,从架构上杜绝了误发邮件。工作流通过五字段结构(负责人、任务、截止日期、置信度、证据引用)强制模型输出可验证的动作项,并利用接地检查确保证据引用与转录原文精确匹配,否则转入人工审核。文章通过失败案例展示了该设计如何拦截错误归属,并强调了“安静猜错比没有自动化更糟”的设计哲学,最终主张自动化应限于捕获工作,而将决定权保留给人类。
n8n自动化:会议记录10秒变跟进草稿,零邮件发送的AI工作流
会议刚结束,标签页还没关,三封跟进草稿已经躺在Gmail里——每封都带负责人、截止日期和证据引用。这是n8n工作流在转录文本落地后10秒内完成的动作。最值得注意的设计不是速度,而是它从架构上就无法发送邮件:整个流程里根本没有"发送"节点。
会议动作项为何总在"蒸发"
视频作者引用艾宾浩斯遗忘曲线的通俗版本:一小时内过半新信息流失,口头指令到第二天基本消失。但真正的问题不在于忘记会议内容,而在于动作项以四种可预测的方式死亡:
- 没有真实负责人——"应该有人去更新文档"
- 没有真实日期——"尽快"
- 没有终态——只有"跟进一下"
- 责任分裂——一行写两个名字,等于没人负责
作者展示了一张旧任务表,上面是"待办、跟进、三个问号"的坟场。他的结论是:解法不是更好的笔记应用,而是给每个动作项一个更严格的形状。
五字段结构:让模型无法"编造"
每个动作项必须包含五个字段:负责人(转录中明确提及或为空,绝不猜测)、任务(动词开头且具体)、截止日期(真实日历日期)、置信度(0到1)、以及证据引用——转录文本的逐字子串。如果模型无法指出它读到的原句,该项就不交付。
表格固定七列:会议ID、负责人、任务、截止日期、置信度、证据引用、状态(已起草/需审核)。这个证据引用是整个系统的安全阀,后文会看到它如何拦截一次典型的错误归属。
八步工作流拆解
工作流共八个节点:
- Webhook触发器接收JSON格式转录(会议ID、日期、参与者、文本)。若源是音频,则用Google Drive触发器+HTTP请求节点调用Whisper转写。设计中没有会议机器人加入通话。
- 代码节点清洗文本:剥离时间戳、固定会议日期(供后续解析"下周五")、按会议ID去重防止重复处理。
- 提取节点:LangChain agent配合结构化输出解析器,模型返回符合schema的JSON而非散文。系统提示词强调"只提取明确陈述的内容,绝不编造负责人或日期"。
- 接地检查:另一个代码节点将每条证据引用与转录原文精确匹配。不匹配则重试一次,仍失败进入人工审核队列;同时解析相对日期,负责人为空时置信度封顶0.5。
- 路由:If节点分流——置信度低于0.6、缺负责人或缺日期进入"需审核",干净项进入"已起草"。
- 每项一行写入表格。
- Gmail节点仅为每位负责人创建一封草稿,列出其动作项与截止日期(操作类型:创建草稿)。
- Telegram提醒:"今天站会的三个动作项已在你的Gmail草稿中,请审核并发送。"
八步,零封可发送邮件。作者强调这是结构性的,不是承诺。
LangChain agent与结构化输出解析器:LangChain 是一个用于构建大语言模型(LLM)应用的开源框架,其 Agent 组件能让模型在推理过程中调用工具或按特定逻辑执行任务。而结构化输出解析器(Structured Output Parser)的作用是强制模型返回符合预定义 JSON Schema 的数据,而不是自由文本。在本工作流中,提取节点正是利用这一机制,让模型输出包含负责人、任务、截止日期、置信度和证据引用的 JSON 对象,从而便于后续节点进行程序化校验和处理。
Webhook 触发器:Webhook 是一种基于 HTTP 回调的轻量级集成方式。当外部系统(如会议转录服务)向 n8n 暴露的特定 URL 发送 POST 请求时,Webhook 触发器节点会立即启动工作流,并将请求体(此处为 JSON 格式的转录数据)作为输入传递给后续节点。这种方式无需轮询,实现了事件驱动的实时处理,是“转录落地后 10 秒内完成”的速度基础。
接地检查(Grounding Check):在 AI 领域,“接地”指模型输出必须与给定的源文本或现实世界事实保持可验证的一致性。本工作流中的接地检查是一个代码节点,它将模型生成的每条证据引用与原始转录文本进行精确字符串匹配。如果引用不是原文的逐字子串,则视为“未接地”,系统会触发重试或转入人工审核。这一机制是防止模型幻觉(hallucination)的关键安全阀,确保每个动作项都有据可查。
用失败案例证明设计
视频用一段合成对话展示真实失败模式:Ava问"Ben说他处理部署,对吧?"Ben纠正:"不,我说的是我审核,Kara在处理部署。"朴素提取器会把部署错误分配给Ben,且多数工作流会让这个错误直接进收件箱。
在这个工作流中,证据引用暴露了负责人来自Ava的疑问句而非Ben的纠正,置信度骤降,该项落入需审核。其余边界情况同样处理:"应该有人更新入职文档"返回负责人为空且置信度封顶;"下周五"按会议日期解析,无法解析则日期留空并标记;"Ava和Ben处理预发布服务器"拆成两行,各一个负责人——因为一行两个名字等于没人负责。
作者的判断标准很明确:安静猜错的自动化比没有自动化更糟,所以这个系统被设计成"大声地不确定"。
两个诚实的注意事项
作者在结尾给出两点提醒:n8n版本间会重命名节点和操作,导入后需核对标签;超长转录可能超出模型上下文窗口,分块是另一期的话题。
另一个更严格的变体"发送并等待批准"会暂停整个执行直到人工点击批准,但作者仅在第三方教程中见过,官方文档未提及,因此他坚持仅创建草稿的设计。
模型上下文窗口:上下文窗口是指大语言模型单次处理所能接收的最大 token 数量(包括输入和输出)。超长会议转录可能超出这一限制,导致模型无法看到完整文本,从而遗漏信息或产生错误。常见的应对策略是将长文本分块(chunking),分别提取后再合并结果。作者将分块方案留待后续讨论,也提示了当前工作流在处理超长会议时的局限性。
适用边界与判断
这套方案的价值不在于技术复杂度——八个节点、无自定义模型、无外部API编排——而在于把自动化限制在"捕获工作"而非"做决定"。它解决的是会议动作项蒸发的问题,代价是每条都需人工过目。对于高频站会、跨团队协作的团队,这种"草稿+提醒+证据链"的组合比全自动发送更可能被长期使用。反过来,如果团队连草稿都不愿审核,说明问题不在工具层。
作者的收尾规则值得抄下来:自动化无聊的部分,保留人类的部分。系统捕获工作,你仍做每一个决定。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。