南北阁发布33B开源Agentic编程模型:512K上下文

南北阁发布33B稠密编程Agent模型,512K上下文,Apache 2.0开源
南北阁LLM实验室发布Nanbeige4.3-33B,一款面向Agentic Coding的33B稠密模型,采用Apache 2.0协议,支持512K上下文,官方报告在Terminal-Bench 2.1上得分80.9。文章分析其选择33B稠密架构的原因:既能承载较长推理链,又保持可控部署成本。512K上下文可减少Agent在长仓库任务中的遗忘问题,Apache 2.0则降低了商用与私有化部署的合规门槛。该模型还将用于蒸馏指导即将推出的Nanbeige4.3-3B小模型。文章同时提醒,基准成绩为官方自报,第三方复现、长上下文实际利用率与推理成本仍待验证。
开源大模型赛道又多了一位专注编程Agent的选手。南北阁LLM实验室发布Nanbeige4.3-33B,一款33B稠密模型,采用Apache 2.0协议,上下文长度512K,在Terminal-Bench 2.1上报告得分80.9,并将用于指导即将推出的Nanbeige4.3-3B小模型。
33B稠密模型,为何瞄准Agentic Coding
Agentic Coding指的是模型不只是补全代码,而是能在终端环境中自主执行任务、读取报错、迭代修改。这类能力对模型的推理链路和上下文记忆要求很高。33B稠密架构介于轻量微调模型与超大MoE之间,既能承载较长的推理链,又保留了相对可控的部署成本,这也解释了Nanbeige选择这一尺寸切入编程Agent场景的意图。
稠密模型与MoE架构的区别
文章提到“33B稠密架构介于轻量微调模型与超大MoE之间”,这里的稠密(Dense)指模型每次前向推理都会激活全部参数,与之相对的是混合专家(MoE)架构。MoE通过门控网络为每个token只激活部分专家,从而在总参数量很大的情况下控制单次计算量,例如总参数量数百B但激活参数仅几十B。稠密模型的优势在于推理路径确定、显存占用与参数量基本线性对应、部署和量化相对简单,缺点是同等算力下参数规模难以堆到MoE的水平。33B稠密意味着推理时全部33B参数参与计算,对单卡或双卡部署较为友好,同时保留了足以支撑多步推理链的容量,这正是编程Agent场景在能力与成本之间的一种折中。
512K上下文与80.9的Terminal-Bench成绩
512K上下文是这款模型最直接的产品卖点。在Agentic编程任务中,模型需要反复读取仓库文件、终端输出和历史修改记录,上下文越长,越能减少“遗忘前文、重复犯错”的情况。Terminal-Bench 2.1是一项衡量终端环境任务完成度的基准,80.9的得分说明该模型在连续操作类编程任务上具备较强表现。
Terminal-Bench是什么
Terminal-Bench是一类面向终端(命令行)环境的Agent评测基准,任务通常要求模型在真实shell中完成诸如配置环境、修复构建错误、操作文件系统等多步骤工作,评判标准是任务最终状态是否正确而非代码片段相似度。它考察的是模型的工具调用、错误诊断、命令执行与自我纠错能力,与单纯的代码补全基准(如HumanEval)有本质区别。版本号2.1代表该基准的迭代版本,任务集和评分细则会随之调整,因此跨版本分数不宜直接横向比较。理解这一点有助于判断80.9这个数字的含义:它反映的是模型在连续终端操作类任务上的完成率,而非通用编程能力。
Apache 2.0协议:商业使用门槛较低
选择Apache 2.0而非自定义许可,降低了企业二次开发和私有化部署的合规成本。对希望把编程Agent嵌入内部工具链的团队来说,这一协议意味着可以直接修改、分发甚至商用,而不必逐案申请授权。这是该模型与部分“开放权重但限制商用”模型的重要区别。
Apache 2.0与“开放权重但限制商用”许可的差异
开源大模型常见的许可大致分三类:Apache 2.0、MIT等宽松许可,允许修改、分发和商用,通常只要求保留版权与许可声明;Llama社区许可、自定义许可等则附带用户规模、用途或再分发限制;还有一类仅开放权重而不开放训练数据与代码,常被称为“开放权重”而非严格意义的开源。Apache 2.0的关键在于它同时授予专利许可,降低了企业因专利纠纷产生的法律风险,且无需逐案申请授权。对于要把模型嵌入内部工具链或对外提供产品的团队,这一协议显著减少了合规审查成本,也是该模型在商用友好度上的主要卖点。
大模型教小模型:Nanbeige4.3-3B的蒸馏路径
官方提到Nanbeige4.3-33B将用于指导即将推出的Nanbeige4.3-3B。这实际上是一种知识蒸馏思路:用大模型的能力输出训练小模型,让小尺寸模型在特定任务上逼近大模型表现。若蒸馏有效,3B版本有望在端侧或低算力环境中承担编程Agent工作,进一步扩大该系列的适用面。
知识蒸馏的基本机制
知识蒸馏指用能力较强的大模型(教师模型)的输出或中间表示来训练小模型(学生模型),使学生模型在参数量远小于教师的情况下逼近其在特定任务上的表现。常见做法包括用教师生成的回答做监督微调,或对齐教师与学生输出的概率分布。蒸馏的效果高度依赖教师输出质量、任务覆盖面和数据配比,通常能让小模型在目标领域表现接近大模型,但泛化到未见过任务时差距会更明显。放到本文语境,33B模型指导3B模型,意味着3B版本可能在终端编程Agent任务上继承较强能力,从而适配端侧或低算力部署;但蒸馏模型的实际上限仍受学生模型容量约束,具体效果需等发布后的独立评测确认。
值得关注的现实问题
80.9的基准得分目前来自官方自报,第三方复现结果尚未出现,实际泛化能力仍需社区验证。512K上下文在真实长仓库场景下的有效利用率、推理延迟与显存开销,也会直接影响工程落地体验。此外,3B版本的具体发布时间和性能指标尚未公布,蒸馏效果有待观察。
对开发者而言,Nanbeige4.3-33B提供了一个Apache 2.0、长上下文、面向终端Agent的开源选项。是否值得接入,取决于后续的独立评测和实际任务表现。
相关推荐
Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。

Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。
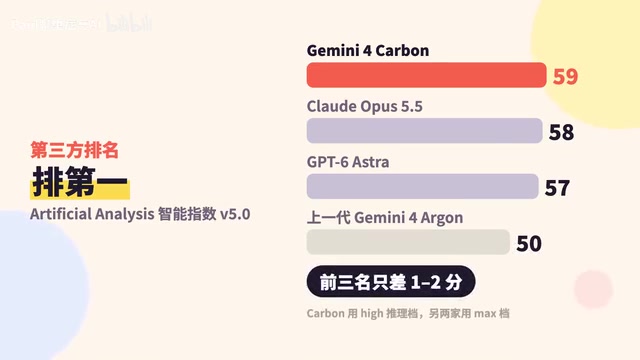
谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。