Nano Banana 2.1对决GPT Image 2.5:8组实测与真实成本

独立测试者用8组提示词、66次调用、4.36美元,实测Google Nano Banana 2.1与OpenAI GPT Image 2.5的真实成本与能力差异。
本文记录了一次可复现的AI图像生成模型横向评测:测试者Anass Kartit用相同的8组提示词对Google Nano Banana 2.1、Nano Banana 2、Nano Banana Pro以及OpenAI GPT Image 2.5(Flare/Sunburst两版)进行实测,核心价值在于披露了真实成本账单。反直觉的结论是:GPT Image 2.5在high档每张仅0.0326美元,比Nano Banana 2.1的0.0418美元更便宜,分辨率还更大。两家计费逻辑根本不同:Google按像素计费,OpenAI按细节精度计费。能力对比上OpenAI以3比2胜出,但最佳选择高度依赖任务类型——缩略图与真人摄影Google更强,产品图与换装编辑OpenAI更优。测试者明确指出方法论局限,建议读者按任务选型并用自己的提示词验证。
两大科技巨头的最新AI图像模型正面交锋:Google的Nano Banana 2.1与OpenAI的GPT Image 2.5。独立测试者Anass Kartit用相同的8组提示词,对这两款模型(外加Nano Banana 2、Nano Banana Pro以及GPT Image 2.5的Sunburst和Flare两个版本)进行了实测,每张图只取首次生成结果,并记录了每一次调用的成本与耗时。
这篇文章的价值不在于谁更"漂亮",而在于它用真金白银跑出了一份可复现的成本账单——总计66次调用、花费4.36美元,其中还包括12张作废的图片。
核心结论:谁更便宜?
一个反直觉的结果是:被寄予"半价"厚望的模型,并不是账单上最便宜的那个。
在各自的常规设置下,GPT Image 2.5在high质量档位每张仅0.0326美元,而Nano Banana 2.1每张0.0418美元,且GPT的输出分辨率(1536x864)还更大。价格对比如下:
| 模型 | 单张成本(1K/high) | 平均耗时 |
|---|---|---|
| GPT Image 2.5(high) | $0.0326 | Flare 16.9s / Sunburst 29.9s |
| Nano Banana 2.1 | $0.0418 | 15.0s |
| Nano Banana 2 | $0.0684 | 10.3s |
| Nano Banana Pro | $0.1389 | 17.2s |
这里有一个关键的方法论差异需要说明:Google的成本是"算出来的"而非"扣出来的"——测试者根据Gemini API返回的token计数乘以当时的刊例价推算;而OpenAI的成本则是OpenRouter实际扣费的usage.cost数值。换句话说,两列数字的来源并不完全对等,Google的推算还包含了"思考"(thinking)token的消耗。
以一张Nano Banana 2.1缩略图为例:54个输入token + 1085个文本与思考token + 1120个图像token,按百万token计价合计0.0418美元。其中纯图像token只占0.0336美元,剩下的都是"思考"开销。这也解释了为什么标称"图像token半价"的Nano Banana 2.1,整张图算下来只比Nano Banana 2便宜约39%,而非一半。
分辨率与质量档位如何影响价格?
两家模型的计费逻辑存在本质区别,这一点对实际成本控制至关重要。
Google按像素计费:Nano Banana 2.1从1K到4K,分辨率翻倍、价格也随之上涨($0.042 / $0.060 / $0.122),4K输出达到5504x3072。
OpenAI按细节计费:GPT Image 2.5在low到max的5个质量档位下,返回的文件尺寸始终是1536x864——你付费买的是细节精度,而不是像素数量。其价格跨度极大:low档低至$0.0039,max档则飙到$0.1297。
整个测试中最便宜的单张图是GPT Image 2.5的low档($0.0039),最贵的是Nano Banana Pro的4K档($0.2443)。还有一个有趣的细节:Nano Banana Pro在2K时竟比1K略便宜($0.1379 vs $0.1389),原因是这次调用它"想得少",消耗的思考token更少。
对于需要海量出图的场景,GPT Image 2.5的low档不到半美分的价格,可能是这次测试最大的惊喜。
理解这两种计费逻辑的差异,需要了解各自的底层设计哲学。Google的像素计费本质上是对计算资源的线性收费——生成4K图像需要处理的像素数约为1K的16倍,成本也随之阶梯式上涨。OpenAI的"细节档位"计费则对应模型在去噪扩散过程中的迭代步数或采样精度:low档以较少步数快速收敛,产出文件尺寸和细节量都较小;max档则在同等分辨率下投入更多计算以提升纹理细节、减少伪影。这意味着两家的成本控制策略截然不同:对Google用户而言,裁剪输出分辨率是最直接的降本手段;对OpenAI用户而言,在不需要高精度细节的场景(如草稿预览、批量缩略图)选用low档,可将每张成本压低至high档的十分之一以下。
8组实测:谁赢了哪一局?
最终比分是OpenAI 3比2领先,另有3局平局无得分。但正如测试者反复强调的,最佳模型取决于任务类型,而非这个记分牌。
Google胜出的两局
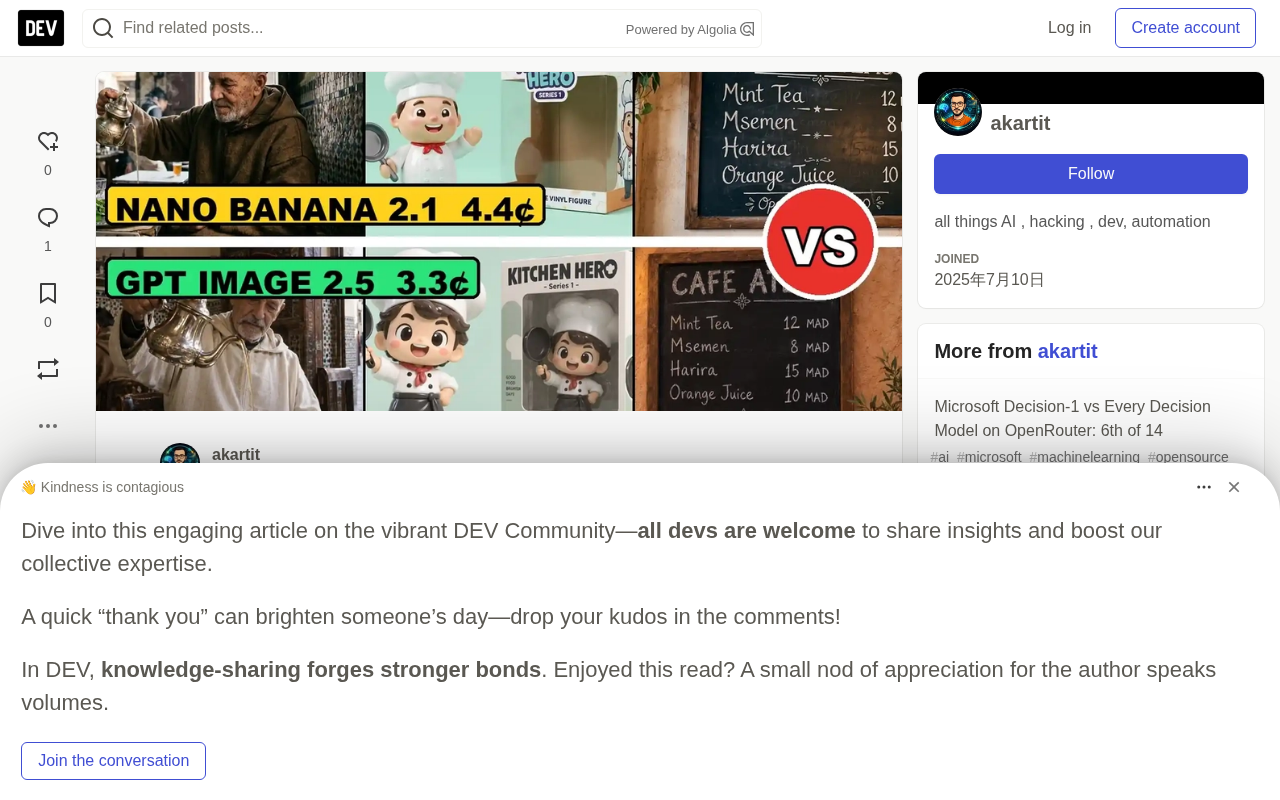
真人纪实照:Google的三款模型都呈现出带皱纹、柔和窗光的胶片质感,像真实的35mm相机作品。而GPT Image 2.5两个版本都更亮,并且"自作主张"给老人戴上了一顶红色费斯帽——这是提示词里从未要求的。
YouTube缩略图:五款模型都正确拼写出了"HALF PRICE?"和"$0.03"。但Flare在笔记本上画出了真实的公司logo(缩略图中并不想要),Nano Banana 2则擅自加了价格。Nano Banana 2.1最干净利落,手机上清晰可读,成本仅4美分。
OpenAI胜出的三局
塑料玩具:Nano Banana 2.1把包装盒画成了空的,而GPT Image 2.5两个版本都把发亮的厨师公仔放进了盒子里,像真实货架上的玩具。
学校海报:拼写上五款都没错,但Nano Banana 2把海报画成了宽幅画面中央的窄条,Sunburst则充满整个画幅、精确写出4个步骤。
换装编辑:Sunburst的奶油白西装更逼真,带圆角披肩领和口袋巾(6美分),Nano Banana 2.1用4美分完成但领型更简单。
两局平局
广告照和"修复老照片"均未分出胜负。尤其是修复任务暴露了双方的通病:Google保留了背景却把肤色改暗,OpenAI保住了肤色却重绘了全新的蓝色背景——两家都违反了"保持一切不变"的要求。文字书写方面,五款模型全部正确写出了5行粉笔菜单,Nano Banana 2.1甚至给"CAFE"加上了法语音符。
API调用方式速览
测试者公开了完整的调用方法,便于读者复现。
Nano Banana 2.1(Gemini API):一次generateContent调用,设置responseModalities: ["IMAGE"],图片以base64形式在inlineData中返回,token计数在usageMetadata里。imageSize支持1K/2K/4K,更换model id即可切换到Nano Banana 2(gemini-3.1-flash-image)或Pro(gemini-3-pro-image)。编辑图片时把参考图放在parts数组最前面即可。
GPT Image 2.5(OpenRouter):通过POST /api/v1/images调用,注意其chat completions端点在测试中拒绝了这些图像模型。quality支持low到max五档,编辑时通过input_references传入参考图(URL或base64,最多16张)。测试者提醒:首轮调用若不指定aspect_ratio,可能返回3:2而非预期的16:9——他为此作废重跑了12张图。
值得注意的是,两家API在编辑(图生图)模式下的工作机制也有所不同。Gemini API的编辑方式是将参考图与文字提示一同放入同一个parts数组,模型以多模态方式理解输入,本质上仍是一次generateContent请求,并不区分"生成"与"编辑"端点。GPT Image 2.5则通过独立的input_references字段传入参考图,支持URL或base64格式,最多16张,系统会将其理解为风格或内容参考而非严格的像素级修改底图。这一架构差异解释了为何两家在"修复老照片"任务中都难以做到"保持一切不变"——它们的编辑指令本质上都是带约束的重新生成,而非真正意义上的局部像素修补。
选型建议
按任务匹配,而非盯着记分牌:
| 需求 | 推荐 | 实测成本 |
|---|---|---|
| 带文字的YouTube缩略图 | Nano Banana 2.1 | $0.042(1K) |
| 逼真照片 | Nano Banana Pro | 约$0.14(1K) |
| 海量低成本出图 | GPT Image 2.5(low) | $0.0039 |
| 产品图/玩具/海报/换装编辑 | GPT Image 2.5 Flare(high) | $0.0326(编辑$0.061) |
如果选GPT Image 2.5,务必用Flare——与Sunburst每档同价,速度却快近一倍。
几点必要的保留
这份测试的严谨之处在于明确标注了局限:每个提示词只跑一次、只取首图,没有重摇;Google的成本是推算而非实际扣费;两家的"常规设置"(Google 1K与OpenAI high)本身就不对等;判分完全出自测试者个人主观,没有自动化评分。此外成本会随每次"思考"量浮动(Nano Banana 2.1在$0.0410到$0.0473之间波动),速度波动更大——一次作废的Flare调用竟耗时144.5秒。
正如测试者的总结:两家都造出了优秀的工具,彼此的差距如今只是一两美分。按任务选型,然后用自己的提示词测一遍——因为"一次就是一次"。
相关推荐

FlexBudget:在统一算力预算下公平比较KV缓存淘汰策略
AMD工程师在PyTorch Conference提出FlexBudget,通过固定kernel和显存预算、只替换KV缓存淘汰规则,实现training-free的公平方法比较,全部基于核心PyTorch实现。

Anthropic 2万亿估值拆解:AI上市潮为何接连折戟
Anthropic寻求2万亿美元估值,相当于史上最大十起科技IPO估值总和。但利率飙升、IPO撤回、TAM通胀、循环融资闭环正在动摇AI上市潮的定价基础。本文拆解2万亿估值背后的逻辑漏洞,以及英伟达为何反而便宜。
Anthropic IPO倒计时:2万亿美元估值背后的算力账本
Anthropic IPO进入倒计时,目标估值最高2万亿美元,较半年前H轮融资翻倍。本文梳理从秘密交表到投资者日的完整时间线,分析2万亿估值背后的算力成本逻辑,以及投资者日真正要回答的核心问题。