NarraSpace:多模态场景证据如何提升痴呆症分类可解释性

NarraSpace 将图片描述转录链接到场景事件,实现可追溯的阿尔茨海默病分类。
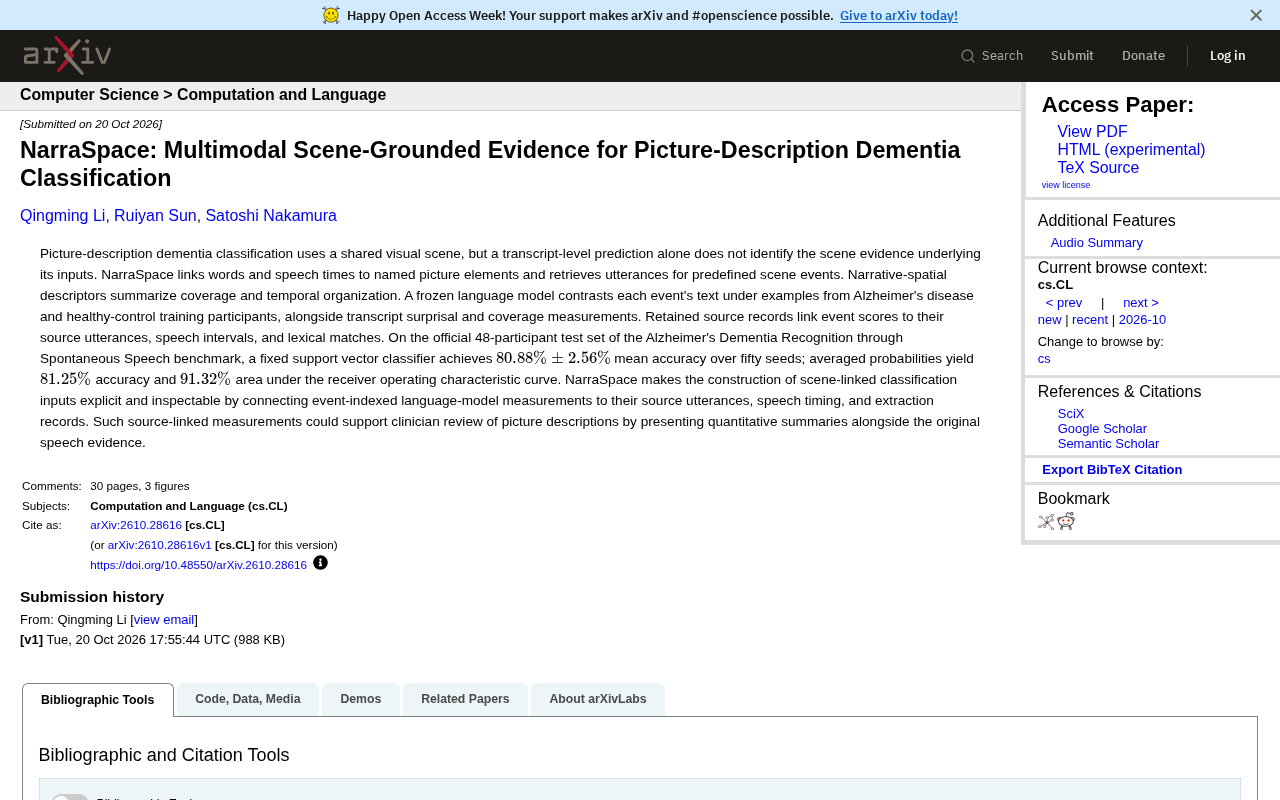
NarraSpace 框架针对阿尔茨海默病早期筛查中的图片描述任务,把传统转录文本分类的“黑箱”预测拆解为可检查的场景证据。系统将转录词语与语音时间戳链接到图片中命名的元素,并检索与预定义场景事件相关的话语,结合叙事-空间描述符(场景覆盖率、时间组织)、冻结语言模型的对比测量与转录困惑度,最终由固定 SVM 分类器给出预测。在 ADReSS 48 人测试集上,50 个随机种子下平均准确率 80.88%±2.56%,概率平均后达 81.25%,AUC 为 91.32%。每个事件得分均可回溯到源话语、语音区间与词汇匹配记录,支持临床医生审查原始语音证据,在提升可解释性的同时未牺牲分类精度。
在阿尔茨海默病(AD)的早期筛查中,图片描述任务是一种常见的神经心理评估手段:让受试者描述一张复杂场景图片,临床医生根据其语言内容判断认知状态。然而,传统的转录文本分类模型只给出“痴呆”或“健康”的预测标签,却无法说明是图片中的哪些元素、受试者的哪些话语支撑了这一判断。这种“黑箱”特性限制了模型在临床审查中的可信度。近期提出的 NarraSpace 框架尝试解决这一问题——它将转录文本中的词语与图片中的命名元素关联起来,并检索与预定义场景事件相关的话语,从而构建出可追溯、可检查的分类证据。
从转录分类到场景证据链接
NarraSpace 的核心思路是将图片描述任务中的“共享视觉场景”作为锚点,把转录级别的预测拆解为场景事件级别的证据。具体而言,系统将转录中的词语和语音时间戳链接到图片中命名的元素(如“男孩”“狗”“秋千”),并检索出与预定义场景事件对应的受试者话语。这些场景事件是图片中发生的典型活动或关系,例如“男孩从树上摔下”“女人在洗碗”等。通过这种方式,模型不再只是输出一个标签,而是能够指出哪些场景事件的话语证据影响了分类结果。
据原论文描述,NarraSpace 还引入了叙事-空间描述符来总结场景覆盖率和时间组织特征。覆盖率反映受试者提到了多少预定义场景元素,时间组织则捕捉话语在时间轴上的分布模式。这些描述符与话语级别的语言模型测量相结合,形成多维度的分类输入。
图片描述任务(Cookie Theft 图片等)是 AD 筛查中的经典范式,其原理在于:描述复杂场景需要调用词汇检索、句法组织、语义整合与工作记忆等多种认知能力,而这些能力在 AD 早期即可出现损伤。临床常用的 Boston Naming Test 或语义流畅性测验侧重单词层面,图片描述则同时考察连贯叙事能力,因此对轻度认知障碍(MCI)向 AD 转化的预测价值更高。传统评分依赖临床医生人工统计信息单元(idea units)和语法错误,耗时且评分者间一致性有限,这正是自动化转录分析试图替代的环节。
冻结语言模型与支持向量机的组合
在分类阶段,NarraSpace 使用一个冻结的语言模型来对比每个场景事件的文本——将其与阿尔茨海默病组和健康对照组的训练样本示例进行对比,同时结合转录困惑度(surprisal)和覆盖率测量。最终,一个固定的支持向量机(SVM)分类器基于这些特征进行预测。
在阿尔茨海默病通过自发语音识别(ADReSS)基准的官方 48 人测试集上,该系统在 50 个随机种子下取得了 80.88%±2.56% 的平均准确率;对概率取平均后,准确率达到 81.25%,ROC 曲线下面积(AUC)为 91.32%。这一性能表明,场景链接的证据不仅提升了可解释性,也没有牺牲分类精度。
ADReSS 基准(Alzheimer's Dementia Recognition through Spontaneous Speech)是 INTERSPEECH 2020 发起的公开挑战赛数据集,包含 78 名 AD 患者与 78 名健康对照的 Cookie Theft 图片描述录音及其人工转录,官方划分训练/测试集各半,测试集即文中所述的 48 人。该基准的评测指标为准确率与 F1,近年多数系统的准确率集中在 75%–85% 区间,因此 80.88% 属于该基准上的中上水平。需注意 ADReSS 的测试集规模小、人群构成单一,在这一基准上的提升未必能直接推广到真实临床人群,这也是文中强调样本规模局限的背景原因。
**支持向量机(SVM)**是一种基于最大间隔思想的监督分类器,它寻找能将两类样本分开且间隔最大的决策超平面,并通过核函数处理非线性边界。在小样本、高维特征场景下,SVM 通常比深度网络更稳健,不易过拟合,这与 ADReSS 测试集仅 48 人、特征维度有限的设定高度契合。所谓“冻结”(frozen)语言模型指推理阶段不更新参数,仅将其输出作为固定特征提取器,好处是训练成本低、结果可复现、便于归因到具体话语;代价是无法针对任务分布做适配,这也是作者在展望中提到端到端微调的原因。
可检查性:连接测量与原始语音证据
NarraSpace 的一个关键设计是保留源记录:每个事件得分都能链接回其来源话语、语音区间和词汇匹配记录。这意味着临床医生在审查图片描述时,不仅能看到量化摘要,还能直接跳转到原始语音证据。论文指出,这种源链接测量“可以使场景链接分类输入的构建变得明确且可检查”,为临床审查提供了可能。
从应用角度看,这一特性对于痴呆症筛查工具的实际部署尤为重要。临床医生需要理解模型为何做出某一判断,才能将其纳入辅助诊断流程。NarraSpace 通过将事件索引的语言模型测量与源话语、语音时间和提取记录相连,朝着这个方向迈出了一步。
局限与展望
当前 NarraSpace 的评估基于 ADReSS 基准的 48 人测试集,样本规模相对有限。预定义场景事件的覆盖范围也可能受限于图片本身的设计。此外,冻结语言模型的选择和 SVM 分类器的固定配置意味着系统尚未探索端到端微调的可能性。尽管如此,该框架提出的“场景证据链接”思路为多模态痴呆症分类提供了一个可解释性优先的范式,未来或可扩展到更多图片描述任务和临床场景中。
**转录困惑度(surprisal)**源自信息论,指语言模型对实际出现词语所赋予的负对数概率,值越高表示该词越出乎模型预料。在痴呆症语音分析中,surprisal 的均值和方差可作为语言可预测性的代理指标:AD 患者常出现词汇选择异常、句法偏离和话题漂移,导致局部 surprisal 升高或波动增大。该指标的优势在于无需人工标注即可计算,且与语义流畅性、命名困难等临床观察存在相关性;但其取值高度依赖所用语言模型的训练语料,跨模型、跨语种比较时需谨慎解读。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。