Needle:14MB基础模型如何撬动边缘AI部署
当基础模型缩小到14MB
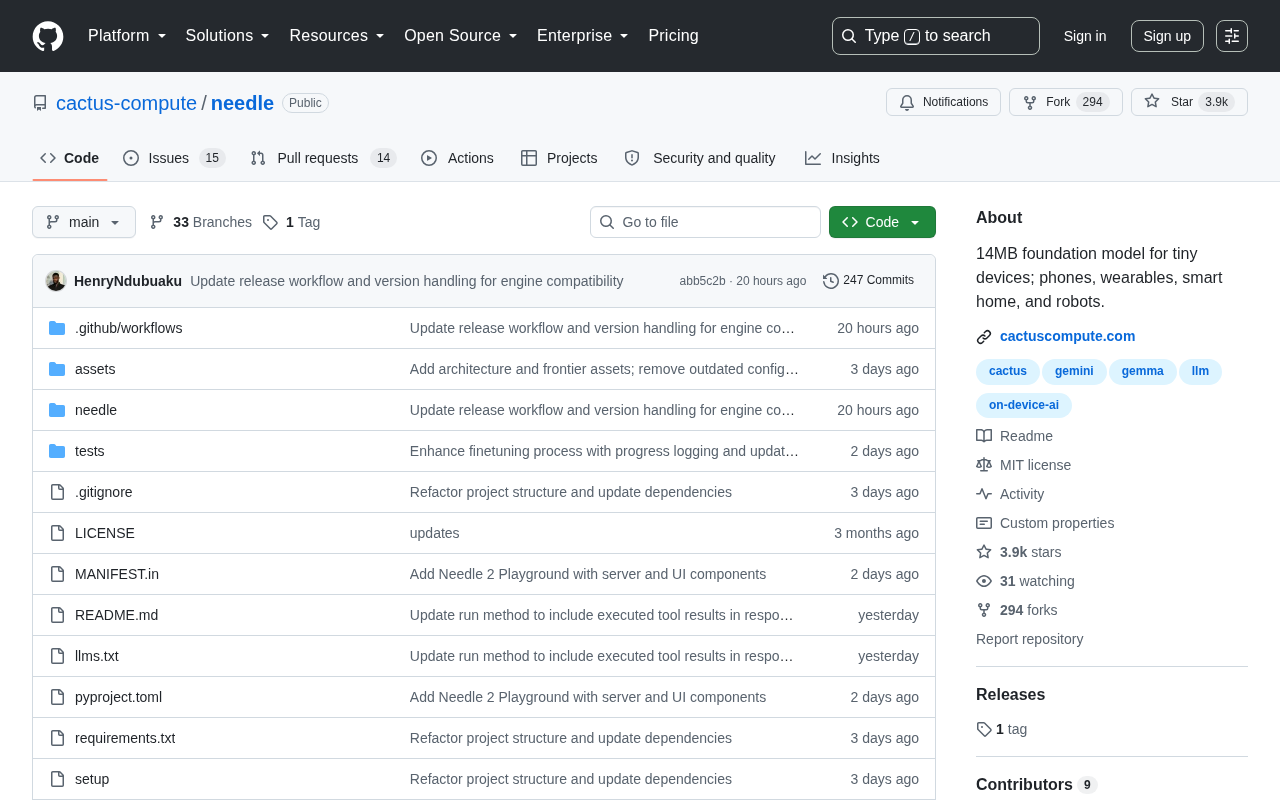
在大模型军备竞赛动辄以数百亿参数、数十GB体积为荣的今天,一个来自 cactus-compute 团队的开源项目正在走一条截然不同的路线。这个名为 Needle 的项目,把一个可用的基础模型压缩到了仅仅 14MB——这个体积甚至比很多手机 App 的安装包还要小。
这里有必要解释一下「基础模型」这个概念。基础模型(Foundation Model)由斯坦福大学人类中心AI研究所(HAI)在2021年正式提出,指的是在大规模数据上通过自监督学习训练出的通用模型,可以通过微调适配多种下游任务。GPT系列、BERT、LLaMA等都属于基础模型。与传统的任务特定模型不同,基础模型的核心价值在于其涌现能力和迁移学习潜力——一个模型训练一次,可以服务于文本生成、分类、问答、代码编写等多种场景。Needle将自己定位为基础模型而非专用模型,意味着它试图在14MB的极端约束下保留这种通用性和可迁移性,这在技术上是一个极具挑战性的目标。
项目发布后迅速在 GitHub 上获得关注,目前已累积 3835 stars、292 forks,并保持着单日新增 248 stars 的增长势头。对于一个主打「极致轻量」的模型项目而言,这样的社区反响足以说明市场对边缘侧 AI 的强烈渴求。
Needle 的定位非常明确:为微型设备打造的基础模型。项目描述中列出的目标硬件包括手机、可穿戴设备、智能家居设备以及机器人。这些设备的共同特点是——算力有限、内存紧张、功耗敏感,恰恰是传统大模型难以落地的「深水区」。
为什么边缘设备需要一个14MB的模型
云端推理的隐性成本
目前主流的 AI 应用几乎都依赖云端推理:设备把数据发送到服务器,服务器完成计算后再返回结果。这套模式虽然成熟,但存在几个绑不开的痛点。
首先是延迟。对于机器人控制、语音交互这类实时性要求高的场景,网络往返的几十甚至上百毫秒可能就是「可用」与「不可用」的分界线。在工业机器人领域,控制回路的延迟要求通常在10毫秒以内,而即便是优化良好的云端调用,光网络传输就可能消耗20-100毫秒,再加上服务器排队和推理时间,总延迟很容易突破200毫秒。这对于需要实时反馈的交互场景来说是不可接受的。即便在消费级应用中,Google的研究也表明,语音助手的响应延迟每增加100毫秒,用户满意度就会下降约5%——人类对对话节奏有着本能的敏感性,而这种敏感性对延迟的容忍度远低于大多数工程师的直觉判断。
其次是隐私,可穿戴设备采集的健康数据、智能家居捕获的家庭画面,一旦上传云端就存在泄露风险。最后是成本与可用性,持续的云端调用意味着持续的服务器开销,而离线环境(如地下室、野外、弱网地区)则直接让云端方案失效。
从市场数据来看,这些痛点正在被快速放大。据市场研究机构预测,全球边缘AI市场规模将从2023年的约150亿美元增长到2028年的超过600亿美元,复合年增长率超过30%。推动这一增长的因素包括:物联网设备数量预计在2025年突破750亿台、5G网络虽提升了带宽但并未消除延迟和覆盖盲区的根本问题、以及全球各地日益严格的数据隐私法规(如GDPR、中国《个人信息保护法》)使得本地数据处理成为合规刚需。在这一背景下,能够在终端设备直接运行的AI模型不再是「锦上添花」,而是产业基础设施的关键组成部分。
端侧推理的资源门槛
把模型放到设备本地运行(即端侧推理)能解决上述问题,但代价是要面对设备极其有限的资源。一块智能手表可能只有几百 MB 内存,一个智能家居芯片的算力更是捉襟见肘。传统的量化后的 LLM 即便压到几百 MB,对这类设备来说依然是「奢侈品」。
这里需要了解一下NPU(Neural Processing Unit,神经网络处理单元)的背景。NPU是专为AI推理计算设计的硬件加速器,与通用CPU和GPU相比,NPU在矩阵乘法、卷积运算等AI核心计算上具有数量级的能效优势——典型的NPU能以不到1瓦的功耗完成每秒数万亿次的整数运算(TOPS)。这种优势源于NPU的数据流架构(dataflow architecture):与CPU逐条执行指令、频繁访问内存不同,NPU将数据在计算单元之间直接流动,极大减少了内存访问带来的能耗和延迟。目前高通骁龙8系列的Hexagon NPU、苹果的Neural Engine(A17 Pro集成了约190亿晶体管中相当比例用于神经引擎)、联发科的APU等都已集成在移动芯片中。然而,大量的微型设备——如低成本的MCU(微控制器,如ARM Cortex-M系列,主频通常仅几十到几百MHz,RAM从几十KB到几MB不等)、传感器节点、RFID标签——并不配备NPU,仅依赖低功耗CPU核心完成所有计算。这些MCU的典型功耗在微瓦到毫瓦级别,单片成本低至0.5-5美元,是构成物联网末梢神经的核心器件。
Needle 的 14MB 体积,正是瞄准这道门槛。它意味着模型可以直接嵌入固件、常驻内存,甚至在没有专用 NPU 的设备上也有纯CPU运行的可能。这为「让每个微型设备都具备基础智能」提供了现实路径。作为参考,一个典型的ESP32-S3微控制器拥有8MB PSRAM和16MB Flash存储,14MB的模型恰好处于这类设备可以容纳的边界——这意味着Needle有望在成本仅几美元的芯片上运行,极大地拓展了AI可覆盖的设备范围。而更高一级的如Nordic nRF5340(双核Cortex-M33,1MB Flash + 512KB RAM加外挂存储)或瑞萨RA6系列,配合外部SPI Flash同样可以容纳这一体积的模型。
Needle 的技术取向与生态位
用 Python 构建,面向嵌入式场景落地
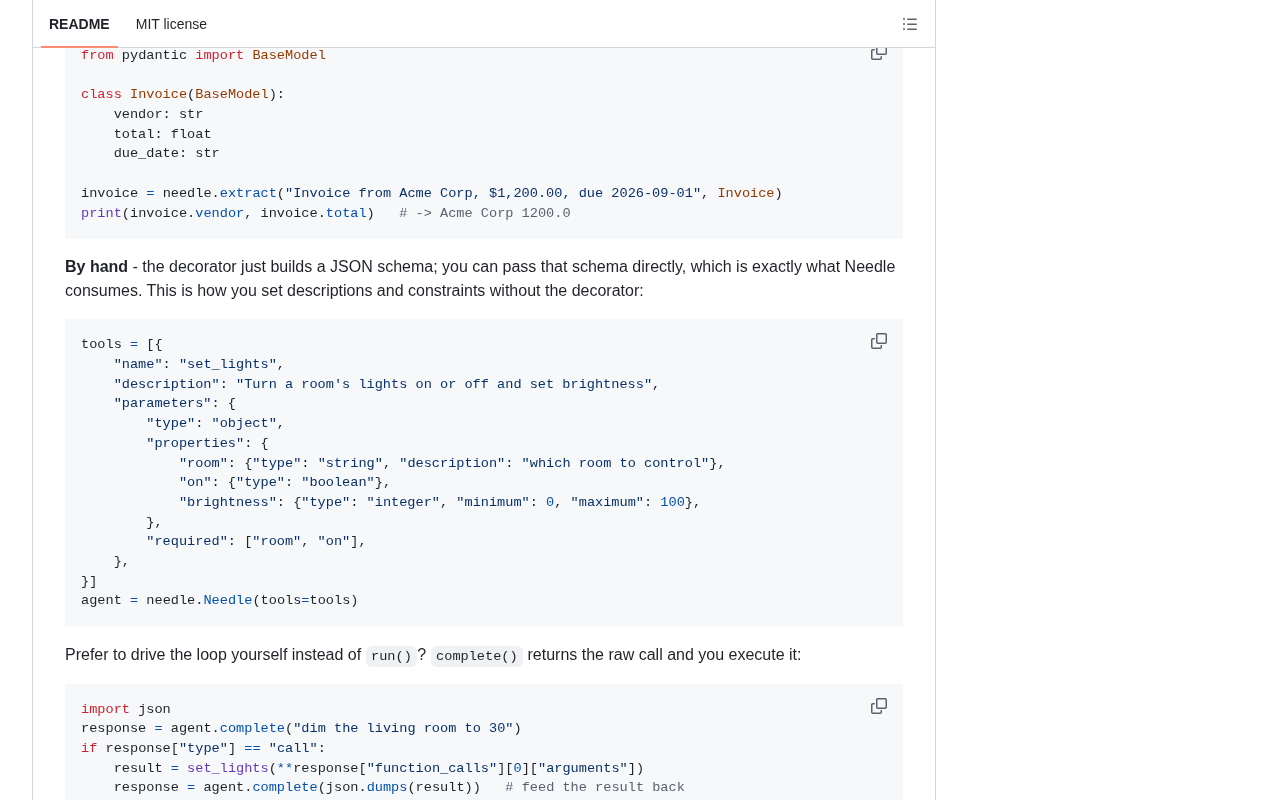
从项目信息看,Needle 以 Python 作为主要语言,这降低了开发者的上手门槛,便于社区参与训练、微调与实验。而其最终目标是部署到嵌入式环境,因此可以预见项目会配套轻量级的推理运行时,以适配 ARM 架构、微控制器等边缘硬件。在嵌入式部署中,Python通常只用于模型的训练和导出阶段,实际运行时会转换为C/C++实现的推理引擎执行,或通过ONNX、TFLite等中间格式进行部署。这种「Python训练+C推理」的双轨策略在边缘AI领域已成为标准实践。具体而言,TensorFlow Lite Micro(TFLM)是Google推出的专为微控制器设计的推理框架,其运行时开销仅几十KB;ONNX Runtime的嵌入式版本同样提供了极致精简的推理路径;而更激进的方案如Apache TVM则可以将模型编译为特定硬件的优化机器码,彻底消除运行时框架的开销。
说个细节,Needle 出自 Cactus Compute 团队之手。这家公司本身就专注于端侧 AI 推理框架的开发,Needle 可以看作是其技术栈中「模型层」的一环——有了极小的基础模型,再配合高效的推理引擎,就能构成完整的边缘 AI 解决方案。
14MB是如何实现的:模型压缩技术路径
将模型从数GB压缩到14MB,通常需要综合运用多种压缩技术。**量化(Quantization)**是最常见的手段,将模型参数从FP32(32位浮点数,每个参数占4字节)降低到INT8(8位整数,每个参数占1字节)甚至INT4(4位整数,每个参数仅占0.5字节),可以减少4-8倍存储空间。量化又分为训练后量化(PTQ,Post-Training Quantization)和量化感知训练(QAT,Quantization-Aware Training),后者在训练过程中就模拟低精度运算,通常能获得更好的精度保持效果。近年来还出现了更精细的量化方案,如GPTQ(一种基于二阶信息的逐层量化算法)和AWQ(Activation-aware Weight Quantization,根据激活值的重要性进行差异化量化),它们在极低比特数下仍能保持较好的模型质量。
**知识蒸馏(Knowledge Distillation)**是另一项关键技术,由Geoffrey Hinton等人在2015年的论文《Distilling the Knowledge in a Neural Network》中正式提出。其核心思想是让小模型(学生模型)不仅学习标签的硬分类结果,还学习大模型(教师模型)输出的软概率分布(即「暗知识」dark knowledge),从而在极小参数量下尽可能保留大模型的推理能力。直觉上理解,教师模型的软标签包含了类别之间的关系信息——比如教师模型认为「猫」图片有0.7的概率是猫、0.2的概率是虎、0.05的概率是狗,这比简单的「这是猫」标签包含了更丰富的结构化信息。近年来这一技术已发展出多种变体,包括特征蒸馏(让学生模型的中间层特征对齐教师模型)、关系蒸馏(学习样本之间的相对关系)、自蒸馏(模型从自身的早期版本学习)等。
**剪枝(Pruning)**移除神经网络中冗余的连接和神经元。研究表明,典型的深度神经网络中有大量参数是冗余的——「彩票假说」(Lottery Ticket Hypothesis,由MIT的Jonathan Frankle和Michael Carlin在2019年提出)指出,在随机初始化的网络中存在一个稀疏子网络,其性能可以匹配甚至超过完整网络。这一发现意味着神经网络的大部分参数可能只是为了帮助优化过程找到好的解,而非最终推理所必需。结构化剪枝可以直接移除整个通道或注意力头,不需要特殊硬件支持即可获得实际加速。非结构化剪枝虽然理论压缩率更高,但产生的稀疏矩阵需要专门的硬件或软件支持才能转化为实际的速度提升。此外还有权重共享(多个连接使用同一参数值,通过聚类实现)、低秩分解(将大的权重矩阵W分解为两个小矩阵U·V的乘积,其中U∈R^(m×r),V∈R^(r×n),当r远小于m和n时可以大幅减少参数量)等技术手段。
更激进的方法则从模型架构层面进行创新,设计原生适配小体积的网络结构,而非简单地缩小现有架构。例如使用更高效的注意力机制变体(如线性注意力将标准Transformer的O(n²)复杂度降低到O(n)、Flash Attention通过分块计算减少内存访问、多查询注意力MQA让多个查询头共享键值对从而减少参数量)、采用参数共享的循环层设计(如Universal Transformer中跨层共享参数的思路,或ALBERT模型验证的跨层参数共享可以在参数量缩减数倍的情况下保持大部分性能)、减少冗余的层级设计等。Needle具体采用了哪些技术组合目前尚未完全公开,但14MB的目标意味着必然在架构设计和训练策略上做了深度定制——这不是简单地把一个大模型「缩小」,而更可能是从零开始为这个体积目标量身打造的模型。以14MB的体积和INT4量化估算,模型大约可以容纳2800万个参数(14MB ÷ 0.5字节/参数 = 2800万参数),这个量级需要极其精心的架构设计才能实现有意义的语言理解能力。作为对比,原始BERT-base有1.1亿参数(约440MB FP32),而学术界已经证明经过精心设计的2000-5000万参数模型可以在特定基准上达到BERT约70-80%的性能。
「基础模型」而非「玩具模型」
项目强调 Needle 是一个 foundation model(基础模型),而非针对单一任务训练的专用小模型。这个措辞背后有明确意图:基础模型意味着它具备一定的通用能力,可以作为下游任务微调的起点,而不是只能做一件事的固定功能模块。
这也是 Needle 与传统嵌入式 ML 模型(如 TinyML 领域的关键词唤醒、手势识别模型)的本质区别。TinyML是指在毫瓦级功耗的微控制器上运行机器学习模型的技术领域,由哈佛大学教授Vijay Janapa Reddi等人推动普及,并在2019年前后形成了较为完整的技术栈和社区生态。典型应用包括关键词唤醒(如「Hey Siri」的本地检测,通常使用不到500KB的模型,基于深度可分离卷积或递归神经网络实现)、加速度计手势识别(利用IMU数据识别预定义动作)、异常振动检测(工业预测性维护场景)、视觉唤醒(使用极简CNN检测是否有人脸出现以唤醒更高功耗的处理器)等。这些模型通常只有几十KB到几MB大小,使用TensorFlow Lite Micro、ONNX Runtime Mobile、CMSIS-NN(ARM提供的神经网络计算库)等轻量级推理框架部署在Cortex-M或RISC-V微控制器上。但TinyML模型几乎都是单一任务、固定功能的——一个关键词唤醒模型无法做情感分析,一个手势识别模型无法理解自然语言。每增加一个新功能,就需要重新训练和部署一个全新的模型,这意味着设备的Flash存储中可能需要塞入多个独立模型,管理复杂度随功能数量线性增长。
Needle试图突破这一范式,在TinyML可接受的体积范围内提供基础模型级别的通用能力,这相当于在传统TinyML和大语言模型之间开辟了一个全新的技术层级。开发者可以基于它构建多样化的端侧智能应用——从简单的意图识别到基础的文本理解,而不需要为每个任务单独训练和部署一个模型。这种「一模多用」的范式如果成功,将大幅降低边缘AI应用的开发和维护成本,因为开发者只需要准备少量的任务特定微调数据(可能仅需几百到几千条标注样本),而不是从头构建整个模型流水线。这与大模型领域的「预训练+微调」范式在哲学上完全一致,只是将其缩小到了嵌入式设备可承受的尺度。如果这条路线被验证可行,我们可能会看到一个新的产业分工出现:有团队专注于训练和优化这类超轻量基础模型,而更多的应用开发者则基于它们快速构建垂直领域的端侧智能功能。
边缘AI的趋势信号
Needle 的走红并非孤立事件,而是整个行业向「端侧智能」倾斜的一个缩影。随着大模型能力见顶后的效率优化浪潮到来,「用更小的模型做更多的事」正在成为新的技术竞赛焦点。这一趋势有时被称为「Scaling Down」运动,与过去几年「Scaling Up」的主旋律形成对照——业界逐渐认识到,在许多实际应用场景中,模型效率(每单位计算量产生的价值)比绝对能力更重要。这一认知转变的理论基础部分来自「Chinchilla定律」的启示:DeepMind在2022年的研究表明,在固定计算预算下存在最优的模型大小和训练数据量配比,盲目增大模型并不总是最优策略。将这一思想进一步推向极端——如果计算预算被严格限制在一枚微控制器能承受的范围内,什么样的模型设计能在这个约束下提取最大价值?这正是Needle所探索的核心问题。
从苹果在设备端部署压缩模型(如 iPhone 上的 Apple Intelligence 本地推理能力,其本地模型约30亿参数,采用了2-bit和4-bit混合量化技术,在A17 Pro和M系列芯片的Neural Engine上运行),到高通、联发科在移动芯片中集成 NPU(高通最新的骁龙8 Gen 3的Hexagon NPU算力达到73 TOPS,支持超过100亿参数的模型在端侧运行;联发科天玑9300的APU达到46 TOPS),再到各类开源社区涌现的小模型项目(如 Microsoft 的 Phi-3 系列以38亿参数实现了接近GPT-3.5的推理能力、Google 的 Gemma 2B/7B 专为设备端优化设计了高效的分组查询注意力机制、Meta 的 Llama 3.2 1B/3B 版本专门针对移动端进行了架构优化),方向高度一致:AI 正在从数据中心向终端设备迁移。
值得注意的是,这些「小模型」虽然相比GPT-4等巨型模型(据估计有超过1万亿参数)已经极大缩小,但最小的也在10-30亿参数级别、体积数百MB到数GB之间。Needle的14MB目标比这些「小模型」又小了一到两个数量级,真正触及了微控制器和超低功耗设备的可用范围。这个体积差距不仅是量的区别,更可能带来质的变化——它意味着从「需要手机级硬件」到「普通传感器芯片即可」的跨越。
Needle 把体积压到 14MB 这一激进目标,某种程度上是在为「万物皆可 AI」的愿景探路——当模型足够小、足够省电,它就能出现在过去不可能承载 AI 的地方,比如一枚纽扣大小的传感器、一台没有联网的家用机器人、一副只有基础芯片的智能眼镜。这种极端的轻量化打开了一个全新的应用空间:不再需要考虑「这个设备能不能跑AI」,而是「这个设备上的AI能做什么」。想象一下,一个农业温室中的土壤传感器不仅能采集温湿度数据,还能在本地判断「这个数据模式意味着什么」并直接触发灌溉决策,无需任何网络连接——这就是14MB基础模型可能带来的应用范式变革。
当然,14MB 的体积必然伴随能力上的取舍。对于开发者而言,理性的期待是:Needle 不会替代云端大模型处理复杂推理,但它有望在低功耗、离线、实时的细分场景里,成为一个「够用且高效」的选择。它更可能扮演的角色是端-云协作架构中的「前哨」——在本地完成快速初步判断(如意图分类、关键信息提取、异常检测),只在必要时才将复杂任务上传云端处理。这种分层架构在业界被称为「边缘-云混合推理」(Edge-Cloud Hybrid Inference),已被越来越多的系统架构师所采纳,因为它在延迟、成本、隐私和能力之间取得了最优平衡。在实际部署中,这种架构通常包含三个层级:最前端的MCU运行超轻量模型完成实时感知和快速决策(延迟<10ms);中间的边缘网关(如具备NPU的手机或边缘服务器)运行中等规模模型处理更复杂的推理(延迟<100ms);最后端的云端大模型处理需要深度推理的复杂查询(延迟>500ms但能力最强)。Needle恰好填补了第一层的模型空白。
写在最后
Needle 代表了边缘 AI 的一种务实思路——不追求参数规模的极致,而追求落地场景的极致。对于关注端侧部署的开发者、硬件厂商以及机器人从业者,这个项目值得持续跟踪。
目前项目仍处于早期阶段,实际的性能表现、支持的任务范围、量化精度损失等关键指标,还有待官方文档与社区实测的进一步验证。但可以确定的是,把基础模型塞进 14MB 这件事本身,已经在为「让智能无处不在」的目标推倒一块重要的多米诺骨牌。当行业的注意力从「模型能有多大」转向「模型能有多小而依然有用」时,一场新的技术竞赛才刚刚拉开序幕。
相关推荐

Python访问者模式与更优替代方案详解
深入解析Python访问者模式及四种替代方案:方法模式、模式匹配、字典映射与functools.singledispatch单分派。从节点与操作的双轴矩阵出发,帮你根据变化频率选择最合适的解耦设计。

357天深度体验:Omarchy为何让我告别发行版跳槽
连续使用 Omarchy 357 天的深度体验:59 秒安装、开箱即用的音频与 GPU 支持、Quattro 版本 QuickShell 重写带来的配置迁移阵痛,以及它为何值得 Arch 用户尝试。

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。