内存延迟才是AI性能的真正瓶颈

AI系统真正的性能瓶颈往往是内存延迟而非算力,优化重心需从堆算力转向内存访问路径。
文章挑战了当前AI性能讨论中被算力叙事主导的倾向,指出真正制约系统性能的常常是内存延迟而非峰值算力。文章区分了带宽与延迟两个不同维度,说明在注意力机制、KV cache读写、embedding查表等细粒度访问场景下,延迟起决定作用,带宽充足也可能依然缓慢。增加并行度掩盖延迟的收益递减明显,且会带来调度开销与缓存争用。作者认为,承认内存延迟是瓶颈意味着单纯堆算力的路线存在结构性上限,优化重心应转向数据布局、缓存层次设计以及包含等待时间的评测指标。
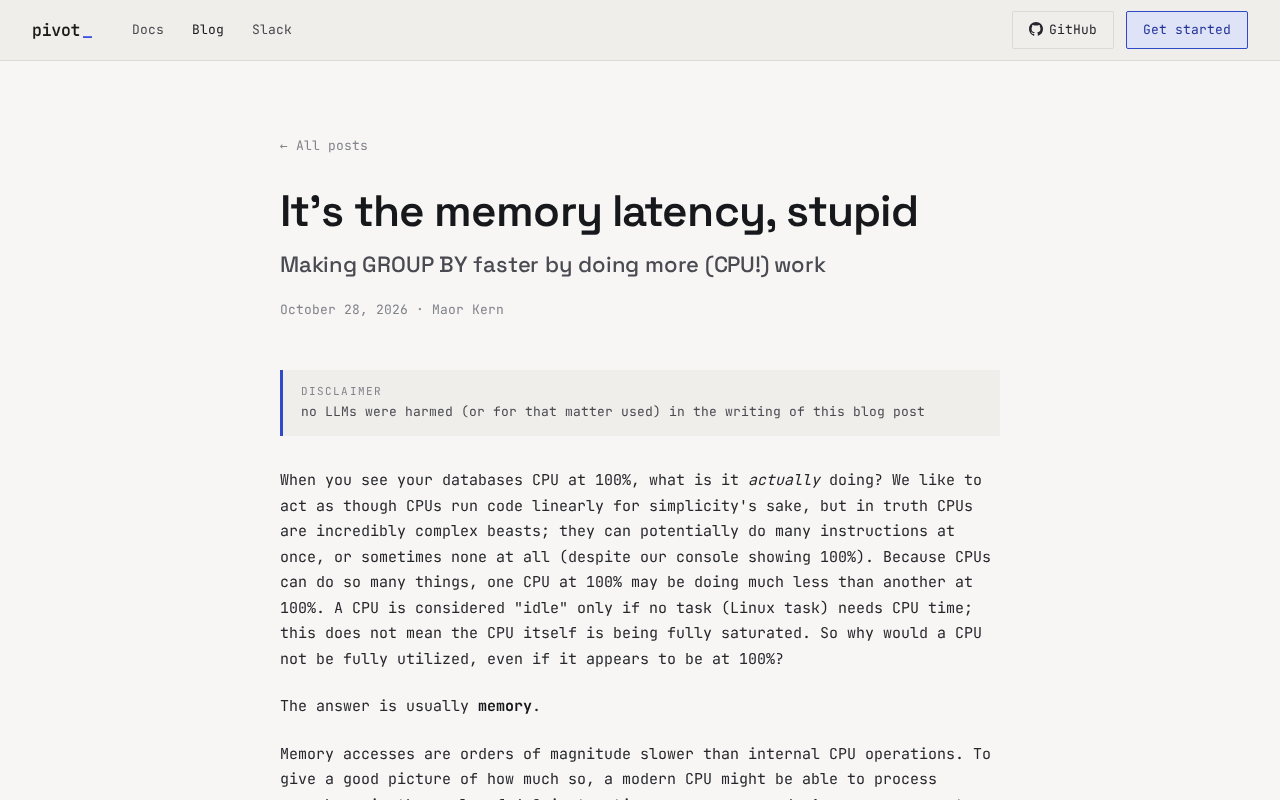
AI 性能优化的讨论长期被算力叙事主导,GPU 的 TOPS 数字、参数量、训练吞吐量占据了大部分注意力。但一篇在 Hacker News 上引发 221 点热议的文章提出了一个不太受欢迎的观点:真正卡住系统性能的,往往是内存延迟,而不是算力本身。这个判断指向了当前 AI 系统设计中被反复忽视的一环。
算力叙事遮蔽了内存瓶颈
过去几年,芯片厂商和云服务商习惯用峰值算力来标记硬件代际。问题在于,大多数真实工作负载并不会持续以峰值算力运行。数据需要在计算单元和内存之间来回搬运,每一次搬运都产生延迟,而延迟无法通过增加并行度来完全掩盖。
当模型规模扩大、批处理策略变得更复杂时,内存延迟的影响会被进一步放大。很多场景下,计算单元处于等待数据的状态,利用率远低于标称值。讨论算力而不讨论数据供给效率,得到的性能图景是不完整的。
文章的核心论点可以概括为一句话:在相当多的系统里,瓶颈从计算转移到了内存访问路径上,但优化投入和评测框架却没有同步转移。
内存墙在AI工作负载中的具体表现
延迟与带宽不是一回事
内存带宽衡量单位时间能传输多少数据,内存延迟衡量一次访问需要等多久。两者经常被混为一谈,但对性能的影响路径完全不同。
大模型推理中的注意力机制、KV cache 读写、embedding 查表,这些操作的共同特征是需要频繁的细粒度访问,而不是少量的大块连续传输。在这种情况下,延迟决定了单次访问的等待成本,即使带宽充足,延迟过高也会让流水线频繁停顿。这是“带宽够用却依然慢”的典型场景。
内存墙(Memory Wall)是 Wulf 和 McKee 在 1995 年提出的概念,指处理器性能提升速度长期快于内存访问速度,导致计算单元与存储之间的差距不断拉大。这一概念在 AI 时代被重新激活:GPU 的浮点算力每代提升显著,而 DRAM 延迟的改善幅度有限,二者之间的鸿沟构成了系统性能的结构性上限。
KV cache 是大模型自回归推理中的关键机制。生成每个 token 时,模型需要复用此前所有 token 的 Key 和 Value 向量以计算注意力,这些向量被缓存起来避免重复计算。KV cache 的读写是典型的高频细粒度内存访问,其大小随上下文长度线性增长,因而对内存延迟和容量都极为敏感。
embedding 查表指从嵌入矩阵中按索引取出向量,本质是一次随机内存访问。索引分布越分散,缓存命中率越低,延迟成本越突出。这类操作在推荐系统和 NLP 模型中极为常见。
并行度掩盖不了根本问题
一种常见做法是用更高的线程并行度或更大的批处理来填满延迟造成的空档。这在负载足够密集时有效,但代价是资源占用上升,而且在延迟本身就处于主导地位的系统里,增加并行度会带来调度开销和缓存争用,收益递减很快。
这解释了一个现象:同样的模型、同样的硬件配置,在不同系统上跑出的性能差异远大于理论预期。差异往往来自内存访问路径的设计,而不是算力配置。
延迟隐藏(latency hiding)是计算机体系结构中的经典策略:当某条指令等待内存数据时,切换到其他就绪线程或 warp 继续执行,从而填满等待空档。GPU 的大量并发线程正是为此设计。但延迟隐藏有前提——必须有足够多的独立工作可供切换。当工作负载本身依赖链长、可并行任务不足,或并发线程过多导致缓存抖动时,延迟隐藏就会失效。这也是为什么单纯提高占用率(occupancy)并不总能带来性能提升。
这个判断为什么在当下显得反直觉
行业当前的资源投向集中在算力扩张上,围绕 GPU 集群和先进制程的投入规模庞大。相比之下,内存子系统、缓存层次结构、数据布局优化这些工作在宣传层面缺乏吸引力。
Hacker News 上由 72 条评论带来的分歧多半也源于此:一方面,承认内存延迟是瓶颈意味着大量既有优化方向需要重新评估;另一方面,内存厂商的提升节奏与算力增速并不同步,这个差距短期内难以弥合。承认这一点,就等于承认单纯堆算力的路线存在结构性上限。
文章标题借用了政治标语式的句式,本身带着某种挑衅意味,其用意是把讨论从算力竞赛拉回到系统层面。
HBM(High Bandwidth Memory)是目前 AI 加速器的主流内存方案,通过堆叠 DRAM 裸片并用硅中介层与 GPU 相连,实现了远高于传统 GDDR 的带宽。但 HBM 的核心优势在带宽而非延迟,其访问延迟与常规 DRAM 处于同一量级,并未随带宽同步改善。这正好对应文章指出的结构性矛盾:业界在带宽上持续投入,而延迟的改善节奏明显滞后。理解这一点,才能明白为什么“带宽翻倍”并不自动等于“推理变快”。
对工程实践的启示
如果接受内存延迟是主要瓶颈这个前提,优化重心应当发生位移:
- 数据布局优先于指令级优化。让访问模式更连续、更可预测,减少随机访问的比例,往往比微调算子实现带来更大的实际收益。
- 缓存层次的设计需要针对具体工作负载。通用缓存策略在特定访问模式下可能失效,针对访问分布做定制化设计值得投入。
- 评测指标要包含等待时间。只看吞吐量和峰值算力,会系统性地低估内存路径的影响,导致优化方向判断失误。
这些方向不新,但在算力主导的话语体系里长期处于从属位置。文章提出的挑战在于,把它们从“次级优化项”提升为“首要设计约束”。
结语
“It's the memory latency, stupid” 的价值不在于提出新发现,而在于重新安排优先级。AI 系统性能讨论如果继续以算力为中心,会持续在错误的方向上消耗工程资源。把它当作一个需要正面回应的技术判断,比当作一句口号更有意义。
相关推荐

9家AI订阅套餐积分换算:每亿Token真实成本揭秘
B站UP主实测火山、阿里、腾讯、百度、智谱、小米、MiniMax等9家AI订阅套餐,统一换算每亿Token真实成本,拆解固定额度与三档系数两类计费逻辑,揭示缓存、时段折扣和窗口限额对实际额度的影响。
Vibe Coding入门:用意图表达代替手写代码
Vibe Coding 是什么?B站137集实战课程给出定义:核心不是写代码而是表达意图。本文解析 Vibe Coding 的生产力逻辑、适合人群与入门预期,帮助零基础者判断是否值得投入学习。
LangChain入门指南:从LangGraph到Deep Agents的智能体开发路线
理清LangChain、LangGraph和Deep Agents的封装关系,掌握智能体开发框架的学习路线与选型逻辑,适合大模型开发入门者参考。