Neil Patel只对了一半:GEO缺失的工程层

AI搜索只在高熵查询时触发外部检索,内容需按向量工程逻辑重构才能赢得引用。
文章指出,Neil Patel关于AI搜索的观察只对了一半:高熵多属性查询确实会触发RAG外部检索,但仅靠"写深度长文回答难题"无法获得引用。问题出在缺失的工程层——生成式引擎按250–500 token切块并向量化,再按余弦相似度与实体密度排序,叙事性长文会稀释答案的向量密度,被密集结构化答案反超。为此文章提出原子答案架构、多属性本体映射和包含高熵查询挖掘、45词判定块、实体矩阵与JSON-LD锚定的四步协议,主张内容团队应以向量空间逻辑而非人类阅读逻辑组织信息,才能实现引用垄断。
AI搜索正在重塑内容分发的底层逻辑。Neil Patel近期提出的观点触及了一个关键边界:当用户提出高度具体、带有真实行业约束的问题时,AI搜索引擎才会绕过内部记忆,转向外部网页引用。但营销团队若只是照搬"写深度长文回答客户难题"的传统打法,依然无法获得生成式引擎的引用。原因不在内容质量,而在信息架构的工程层缺失。
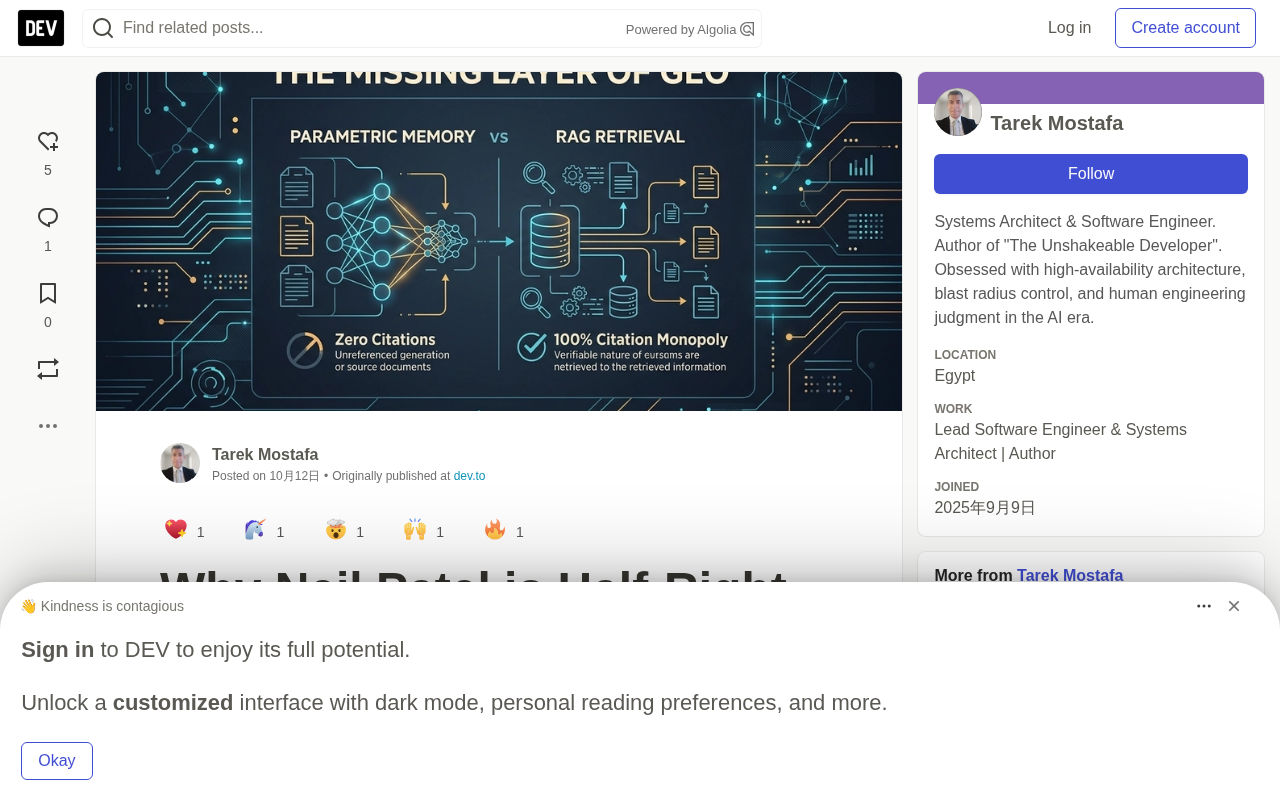
参数记忆边界:Neil Patel说对的部分
Neil Patel的实证观察在商业层面是准确的:用户问"什么是CRM",AI模型从预训练权重中直接生成答案,零点击、零引用;用户问"面向50床位儿科诊所、需集成Epic EHR的HIPAA合规CRM",模型内部置信度坍塌,查询路由器被迫触发实时检索增强生成(RAG),从外部网页抓取信息。
从计算机科学角度看,这描述的是参数记忆与非参数检索之间的边界。模型对通用问题保持高置信度(P>0.95),答案直接来自冻结权重;面对高熵多属性查询,置信度降至0.60以下,系统才启动网页检索与引用。Neil的核心判断——你的真实运营知识是LLM预训练权重中唯一不存在的专有数据——在商业上是成立的。
但问题在于,他对"如何让内容被引用"给出的建议,恰好暴露了营销思维与检索工程之间的鸿沟。
检索增强生成(RAG) 是指在大语言模型生成答案前,先从外部知识库(如网页、向量数据库)检索相关文档片段,再将其作为上下文拼入提示词,由模型基于这些片段组织回答。它把模型从"只能依赖训练时冻结的参数"变为"可动态调取实时、专有或长尾信息"。是否触发RAG通常由查询路由逻辑判断:当模型对答案的置信度低于阈值,或查询包含大量专有实体、时效性要求高时,系统才转向外部检索。这解释了文章所述现象——通用问题落在参数记忆内,高熵多属性查询才会被路由到网页检索与引用。
参数记忆指模型在预训练阶段通过海量文本压缩进权重中的知识。它是静态、冻结的,存在知识截止日期,且对低频、专有、地域性强的事实覆盖薄弱。因此企业独有的运营知识、内部流程与细分产品参数,往往不在任何模型的参数记忆中,只能通过外部检索获得。理解这两层机制的分工,是理解AI搜索为何只引用特定内容的前提。
营销内容为何失效:缺失的工程层
让营销人员"写内容回答难题",产出的通常是2500字的博客文章:对话式引言、关键词堆砌的副标题、叙事性填充。这类内容在生成式引擎的摄入管线中会被无情稀释。
生成式引擎(如驱动AI Overviews的Google Gemini、Perplexity的sonar模型)不以人类阅读方式浏览网页。其摄入流程遵循严格的数学约束:抓取器将HTML解析为固定token的语义块(通常250–500 token);每个块被转化为高维向量;当AI代理需要答案时,选择余弦相似度最高、实体覆盖最密集的块。
如果你的具体答案分散在三个叙事段落中,向量密度会被严重稀释。竞争对手用45词的密集结构化定义或表格给出精准答案,就能抢走引用——即使其域名权威更低。
| 向量检索维度 | 传统内容营销 | 生成式引擎优化(GEO) |
|---|---|---|
| 信息结构 | 叙事故事、对话段落 | 原子答案:45词独立语义块 |
| 检索目标 | 整页URL,按PageRank排序 | 细粒度块向量,按实体密度排序 |
| 实体锚定 | 正文关键词提及 | 绑定知识图谱实体的JSON-LD模式图 |
| 模型摄入 | 人类阅读流 | 单次向量提取,无叙事依赖 |
| 输出指标 | 自然点击与展示 | 引用垄断与自动摘要收录 |
语义块(semantic chunk)与向量化是生成式引擎摄入网页的核心工序。抓取器先将HTML按标题层级、段落边界切分为固定长度的块(常见250–500 token),再用嵌入模型把每块映射为高维向量。检索时,系统把用户查询同样向量化,通过余弦相似度等度量找出最接近的块,并优先选择实体密度高、语义自洽的块作为引用源。
这一机制的工程含义是:内容的竞争单位不再是"整页URL",而是"单个块"。如果答案被拆散在多个叙事段落中,每个块的向量都只承载部分信息,相似度被稀释;反之,一段40–50词、自包含、实体密集的块,其向量会更接近目标查询。实体密度指单位文本中明确命名实体(产品、标准、机构、技术)的占比,是向量检索排序的重要信号,也是本段表格中"按实体密度排序"的由来。
规则一:原子答案架构
每个H2标题下的首要段落必须是一个原子答案:40–50词的自包含语义块,无需前后文即可独立传达确定事实。
传统SEO写手习惯制造悬念——先铺垫问题、讲客户故事、最后揭晓方案以延长停留时间。生成式引擎惩罚这种结构。检索爬虫寻找可快速验证的答案,会直接丢弃叙事模糊性,选择语义清晰的块。
原子答案的不变量:紧贴H2或H3标签下方;长度严格40–50词(250–350字符);结构为[核心实体]+[确定动作/定义]+[具体技术机制]+[可量化企业影响];零代词——绝不以"本文将探讨…"开头,块被AI摘要器单独提取后必须100%逻辑自洽。
规则二:多属性本体映射
将对比和产品数据结构化为多属性本体表,能迫使AI搜索模型直接生成归属于你源域的结构化诊断卡片。
AI引擎处理复杂B2B买家查询时,很少返回原始文本,而是输出结构化要点或自动生成的对比矩阵。如果你的内容是非结构化散文,模型必须耗费算力调和你的主张,增加幻觉或遗漏概率。在HTML表格和配套JSON-LD中提供显式多属性映射,等于交给查询路由器一张预消化的计算图:[症状/查询实体]→[根因不变量]→[技术机制]→[可量化后果]。
据作者在《The Unshakeable GEO Expert》中发表的实证研究,将多属性本体结构应用于全量算法审计后,案例研究拿下了Google AI Overviews的全球第一来源卡片,搜索界面直接依据其发布的块数据自动生成交互式诊断表,实现100%引用垄断。
JSON-LD(JavaScript Object Notation for Linked Data) 是一种在网页中嵌入结构化数据的格式,通过<script type="application/ld+json">标签声明,让机器无需解析正文即可读懂页面中的实体、属性与关系。Schema.org 提供了通用词汇(如 Organization、Product、FAQPage),AI引擎与搜索引擎可据此把内容绑定到知识图谱节点。
当页面用JSON-LD显式声明"作者是谁、发布于何时、实体如何定义",检索代理就能验证来源身份与时效,从而调整权威权重。知识图谱是由实体及其关系构成的结构化网络,作为外部事实校验层,可降低模型对陌生内容的幻觉风险。因此,多属性本体表配合JSON-LD,本质是同时向检索器提供"可计算的结构"与"可验证的身份",这比单纯堆砌关键词更能提升被引用概率。
四步技术协议:从关键词到系统架构
捕获生成式搜索的引用垄断,需要废弃传统关键词聚类,转而采用对齐LLM检索约束的四步工程协议。
第一步:挖掘高熵查询而非关键词。 不要瞄准"CRM软件",而要瞄准"面向欧洲GDPR合规、支持自托管PostgreSQL后端的开源CRM"。这类查询保证LLM查询路由器绕过参数记忆、触发实时检索。
第二步:构建45词独立判定块。 在标题下第一行直接回答问题,消除所有对话式废话,以数学精度陈述判定。
第三步:部署多属性实体矩阵。 在干净的HTML表格中呈现竞争优势、技术限制与工作流架构。AI引擎优先处理表格数据,因为表格大幅降低推理延迟和token合成成本。
第四步:注入规范模式锚定。 用显式JSON-LD标记将作者身份、发布时间戳和实体定义绑定到既定知识图谱节点。当LLM验证发布者是已识别实体时,权威权重呈指数级放大。
从营销直觉到系统工程
营销直觉识别客户痛点,但系统工程决定AI引擎能否解析、信任并引用你的答案。
Neil Patel的核心论点依然成立:通用内容已死,第一手的、高度具体的领域经验是AI搜索引擎唯一尊重的货币。但缺少生成式引擎优化的工程层,即使最出色的第一手经验,对LLM检索代理而言仍不可见。
有机搜索的未来不属于声音最大的内容营销者,而属于以数学精度构建地面真相的架构师。当内容团队开始用向量空间的逻辑而非人类阅读的逻辑来组织信息时,引用垄断才成为可工程化的目标。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。