Nemotron 3.5双模型发布:Mamba-Transformer混合架构为Agentic AI提速

英伟达发布 Nemotron 3.5 Super 与 Lightning,以 MoE 混合 Mamba-Transformer 架构主打高效智能体推理。
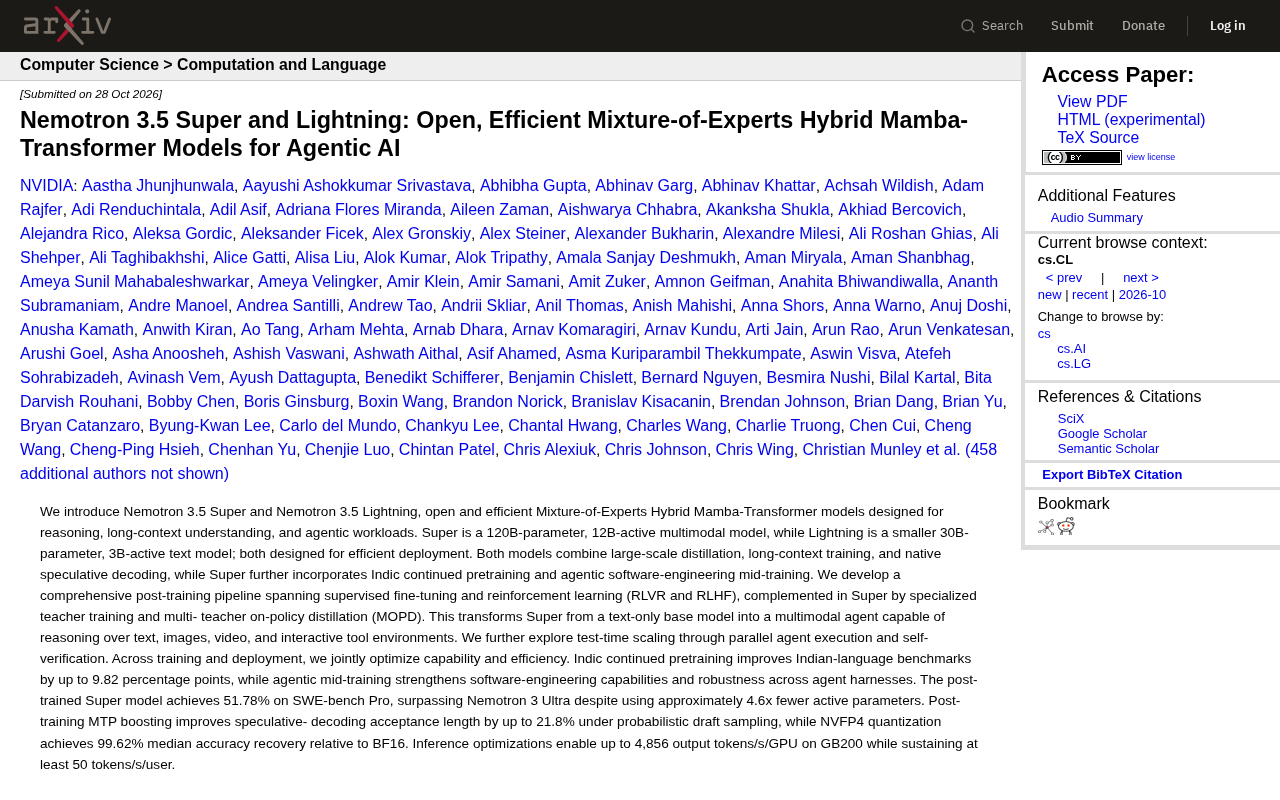
英伟达推出 Nemotron 3.5 Super(120B 总参数、12B 激活的多模态模型)与 Nemotron 3.5 Lightning(30B 总参数、3B 激活的纯文本模型),两者均采用 MoE 混合 Mamba-Transformer 架构,共享大规模蒸馏、长上下文训练与原生投机解码的训练哲学。后训练管线覆盖 SFT、RLVR 与 RLHF,Super 额外引入教师训练与多教师在线策略蒸馏,并叠加 Indic 继续预训练与智能体软件工程中期训练。结果显示,后训练后的 Super 在 SWE-bench Pro 上达 51.78%,超过 Nemotron 3 Ultra,而激活参数仅约其 1/4.6,说明激活规模与任务表现的传统映射正被训练管线改写。
英伟达推出的 Nemotron 3.5 Super 与 Nemotron 3.5 Lightning,把"开放、高效"两个词同时压在了混合专家(MoE)与混合 Mamba-Transformer 架构上。两款模型都面向推理、长上下文理解与智能体(agentic)工作负载,但走的是两条互补的规模化路径。
两款模型的分工逻辑
Super 是 120B 参数、12B 激活参数的多模态模型;Lightning 则是 30B 参数、3B 激活参数的纯文本模型。两者都强调"高效部署",区别在于 Super 承担多模态与复杂智能体任务,Lightning 定位更轻量的文本场景。
这种"大而稀疏 + 小而稀疏"的组合并不新鲜,但 Nemotron 3.5 的看点在于:两款模型共享同一套训练哲学——大规模蒸馏、长上下文训练、原生投机解码(native speculative decoding)。Super 额外叠加了 Indic 继续预训练与智能体软件工程中期训练,这是它从纯文本基座走向多模态智能体的关键一步。
MoE 与混合 Mamba-Transformer 的含义
混合专家(Mixture of Experts,MoE)是一种稀疏激活架构:模型总参数量很大,但每次前向计算只路由到少数“专家”子网络,因此激活参数远小于总参数。文中 Super 的 120B/12B、Lightning 的 30B/3B 都是这一结构,部署成本更接近激活参数规模而非总参数规模。
Mamba 则是状态空间模型(SSM)路线,用随序列长度近似线性增长的递归状态替代标准注意力的二次复杂度,在长上下文场景下显存与计算开销更可控。混合 Mamba-Transformer 把 Mamba 层与少量注意力层交错堆叠,兼顾长序列效率与注意力擅长的精确检索能力,这也是两款模型强调“长上下文理解”的架构基础。
后训练管线:从 SFT 到多教师策略蒸馏
Nemotron 3.5 的后训练管线覆盖了监督微调与强化学习两大块,强化学习部分同时用了 RLVR(可验证奖励强化学习)与 RLHF。Super 在此基础上还引入了专门的教师训练和多教师在线策略蒸馏(MOPD)。
这套设计的意图很明确:把基座模型的能力"搬运"到智能体行为上,让模型能在文本、图像、视频和交互式工具环境中进行推理。换句话说,Super 不再只是一个会答题的模型,而是一个能在工具调用循环里持续作业的 agent。
RLVR、RLHF 与在线策略蒸馏
RLVR(Reinforcement Learning with Verifiable Rewards)指奖励来自可自动判定的结果,例如数学答案是否正确、代码是否通过单元测试,无需人工偏好标注,适合推理与软件工程类任务。RLHF 则依赖人类偏好数据训练奖励模型,更擅长对齐语气、有用性与安全性。两者并用,意味着既优化“答对”,也优化“答得好”。
多教师在线策略蒸馏(MOPD)指多个能力不同的教师模型对学生模型当前生成的轨迹(on-policy)实时打分并提供监督信号,而非只在固定数据集上做离线蒸馏。这样学生模型能沿自己实际分布纠正错误,是把基座能力迁移到多轮工具调用等智能体行为上的常用手段。
效率数据:更少激活参数,更高 SWE-bench Pro 得分
原文给出的几组数据值得单独拎出来看。Indic 继续预训练让印度语言基准最高提升 9.82 个百分点;智能体中期训练则增强了软件工程能力以及跨 agent harness 的鲁棒性。
最直观的对比是:后训练后的 Super 在 SWE-bench Pro 上达到 51.78%,超过了 Nemotron 3 Ultra,而激活参数大约只有后者的 1/4.6。这说明在 MoE 架构下,激活参数规模与任务表现之间的传统映射正在被训练管线和数据策略改写。
推理侧优化:投机解码与 NVFP4 量化
部署效率方面,后训练阶段的 MTP boosting 在概率性 draft sampling 下把投机解码的接受长度最多提升了 21.8%。NVFP4 量化则实现了相对 BF16 的 99.62% 中位精度恢复,意味着低精度部署的精度损失已经压到很小的范围。
推理优化在 GB200 上达到每 GPU 最高 4,856 输出 token/s,同时维持每用户至少 50 token/s 的体验下限。这组数字对智能体场景尤其关键——agent 工作负载往往是多轮、长输出、并发密集的,吞吐与单用户延迟必须同时成立。
投机解码、MTP 与 NVFP4
投机解码(speculative decoding)用一个轻量 draft 模型先草拟若干 token,再由大模型一次并行验证,接受则跳过逐 token 生成,从而在不改变输出分布的前提下提速。“接受长度”即平均每次被采纳的草稿 token 数,是核心指标。原文的 MTP(Multi-Token Prediction)boosting 指利用模型自带的多 token 预测头充当草稿来源,概率性 draft sampling 则让草稿更具多样性以提高命中率。
NVFP4 是英伟达 Blackwell 平台引入的 4 位浮点格式,采用微块缩放(micro-block scaling)在极低比特下保持动态范围。GB200 基于 Blackwell 架构,原生支持 FP4 运算,因此量化收益能直接转化为吞吐。文中“99.62% 中位精度恢复”表示量化后任务分数相对 BF16 基线在中位数上的保留比例。
测试时扩展与并行智能体
原文还提到通过并行智能体执行与自验证来探索测试时扩展(test-time scaling)。这延续了近来的一个趋势:模型能力的提升不再只靠训练阶段堆参数,推理阶段的计算编排、多路采样与自我校验同样能带来增益。对 agentic AI 而言,这条路径的性价比可能比继续放大基座更高。
测试时扩展的常见形态
测试时扩展(test-time scaling)指在推理阶段投入更多计算来换取质量提升,典型做法包括延长思维链、多路采样后投票(如 best-of-N)、树搜索,以及文中提到的并行智能体执行与自验证——让多个 agent 实例并行尝试同一任务,再由模型或验证器筛选、修正结果。其代价是延迟与成本的成倍增长,因此通常与高吞吐推理优化配合使用,在中高价值任务上才划算。
对开发者的意义
Nemotron 3.5 系列的开放属性加上混合 Mamba-Transformer 架构,给自部署场景提供了新的选项。Mamba 结构在长上下文上的计算效率优势,配合 MoE 的稀疏激活,使得 120B 级别的模型在推理成本上更接近过去小模型的部署门槛。
不过需要注意,Super 的多模态与智能体能力高度依赖其后训练管线,社区微调能否复现这些收益,目前还没有公开证据。Lightning 作为 3B 激活的文本模型,更适合作为 agent 管线中的轻量执行节点,而非主力推理引擎。
相关推荐

触屏MacBook与混乱的苹果:一场刻意为之的冒险
The Vergecast 深入讨论触屏 MacBook Pro 的发布逻辑、ProLed 命名争议、iPad 被 iPhone 与 Mac 两头挤压的困境,以及苹果在 AI 时代如何靠高端硬件维持竞争力。
研究权力50年:Robert Caro的写作与权力洞察
Robert Caro研究权力50年,在访谈中谈Lyndon Johnson的说服力与杠杆、Robert Moses从理想主义到冷酷的变迁、大规模建设的困境,以及传记写作中压缩主题与孤独专注的方法。
2万美元的机器人能替你干家务吗?实测结果令人意外
一段YouTube实测视频展示2万美元机器人如何响应洗碗、关灯、倒垃圾、喂狗等指令。本文分析其真实能力边界、语音交互技术现状,以及家务机器人距离普及还有多远。