能量模型CRAM:推理速度超循环模型千倍

CRAM用能量下降替代循环结构,训练快千倍、推理FLOPs降282倍。
文章介绍了一项以能量模型替代循环模型进行推理的研究。循环模型虽在数独、迷宫等任务上有效,但训练不稳定、耗时长、参数与计算开销大。研究者将80年代的Hopfield & Tank能量学习化,提出CRAM:对参数化能量函数做下降即可推理,无需通过迭代求解器反传梯度。实验显示,CRAM在单块GPU上训练42毫秒即解决99.996%的数独-Extreme谜题,132毫秒解决100%的迷宫-Unique谜题,训练速度比循环模型快至少1000倍,推理FLOPs减少至少282倍。能量模型还自带早停、计算量随难度自适应和可解释权重等优势。作者据此提出两点启示:能量模型是数据驱动推理的有前景方向;同时警示数独、迷宫等简单基准可能高估循环推理技术的可扩展性。
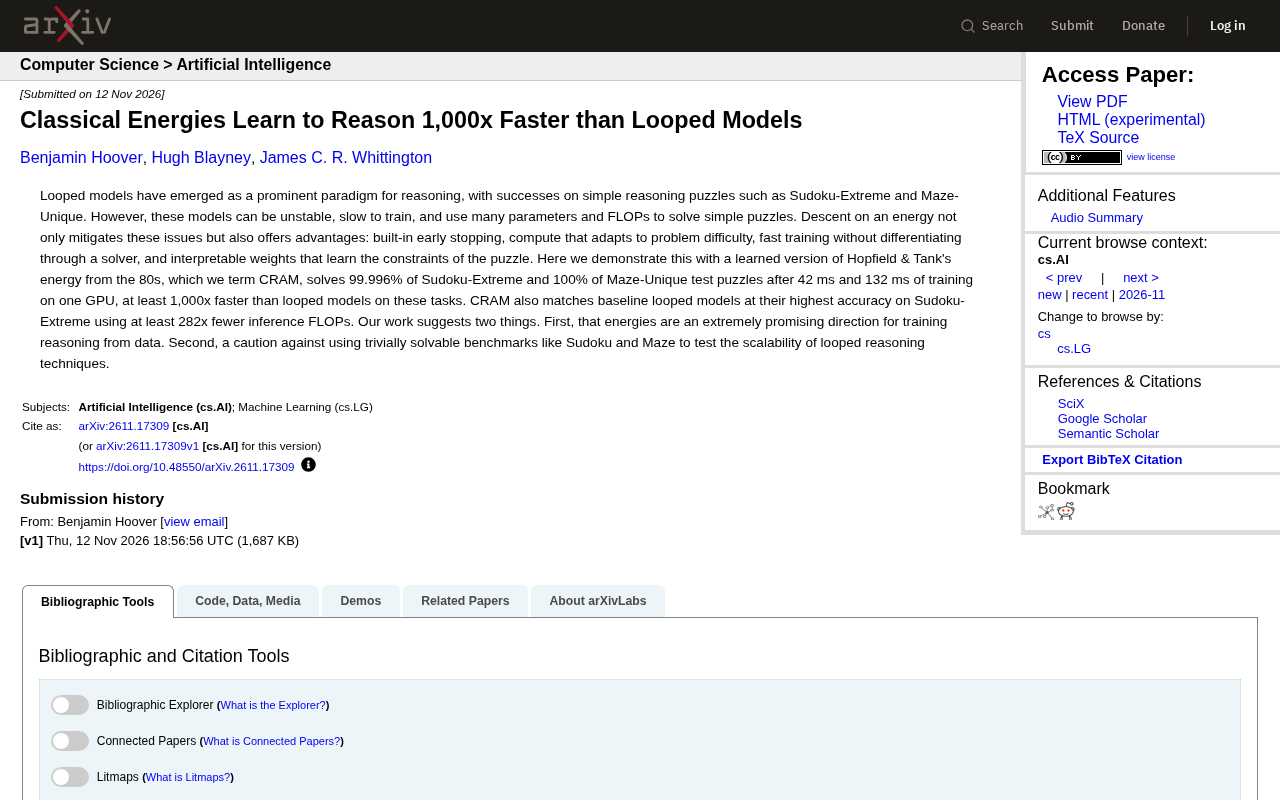
循环模型(Looped Models)在简单推理谜题(如数独、迷宫)上表现不俗,但训练不稳定、速度慢、参数和计算开销大。一项新研究提出用能量下降(Descent on an Energy)替代循环结构,并展示了基于80年代Hopfield & Tank能量的学习版本——CRAM,在数独和迷宫任务上训练速度比循环模型快至少1000倍,推理FLOPs减少至少282倍。
循环模型的瓶颈与能量模型的优势
循环模型通过迭代求解器来推理,在数独-Extreme和迷宫-Unique等任务上取得了成功,但代价高昂:训练不稳定、耗时久,且需要大量参数和FLOPs。能量模型则提供了一种新思路:对能量函数进行下降,不仅缓解了上述问题,还带来额外好处——内置早停机制、计算量随问题难度自适应、无需通过求解器微分即可快速训练,以及权重可解释(学习到谜题的约束条件)。
隐式层、深度均衡模型与“通过求解器微分”
循环模型(如深度均衡模型DEQ、通用Transformer)可视为“隐式层”:输出是某个不动点方程 z = f(z, x) 的解,而非固定层数的前馈计算。这类模型的前向传播需要迭代求解器(如Broyden法、Anderson加速)收敛,反向传播则通常依赖隐函数定理,在不动点处求解一个线性系统来获得梯度,这被称为“通过求解器微分”。该过程对求解器收敛性敏感,易出现梯度爆炸/消失或训练不稳定,且每次前向都要多轮迭代,导致FLOPs随问题难度上升。能量模型绕开了这一瓶颈:训练直接以能量为损失,推理只做能量下降,因而无需对迭代过程反传,训练可快数千倍。
CRAM:从Hopfield & Tank能量到快速推理
研究者将80年代的Hopfield & Tank能量学习化,提出CRAM。实验结果显示,CRAM在单块GPU上训练42毫秒后,解决了99.996%的数独-Extreme测试谜题;训练132毫秒后,解决了100%的迷宫-Unique测试谜题。与循环模型相比,训练速度至少快1000倍。在数独-Extreme上,CRAM达到循环模型最高准确率时,推理FLOPs至少减少282倍。
Hopfield网络与Hopfield & Tank能量
Hopfield网络是1982年由John Hopfield提出的一种递归神经网络,其动力学可视为在能量景观上的下降过程:网络状态按异步或同步更新规则演化时,一个标量“能量函数”单调不增,最终收敛到局部极小点(吸引子)。1985年,Hopfield与David Tank在此基础上提出连续时间的Hopfield-Tank网络,用模拟神经元和能量函数求解旅行商问题等组合优化任务,其能量通常由二次型项(状态间的耦合)与线性偏置项构成,并可通过增益参数调节解的“锐度”。
CRAM的关键创新在于不再手写能量函数,而是把能量参数化后用数据驱动方式学习,使能量景观的极小点对应谜题的正确解;推理时只需沿能量下降方向迭代,无需对求解器反传梯度。这也解释了CRAM为何能实现早停(能量不再下降即停)和计算量随难度自适应(简单实例更快落入极小点)。
对推理研究的启示
这项工作的意义有两层。第一,能量模型是训练数据驱动推理的极有前景的方向。第二,它警示我们:不要用数独和迷宫这类轻易可解的基准来测试循环推理技术的可扩展性。这些任务可能无法反映真实复杂场景下的推理能力,循环模型的优势或许被高估。
能量模型的这些特性——自适应计算、早停、可解释权重——使其在资源受限或需要快速推理的场景中颇具潜力。未来,研究者可能需要探索能量模型在更复杂推理任务上的表现,并重新审视循环模型的评估基准。
基准饱和与可扩展性评估
数独-Extreme与迷宫-Unique属于“组合可解”的封闭式谜题:状态空间有限、约束完全显式、正确性可精确验证,且存在经典算法(回溯搜索、最短路)可高效求解。当神经方法在这些基准上接近100%准确率时,基准即告饱和,难以区分不同方法的真实推理能力。更关键的是,此类任务的难度可通过增大网格尺寸线性提升,但不涉及开放世界知识、歧义消解或长程语义依赖,因此在其上观察到的循环模型优势未必能迁移到需要多步抽象与外部知识整合的复杂推理场景。这提示后续研究应引入更具分布外泛化压力、需要组合泛化或多模态证据融合的基准,并对计算预算进行统一核算后再比较架构优劣。
相关推荐

Gemini 4 Neon发布:前沿智能与高效任务执行的平衡之作
Google DeepMind 发布 Gemini 4 Neon,主打前沿智能与快速端到端任务执行。本文解析其在编程、企业分析、科学推理与网络安全上的基准表现、四档思考等级、定价与安全对齐数据。

AI是全球断网元凶?NSA、FAA接连宕机背后的信任危机
NSA机密网络五天内第四起重大故障,微软称软件bug、FAA否认新AI系统有关、NSA称例行维护。参议员沃纳提出AI加速漏洞发现导致仓促修复的另一种解释,而39%美国人对AI的负面看法让信任危机浮出水面。

机器人开发者自研B-rep内核,测试达3487项
机器人开发者自研B-rep几何内核并编写3,487项测试,探讨机器人领域为何需要专用CAD工具,以及自研内核的机遇与门槛。