.NET 11性能升级、Azure弹性自动化与多云数据库SDK解读

微软通过.NET 11性能复利、Azure策略驱动弹性与多云数据库统一SDK,系统性提升开发者平台默认能力。
本文梳理了微软开发者生态的四条核心动态,共同指向一个趋势:底层能力从「手工调优」走向「策略声明」。.NET 11发布覆盖JIT、PGO、SIMD等数百项运行时改进,开发者无需修改代码即可获得性能红利。Azure虚拟机规模集的自动区域放置进入公开预览,将弹性调度从手动拓扑规划转为声明式策略。面向Java的多云数据库SDK统一了Cosmos DB、DynamoDB与Cloud Spanner的访问接口,其核心难点不在于生成适配器,而在于保证跨提供商的查询语义与错误行为一致。Microsoft Foundry则开始朝生产级架构演进。四条动态共同勾勒出微软平台的抽象升级路径:将开发者从重复的底层决策中解放出来,使其专注于业务逻辑与架构意图。
微软开发者生态近期迎来一波值得开发者关注的更新。从运行时性能到云端弹性调度,再到跨云数据库抽象,几条主线共同指向一个趋势:底层能力正在从「手工调优」走向「策略声明」。本文基于YouTube频道The Upload第6期节目内容,梳理其中四条核心动态及其背后的技术逻辑。
.NET 11:性能靠「复利」而非奇招
微软发布了年度.NET性能深度报告,这次覆盖了.NET 11中的数百项改进。工作范围横跨JIT编译器、类库、内存分配、锁机制、系统调用、SIMD指令以及基于配置文件的优化(Profile-Guided Optimization,PGO),其中包括更多去虚拟化(de-virtualization)和内联热代码路径的机会。
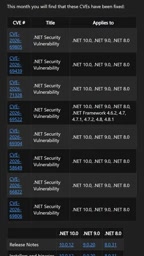
这些运行时层面的改进有一个关键特点:无需修改代码即可加速现有应用。对于已经部署的服务,仅升级运行时就能获得可测量的性能提升。同时,微软提供了可复现的基准测试方法,让性能工程师能够在自己的硬件和真实工作负载上对比.NET 10与.NET 11。
这里体现的是微软的运行时策略哲学:性能很少来自某一次戏剧性的优化,而是让技术持续「复利」——在整个技术栈上积累小的胜利,直到普通的应用代码变得明显更快。这种做法对企业级用户尤其友好,因为它降低了升级门槛,把收益变成了近乎「免费」的红利。
Profile-Guided Optimization(PGO) 是一种通过收集程序运行时的实际行为数据来指导编译器优化的技术。传统的静态编译器只能依靠代码结构做出优化决策,而PGO先让程序在真实或典型负载下运行一遍,记录哪些代码路径被频繁执行、哪些分支预测最常命中,再用这些「热点档案」重新编译,使热路径获得更激进的内联展开和寄存器分配。.NET的动态PGO(Dynamic PGO)在运行时持续采样,无需离线训练阶段,这让它对长期运行的服务尤为有效——应用运行越久,JIT积累的数据越多,优化效果就越接近提前采集好档案的静态PGO。去虚拟化(de-virtualization) 则是PGO的重要下游收益:当运行时数据表明某个虚方法调用点实际上总是调用同一具体类型时,JIT可以将其替换为直接调用甚至直接内联,消除虚函数分派的开销,并为进一步的常量折叠打开窗口。
Azure自动区域放置:弹性从拓扑走向策略
Azure虚拟机规模集(Virtual Machine Scale Sets)的自动区域放置功能进入公开预览。Azure可以基于SKU可用性、当前容量、规模集分布以及开发者定义的约束条件,自动选择可用区。
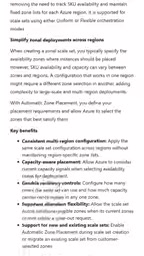
该功能同时支持统一(uniform)和灵活(flexible)两种编排模式,并且能够部分满足扩容请求,而不是在容量不足时直接让整个请求失败。这意味着开发者可以使用统一的区域部署模式,而无需为不同区域硬编码各自的可用区列表。容量感知的放置与自动再平衡,也进一步减少了弹性自动扩缩背后的运维工作量。
更深层的变化在于范式转移:云弹性正从静态拓扑转向策略驱动。过去开发者需要精确规划每个可用区的分布,如今则是声明期望达到的可用性结果,由Azure根据容量的实时变化持续做出放置决策。控制权从「配置细节」上移到了「表达意图」,这与基础设施即代码之后的又一次抽象层次跃迁一脉相承。
可用区(Availability Zone) 是同一云区域(Region)内物理上相互隔离的数据中心分组,每个区拥有独立的电力、制冷和网络,确保单区故障不会影响其他区的工作负载。传统的高可用架构要求开发者手动将虚拟机或副本平均分布在多个可用区,并在每个区预先指定精确的实例数量——这在云提供商某一区容量紧张时会导致部署请求整体失败。虚拟机规模集(Virtual Machine Scale Sets,VMSS) 是Azure的托管实例组服务,支持按需自动增减虚拟机数量。其中「统一模式」用相同镜像批量管理实例,适合无状态水平扩展;「灵活模式」允许混合不同配置的实例,适合更复杂的拓扑需求。自动区域放置将容量感知决策从开发者侧转移到平台侧,使规模集能够在多区之间动态寻优,并在容量不足时优先完成可满足的部分,而非直接拒绝整个请求。
多云数据库SDK:难点不在适配器,而在语义一致
微软面向Java的多云数据库SDK也进入公开预览。它提供了一套统一的CRUD与查询API,可以跨Azure Cosmos DB、Amazon DynamoDB和Google Cloud Spanner使用。数据库提供商的选择被下放到配置层,而适配器负责查询翻译、错误归一化、诊断信息、兼容性检查以及跨提供商的一致性测试。
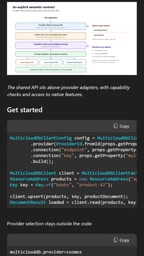
可移植性远比「把三个客户端包装在一个接口后面」要难。分页、限流(throttling)、部分失败以及查询语义都必须保持一致,否则抽象就会在边缘情况下崩溃。这个共享契约让团队能够一次性验证行为的正确性,同时保留调用原生能力的「逃生通道」(escape hatch)。
节目主持人Cameron给出了一个颇具洞察的判断:随着代码生成变得越来越廉价,经过测试的抽象反而更加值钱。困难之处不再是产出适配器本身,而是证明每一个适配器所表达的含义都是一致的。这也解释了为何微软强调跨提供商的一致性测试——它才是这类多云抽象真正的护城河。
Azure Cosmos DB、Amazon DynamoDB 和 Google Cloud Spanner 在数据模型与一致性保证上存在根本性差异,这正是统一抽象的难点所在。Cosmos DB 是文档型多模数据库,支持可调一致性级别(从最终一致到强一致),分区键决定数据分布;DynamoDB 是键值/文档混合模型,以预置或按需吞吐量为核心资源单位,条件写入和事务语义与其他两者差异显著;Cloud Spanner 则是分布式关系型数据库,提供外部强一致性和完整的SQL支持,但分片方式与扩展模型与NoSQL系统截然不同。三者在分页游标格式、限流错误码、部分事务失败的处理方式以及查询过滤能力上均不一致。统一SDK必须在这些差异之上建立可预期的行为契约,否则开发者在切换提供商时将遭遇难以复现的边缘情况,抽象层反而成为排障的障碍而非助力。
Microsoft Foundry走向生产级架构
节目同时提到Microsoft Foundry开始认真对待生产环境的架构设计。虽然本期内容对此着墨不多,但结合前面几条动态可以看出,微软正在把AI应用的开发从实验阶段推向可靠、可运维的生产部署,与运行时性能、云弹性、数据可移植性这些「基础设施成熟度」指标形成合力。
一条贯穿的主线
把这四条动态放在一起看,可以提炼出一个共同信号:微软开发者平台正在系统性地提升「默认能力」。运行时让代码免费变快,Azure让弹性变成声明式策略,数据库SDK让多云可移植性有了可验证的契约。开发者被从大量重复的底层决策中解放出来,得以把精力集中在业务逻辑与架构意图上。对于评估技术栈演进方向的团队而言,这些看似分散的更新,实则勾勒出一条清晰的抽象升级路径。
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。