NeuroHive:四Agent蜂群与沙箱执行的开源Python编排器
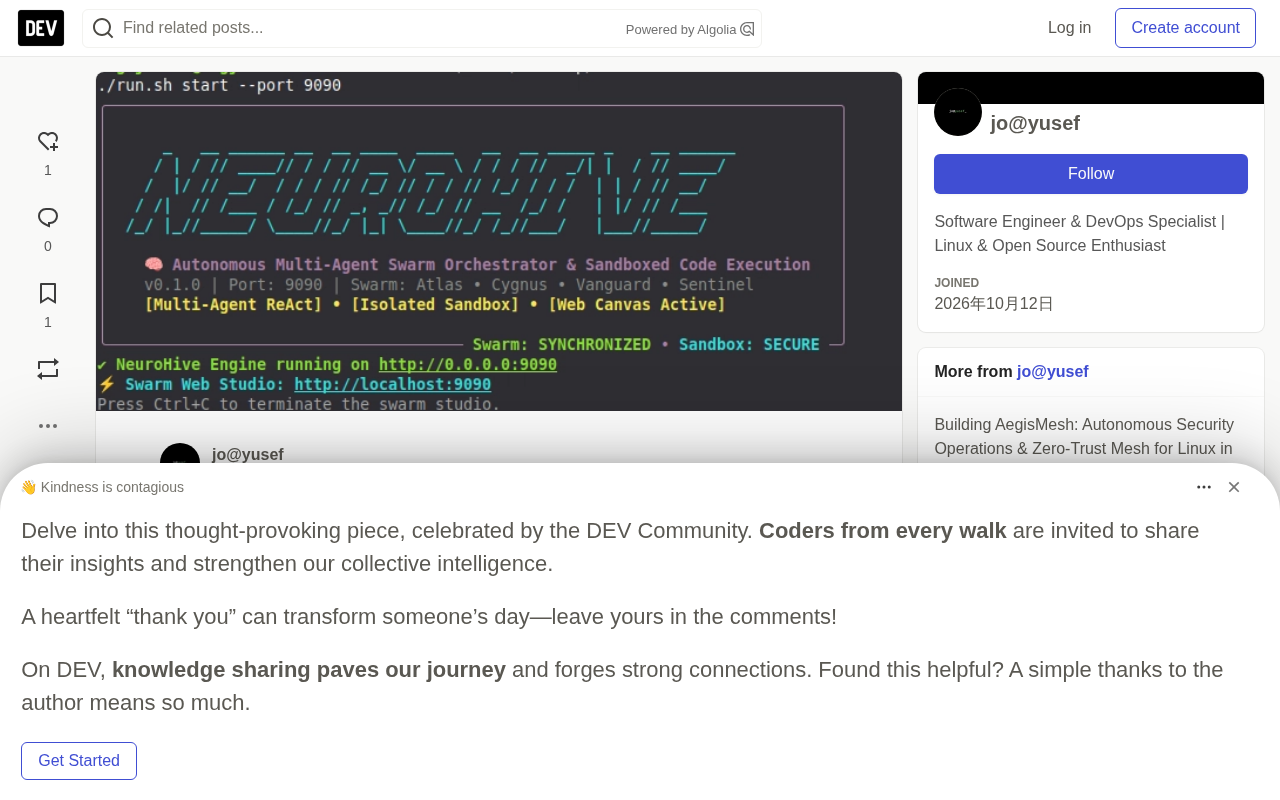
NeuroHive 用四Agent接力与隔离子进程沙箱,构建开源多Agent代码编排器。
NeuroHive 是一个基于 Python 的开源多Agent蜂群编排器,把工程任务拆给四个角色接力完成:Atlas 负责架构设计,Cygnus 产出可运行代码,Vanguard 做静态安全审计,Sentinel 在隔离子进程中带超时与内存限制执行。这种“生成与信任分离”的设计形成双层防线,但作者也客观指出其隔离属于工程级防护而非虚拟机级强隔离,静态审计对逻辑层隐患无能为力。项目附带 Cyberpunk 风格的 Web Studio,实时可视化 Agent 通信与代码生成,提升多Agent系统的可观测性。技术栈精简,原生整合 Python、WebSockets 与 Linux 子进程原语,MIT 许可证开源,三条命令即可本地启动。其定位是可观察、可隔离的协作骨架,适合实验与二次改造,生产使用前仍需针对自身场景验证。
NeuroHive:四Agent蜂群与沙箱执行的开源Python编排器
让多个AI Agent在真实系统上自主生成、审查并运行代码,安全性和稳定性一直是绕不开的坎。开源项目 NeuroHive 给出了一个值得拆解的答案:一个用 Python 搭建的多Agent蜂群编排器,外加一个带隔离沙箱的代码执行Studio。
四Agent分工:从架构到执行的角色链
NeuroHive 的核心设计是把一项工程任务拆开,交给四个职责明确的自主Agent接力完成:
- Atlas(系统架构师):负责拆解复杂目标、设计算法蓝图、确定执行流程。
- Cygnus(首席工程师):按照架构产出可直接运行的、经过优化的 Python 代码。
- Vanguard(安全审计员):执行静态安全检查,扫描不安全的系统调用,拦截潜在的恶意载荷。
- Sentinel(执行引擎):把通过校验的代码放进隔离的子进程运行时里执行,并施加严格的超时与内存边界。
这个分工链的价值在于把"生成"和"信任"拆成了两个环节。多数Agent编码工具默认模型输出的代码是可以直接运行的,NeuroHive 则在中间插入了一道 Vanguard 审计,再用 Sentinel 做运行时隔离,形成双层防线。
沙箱执行:多Agent系统的安全底座
项目作者在介绍中明确点出了一个现实问题:多Agent蜂群在宿主机上自主生成、审查并执行代码,会带来显著的安全、稳定与编排挑战。Sentinel 的设计正是对这个问题的直接回应——执行只发生在隔离的子进程中,配合超时控制和内存守卫,避免失控代码影响宿主环境。
需要客观看待的是,这种基于 Linux 子进程原语的隔离属于"工程级防护",而非虚拟机或容器级强隔离。它能有效限制执行时长和资源占用,降低误操作风险,但面对刻意构造的逃逸攻击,防护强度取决于具体实现细节。把它当作一道可靠的第一层防线是合理的,当作绝对安全边界则言过其实。
安全审计层能挡什么
Vanguard 的静态检查主要覆盖不安全系统调用和明显的恶意载荷模式。这类检查对常见风险有过滤作用,但对逻辑层面的隐蔽问题无能为力。实际使用中,把它理解为"代码上线前的自动代码审查"更贴切:能减少低级错误,不能替代人工判断。
Linux 子进程原语指 fork、exec、setrlimit、chroot、命名空间等由操作系统内核直接提供的能力。与容器(依赖 cgroups 与 namespace 组合)和虚拟机(依赖硬件虚拟化)不同,子进程隔离只共享同一内核,边界更薄:它能限制 CPU 时间、内存上限、打开文件数,却难以完全阻断对文件系统或网络的访问,除非额外叠加 seccomp 过滤系统调用。这也解释了为何文中把 Sentinel 定位为“工程级防护”——其实际强度高度依赖具体实现是否组合了资源限制、权限降级与系统调用白名单。
静态安全检查与运行时防护是两条互补路径。静态检查在代码执行前分析源码,常见手段包括 AST 解析、危险函数黑名单(如 os.system、subprocess、eval)和模式匹配,优点是零运行开销、可提前拦截;缺点是难以应对字符串拼接、动态导入、混淆等规避手法,也无法判断业务逻辑是否正确。运行时防护(如 seccomp、审计日志)则在实际执行中拦截,能覆盖静态分析漏掉的动态行为,但代价是性能开销与更复杂的策略配置。两者叠加才能形成较完整的防线。
Cyberpunk 风格的实时可视化 Studio
NeuroHive 提供了一个 Web 端 Studio 界面,实时展示 Agent 之间的通信、思考推进过程和代码生成状态。对于多Agent系统来说,可观测性往往比功能本身更重要——蜂群内部的协作是黑盒时,出了问题很难定位是哪一环的决策跑偏。把 Agent 通信可视化,等于把黑盒打开了一条缝。
技术栈上项目走的是精简路线,原生整合了 Python、WebSockets、JavaScript/HTML5 前端和 Linux 子进程原语,没有引入重型框架。这种"零臃肿"的取向也让本地部署成本降得很低。
多Agent系统的可观测性通常包含三个层次:轨迹(trace),即每个 Agent 的输入、输出与工具调用序列;指标(metrics),如 token 消耗、任务耗时、失败率;日志(logs),记录异常与决策依据。Agent 间通过消息传递协作时,若缺少统一的追踪 ID 串联,一次失败往往难以定位到具体环节。WebSocket 之所以适合这类场景,是因为它提供全双工长连接,服务端可在 Agent 状态变化时主动推送,无需前端轮询,从而支撑接近实时的通信流展示。
60秒内启动:部署门槛极低
NeuroHive 采用 MIT 许可证,完全免费开源,启动只需几条命令:
git clone https://github.com/EngJoDev/neurohive.git
cd neurohive
chmod +x run.sh
./run.sh start --port 9090
克隆仓库、赋予脚本执行权限、指定端口启动,三步即可在本地跑起来,对想动手实验多Agent编排的开发者来说门槛相当友好。
MIT 许可证是最宽松的开源协议之一,允许使用者自由修改、分发、商用甚至闭源再发布,唯一要求是保留原始版权声明与许可文本声明。对希望把 NeuroHive 改造成内部工具或嵌入商业产品的团队而言,这意味着几乎没有法律摩擦。需要注意的是,许可证只覆盖项目代码本身,Agent 背后调用的模型 API 仍受各自服务条款约束,涉及数据留存与费用计费的部分需另行评估。
多Agent自主编程的定位与边界
NeuroHive 的定位不是替代开发者,而是提供一套可观察、可隔离的多Agent协作骨架。四个Agent的角色链给出了一种清晰的工程范式:规划、实现、审计、执行各归其位,每一环都有明确的输入输出。
对想要研究Agent协作机制、或者需要在安全边界内运行AI生成代码的开发者,这个项目提供了可直接改造的起点。同时也要认清,沙箱强度和审计覆盖度都还有讨论空间,生产环境使用前值得做一轮针对自身场景的验证。
相关推荐
OpenAI停止用实时互联网训练AI模型,称存在重大风险
OpenAI宣布不再使用实时互联网数据训练前沿AI模型,称存在重大风险。本文分析这一策略转变背后的安全考量、工程现实及对AI行业的潜在影响。

创业公司获客真相:病毒式传播并非成功必经之路
TechCrunch Disrupt上创始人与VC指出,创业公司不必追求病毒式传播获客。文章分析早期关注与长期用户的区别、可持续增长指标,以及创始人应如何转向社区运营与用户留存。
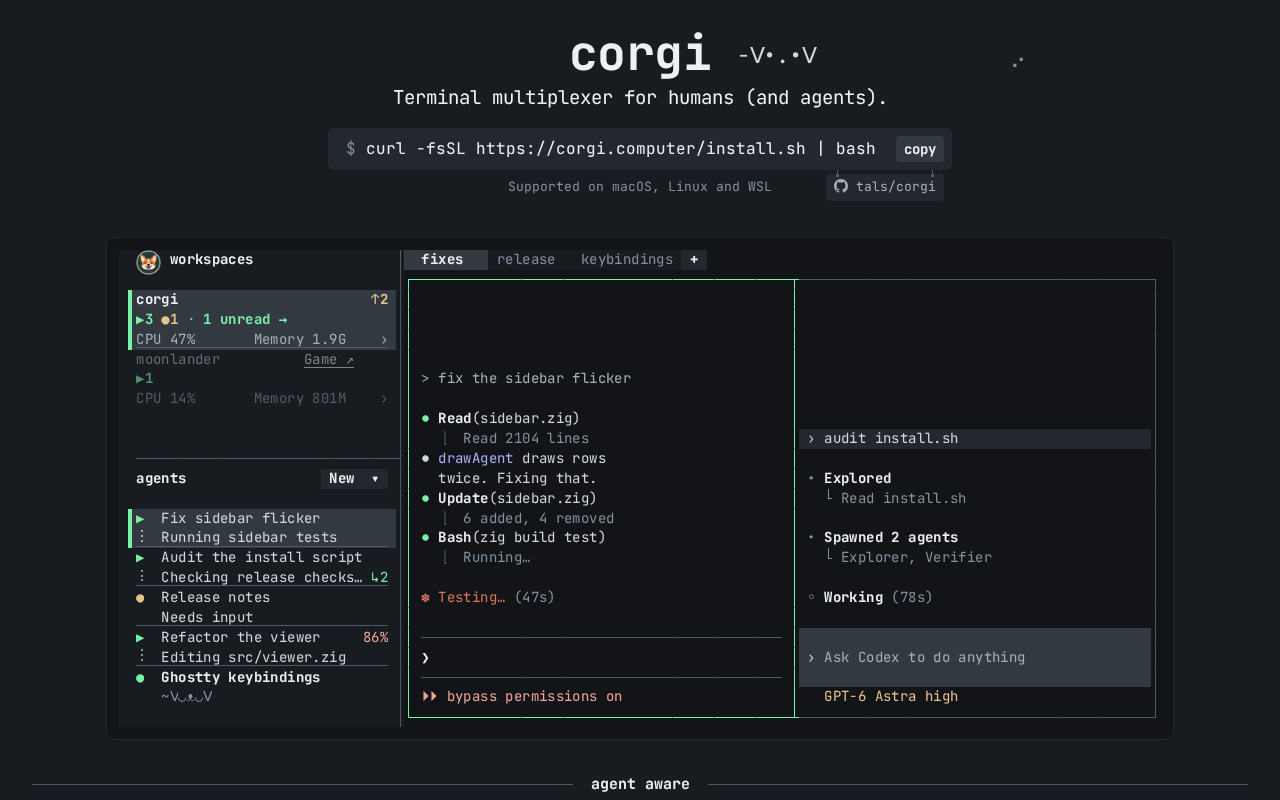
Corgi:面向AI代理的终端复用器
Corgi 是一个在 Hacker News Show HN 发布的新项目,定位为面向 AI 代理与终端的复用器,试图解决多个编码代理并行运行时的会话管理问题。本文分析其定位、潜在价值与早期阶段的风险。