NVIDIA DSX AI Factory:运行时AI资产清单如何验证GPU平台
NVIDIA指出静态配置清单已不够用,需以运行时AI资产清单保障GPU平台可见性与验证。
文章围绕NVIDIA开发者博客提出的观点展开:当数十个团队、上百个AI作业共享同一套GPU集群时,平台对「实际在跑什么」的可见性成为新瓶颈。静态配置清单只记录部署意图,无法反映镜像替换、驱动升级、推理后端切换等运行时变化,在Dynamo推理与Kubeflow训练混部场景下尤其失真。NVIDIA的解法是采集运行时AI资产清单,并将其纳入DSX AI Factory的平台验证流程,使GPU算力交付具备可复现、可核验的依据。文章进一步指出Dynamo、Kubeflow、Slurm三种编排栈带来差异化的采集需求,并强调清单需由平台团队与算法团队共同维护,建议将运行时对照纳入日常运维而非一次性验收。
当AI工作负载规模化后,平台可见性成为新瓶颈
在GPU平台上跑起第一个训练任务并不难,难的是当数十个团队、上百个作业同时在一套集群上运行时,你还能准确说清楚「此刻究竟有哪些模型在跑、用的是哪套推理框架、占用了哪些GPU资源」。NVIDIA在开发者博客中给出的判断很直接:随着团队借助NVIDIA Dynamo、Kubeflow或Slurm部署并扩展AI工作负载,追踪实际运行内容的可见性需求已经超出了平台本身的提供能力。
这并不是运维层面的老问题换了个说法。传统集群监控关注的是节点在线率、GPU利用率和显存占用,而AI工作负载引入了一层额外的复杂性:模型版本、推理运行时、框架组合以及它们之间的依赖关系,都会影响平台是否被正确配置、是否能稳定承载生产流量。NVIDIA提出的思路是把这些信息作为「运行时AI资产清单」来采集,并通过DSX AI Factory的方法论对GPU平台进行验证。

为什么静态配置清单不够用
平台状态与工作负载状态的错位
集群部署时生成的配置清单是静态的,它记录的是「按照设计,这台机器应该装了什么」。但在实际运行中,镜像会被替换、驱动会被升级、容器里跑的推理服务会切换后端,配置清单很快与现实脱节。运行时的AI资产清单补的正是这个缺口——它采集的是当前实际在运行的对象,而不是部署时的意图。
这种错位在混部场景下尤其明显。同一个GPU节点上可能同时承载Dynamo的推理任务和Kubeflow的训练流水线,两者的资源诉求和运行时依赖并不一致,静态清单无法反映这种动态叠加的关系。
验证环节的价值
把运行时清单用于平台验证,意味着团队可以拿实际运行状态去对照预期基线,判断平台是否仍处于可复现、可交付的状态。这对AI工厂这类把GPU算力当作生产资源对外供给的场景很关键:交付给内部客户的不能只是一个「理论上配好了」的平台,而应当是一个经过运行时核验、能说明当前承载了哪些AI工作负载的环境。
Dynamo、Kubeflow与Slurm的定位差异
文中反复出现的三个名字代表了AI工作负载编排的三个层次。NVIDIA Dynamo是面向推理服务的分布式运行时,负责把大模型请求调度到多节点GPU上并做KV缓存复用;Kubeflow是构建在Kubernetes之上的ML工作流平台,把训练、调参、流水线编排容器化;Slurm则是传统高性能计算领域广泛使用的批处理作业调度器,在训练集群中仍占据主流。三者的资源抽象粒度不同:Dynamo以模型实例为单位,Kubeflow以Pod和Pipeline为单位,Slurm以作业和分区为单位。这种差异直接导致「运行时资产清单」在不同栈上需要采集的字段和关联关系各不相同,也是统一可见性难以用一个工具解决的根本原因。
配置漂移(Configuration Drift)
验证环节要对抗的核心问题是配置漂移:系统在部署后因人为变更、自动升级或依赖更新而逐渐偏离预期基线的现象。在GPU平台上,漂移的表现形式包括驱动版本不一致、CUDA/cuDNN组合错配、推理后端被替换、容器镜像标签指向了新内容等。漂移本身未必是错误,但它会让「平台是否达标」的判断失去依据——同一份基线在不同时间点上可能对应完全不同的实际状态。运行时清单的价值在于把漂移从隐性变为显性,使团队能够区分有意变更与意外偏离,并在扩缩容或升级之后确认平台仍处于可复现状态。
运行时清单在AI工厂中的定位
NVIDIA把这项工作放在DSX AI Factory的框架下讨论,指向的是一套从平台构建到运行验证的完整链条。AI工厂的核心命题是让GPU算力像工业产能一样可被规划、调度和计量,而要做到这一点,前提是知道产线上正在生产什么。运行时AI资产清单承担的就是这个「产线台账」的角色。
对使用Dynamo做推理服务化的团队来说,清单能回答诸如哪些模型正在被服务、对应哪些运行时实例这类问题;对用Slurm管理批处理训练任务的团队,清单则帮助厘清作业与硬件资源的实际映射。Kubeflow场景下,容器化的流水线让资源归属更细碎,运行时采集的必要性也随之上升。
说个细节,NVIDIA在原文中并未展开清单的具体采集机制与字段定义,更多是把「运行时可见性」作为一个待解决的问题提出,并把它纳入DSX AI Factory的验证流程中。这也意味着落地时仍需结合具体平台的采集能力做适配。
DSX AI Factory 是什么
DSX是NVIDIA提出的一套面向「AI工厂」的参考架构与方法论,目标是把GPU集群当作可规划、可调度、可计量的生产设施来建设和运营,而非零散的项目制实验环境。它覆盖从数据中心设计、GPU选型、网络与存储配置,到平台验证和运行期管理的完整生命周期。在这一框架下,验证不是一次性验收,而是贯穿平台交付与运营的持续动作。运行时AI资产清单之所以被纳入DSX流程,是因为AI工厂的计量与调度前提是准确掌握产线上正在运行的工作负载身份——没有这份台账,算力供给方就无法向内部客户说明资源去向,也无法做容量规划。
对平台团队的实践启示
把运行时清单纳入日常运维节奏,比把它当作一次性的验收动作更有价值。平台团队可以据此建立持续对照机制:定期采集运行时状态,与基线配置比对,发现漂移后及时归因。这种做法在扩缩容、驱动升级和框架版本切换之后尤其必要。
另一个启示是清单的归属问题。运行时资产清单横跨基础设施与AI应用两层,既需要平台团队提供采集能力,也需要算法团队配合标注工作负载身份。如果两边各自维护一份口径不同的记录,清单本身的验证价值就会被削弱。NVIDIA把这个问题放在AI工厂语境下讨论,实际上是在提示:GPU平台的验证不只是硬件层面的验收,还包括对运行其上的AI资产的持续盘点。
对于正在把GPU集群从实验环境推向生产环境的团队,这套思路提供了一个可操作的抓手——先让运行时状态变得可观测、可对照,再谈平台是否达标。
相关推荐
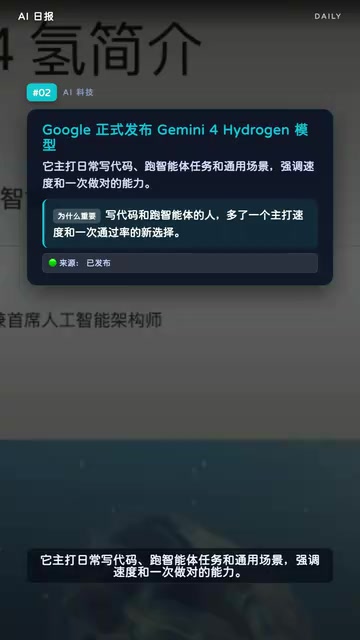
Google发布Gemini 4 Hydrogen:速度与代码生成成核心卖点
Google发布Gemini 4 Hydrogen模型,主打速度与代码一次作对能力;智能体可代付账单、开Google Ads账户;百度上线模型交易平台磁源锁,阿里714旗舰升级,开源270亿参数机器人模型Prince GE开放商用。
Gemini 4 Hydrogen长测:官方2.5倍速,3D打印成最大惊喜
Gemini 4 Hydrogen全套长测:定价5.5/7美元每百万tokens,官方称快2.5倍,实测3D打印STL文件质量惊艳,可无支撑打印,整套高强度测试仅消耗4%周配额。

AI时代程序员就业指南:转型路径与具身智能机会
AI时代程序员如何转型?本文基于B站职业规划直播,解析不拥抱AI的风险、Web Coding到FDE的转型路径、具身智能的数据瓶颈与大模型对研究岗位的影响,给出校招社招可操作的求职与学习顺序。