NVIDIA DSX POD:让AI算力更快落地

NVIDIA DSX POD 以标准化交付单元应对 AI 工厂上线前的系统集成瓶颈。
文章解读 NVIDIA 开发者博客提出的 DSX POD 方案,指出 AI 工厂的本质是把电力转化为智能,真正的瓶颈不在单卡性能,而在计算、网络、存储、供电与制冷等系统的集成调优。DSX POD 以“一整套可运行系统”为交付颗粒度,把集成工作前置到设计与验证阶段,从而缩短上线周期并降低交付不确定性。文章也提醒,原文仅停留在理念与定位层面,未披露具体规格、性能数据与交付周期,标准化虽提升容量规划可预期性与故障域清晰度,但可能牺牲定制化灵活性,实际效果仍需落地数据验证。
AI 工厂的本质,是把电力转化为智能。但在产出第一个 token 之前,运营团队需要先把计算、网络、存储、供电、制冷等一整套互相牵连的系统调试到可用状态。NVIDIA 在其开发者博客中提出的 DSX POD,正是瞄准这个「上线前的混沌期」,试图让生产级 AI 容量以更快、更可预测的方式交付。
AI 工厂的真正瓶颈不在芯片
NVIDIA 在原文中给出了一个形象的定位:AI 工厂把能源变成智能。这句话背后是一个容易被低估的事实——单卡性能再强,也不等于集群能跑出有效吞吐。
一个 AI 工作负载要开始产出结果,前提是计算、互联网络、存储、供电与散热形成一套彼此协调的系统。任何一环配置失当,都会在训练或推理时表现为利用率下降、任务排队、故障频发。换句话说,瓶颈往往不在芯片本身,而在系统集成与调优的时间成本上。
原文强调的目标是「更快、更可预测」(faster and more predictably)。这两个词指向不同的问题:更快是缩短从硬件到达到业务上线之间的周期;更可预测是降低交付过程中的不确定性,让容量规划、上线时间、性能表现都有可预期的基线。
“有效吞吐”是衡量集群实际产出能力的指标,通常指在真实工作负载下单位时间内完成的有效计算量(如训练时的样本处理速率、推理时的 token 生成速率),而非硬件标称的峰值算力。二者之间存在显著差距,原因在于分布式训练与推理需要频繁的跨节点通信、数据加载与检查点写入,任何环节的延迟或带宽不足都会让 GPU 处于等待状态,表现为利用率(utilization)下滑。业界常用 MFU(Model FLOPs Utilization,模型浮点运算利用率)来量化这一差距,生产环境的 MFU 往往远低于理论峰值。因此评估 AI 工厂时,系统级的有效吞吐比单卡跑分更具参考价值。
DSX POD 试图标准化什么
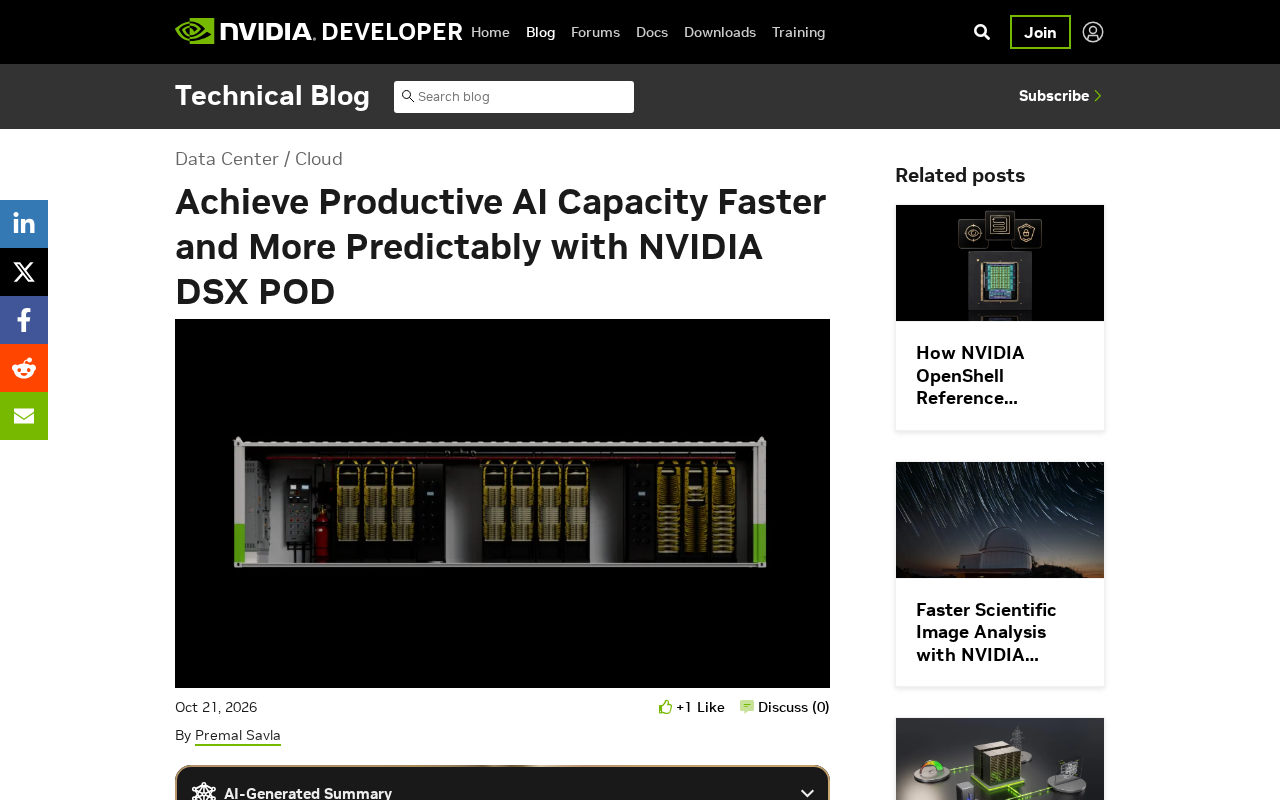
从 NVIDIA 的表述看,DSX POD 的定位是一套面向生产级 AI 容量的参考架构与交付单元,而非单纯的硬件清单。它把「一整套可运行的 AI 系统」作为交付颗粒度,从而把原本需要逐项调优的集成工作前置到设计与验证阶段。
这种思路的价值在于把不确定性从部署现场转移到设计阶段。传统做法中,团队往往在机房现场才发现网络拓扑、供电余量或散热能力与预期不符,返工代价高昂。以 POD 为单位交付,意味着这些约束在设计时就被考虑进去,现场工作更多是装配与验证,而非试错。
需要注意的是,原文提供的信息集中在理念与定位层面,并未公开具体的配置规格、性能数字或交付周期数据。因此对 DSX POD 的评估应保持谨慎,不宜据此推断具体性能提升幅度。
参考架构(Reference Architecture)是指厂商给出的一套经过验证的设计蓝图,规定计算、网络、存储、供电、制冷各子系统如何选型与组合,但不等于强制捆绑销售的成品。其作用是让客户与集成商在此基础上做工程落地,减少从零设计带来的兼容性风险。与之相近的概念是“交付单元”(delivery unit)——把一组预先集成、测试过的设备作为一个整体交付和扩容,类似集装箱化思维。POD(Point of Delivery)一词在数据中心领域常指一个模块化的基础设施单元,具备独立的供电与制冷边界,可独立部署、独立扩容,这也是理解 DSX POD 定位的关键背景。
对运营团队意味着什么
如果 DSX POD 的标准化路径成立,最直接的受益者是负责 AI 基础设施落地的运营与平台工程团队。他们的工作重心会从「让系统跑起来」转向「让系统跑得高效」。
这带来两个现实影响。其一是容量规划的可预期性提升:当交付单元有明确边界,扩容可以按单元叠加,而不是每次重新评估整机房的承载能力。其二是故障域的界定更清晰,运维排障时能更快定位问题所在的子系统。
不过,标准化也意味着灵活性上的取舍。对高度定制化的工作负载,标准化 POD 是否仍能匹配需求,原文没有给出答案,这需要在真实部署中检验。
“故障域”(fault domain)指系统中一个故障所能影响的最大范围。在 AI 集群中,故障域划分得越清晰,单点故障的传播范围就越可控,运维人员也能依据故障现象快速缩小排查范围。以 POD 为单元交付时,供电、制冷、网络通常按单元隔离,某个 POD 内的交换机或配电故障不会波及其它单元,从而提升整体可用性。与之配套的概念是“ blast radius ”(爆炸半径),即故障影响面;标准化单元的价值之一就是把爆炸半径限制在已知边界内,这对大规模训练任务的连续性尤为重要。
值得关注的几个问题
围绕这类「AI 工厂」方案,有几个问题值得持续跟踪。交付周期能否真正缩短,取决于供应链与现场施工的协同,而不只是架构设计。可预测性是否可量化,需要厂商给出可对比的基线指标。此外,标准化单元与异构工作负载之间的适配度,也决定了这套方案适用的边界。
对正在规划 AI 基础设施的团队而言,DSX POD 提供的思路值得借鉴:把系统集成当作一等公民来设计,而不是留给部署阶段去解决。至于这套方案能否兑现「更快、更可预测」的承诺,还需等待更多落地数据。
相关推荐

空陆两栖变形无人机:除了省电100倍,还有什么真需求?
空陆两栖变形无人机是否只是噱头?从M4 Morphobot的100倍功耗差异出发,探讨变形无人机的真实应用场景与论文选题思路,分析纯无人机和纯地面机器人均失效的边界条件。

Warhound融资2亿美元:基因工程“战犬”搭配Anduril装备
Warhound完成2亿美元融资,由Ben Lamm和Palmer Luckey推动,通过基因工程改造犬类用于军事和执法,并搭配Anduril装备。本文分析其技术方向、融资逻辑与伦理争议。

Claude API登陆Google Cloud:IAM集成与SDK接入指南
Anthropic将完整Claude API托管在Google Cloud上,通过Google Cloud IAM控制权限并统一计费。本文梳理Vertex AI与Anthropic托管两个服务入口、IAM角色配置要点及SDK接入方式,帮助企业复用现有云治理框架引入Claude模型。