NVIDIA Dynamo KV路由实战:智能路由配置降低TTFT 40%

NVIDIA Dynamo 的 KV 感知路由通过成本函数将请求导向缓存命中率更高的 worker,可将 TTFT 降低 30-40%。
本文系统梳理了 NVIDIA Dynamo 推理框架中 KV Router 的配置与实践。KV 感知路由基于成本函数(预填充块与解码块的加权和)评估各 worker,将请求定向到缓存复用率最高的节点,相比轮询负载均衡可降低 TTFT 30-40%、提升吞吐 25-30%。文章详细讲解了环境准备(etcd、NATS 与容器镜像)、核心参数调优(DYN_KV_OVERLAP_SCORE_WEIGHT 与 DYN_ROUTER_TEMPERATURE 的取舍)、聚合式与分离式两种部署模式的区别,以及 vLLM、SGLang、TensorRT-LLM 多后端下的统一配置方法与预测模式的回退方案。
NVIDIA Dynamo KV路由实战:智能路由配置降低TTFT 40%
NVIDIA Dynamo 是一个开源的高吞吐、低延迟推理框架,专为在多节点、多GPU环境中部署大规模生成式AI和推理模型而设计。其核心组件 KV Router 通过评估各worker的计算成本来智能分配推理请求。根据官方数据,相比传统的轮询负载均衡,KV感知路由可将首Token延迟(TTFT)降低高达40%,整体吞吐量提升25-30%。
本文基于Vultr文档发布的实践指南,完整梳理Dynamo智能路由的配置流程、参数调优策略与验证方法,覆盖聚合式和分离式两种服务模式。
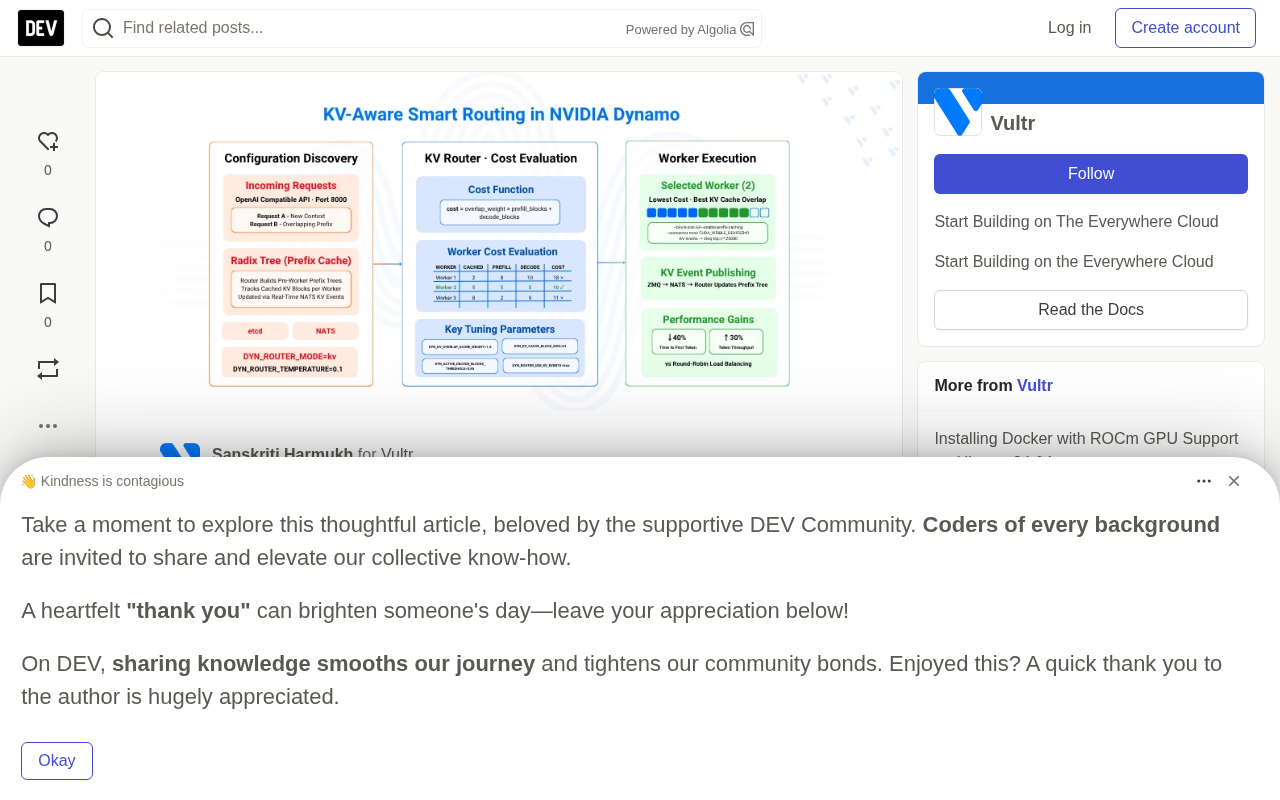
KV感知路由的工作原理
传统负载均衡策略(如轮询或随机路由)将请求均匀分配到各worker,但不考虑worker的缓存状态。KV感知路由则通过判断哪些worker已缓存相关KV块,将请求定向到缓存命中率更高的节点,从而减少预填充阶段的计算量。
成本函数与路由决策
KV Router基于一个统一的成本函数做出路由决策,该函数平衡两个关键因素:
预填充成本衡量worker需要从头处理的token数量。当worker缓存了与请求输入前缀匹配的KV块时,这些块可以复用,预填充计算量随之降低:
Prefill blocks = (Total input tokens - Cached tokens) / Block size
解码成本则跟踪每个worker上的活跃块数量,以估算解码容量。活跃序列更少的worker自然有更多余力接收新请求。
两者合并为最终成本公式:
cost = overlap_score_weight × prefill_blocks + decode_blocks
其中 overlap_score_weight 控制TTFT优化与负载分配之间的权衡。默认值为1.0,成本越低代表路由选择越优。
实际选择过程
假设有3个worker,overlap_score_weight = 1.0,路由决策如下:
| Worker | 缓存块 | 预填充块 | 解码块 | 总成本 | 是否选中 |
|---|---|---|---|---|---|
| Worker 1 | 2 | 8 | 10 | 18 | 否 |
| Worker 2 | 5 | 5 | 5 | 10 | 是 |
| Worker 3 | 8 | 2 | 9 | 11 | 否 |
Worker 2在缓存复用和可用容量之间取得了最佳平衡。这套机制在长输入提示(超过2000 token)、请求间存在相似前缀、以及多worker各自维护独立KV缓存的场景下收益最为显著。
KV Cache 与预填充阶段的代价:在大语言模型推理中,Transformer 的自注意力机制需要为每个已处理的 token 保存 Key 和 Value 向量,这批存储即 KV Cache。当请求进入时,模型必须先对全部输入 token 执行一次前向计算来填充 KV Cache,这一阶段称为预填充(prefill);随后才逐 token 生成,进入解码(decode)阶段。预填充的浮点运算量随输入长度近似平方级增长,因此是 TTFT(首 Token 延迟)的主要来源。若某 worker 此前处理过与当前请求前缀相同的 prompt,其 KV Cache 中已存在对应块,便可直接复用,跳过重复计算。
块(Block)粒度的缓存管理:为便于调度与跨 worker 传输,业界(如 vLLM 的 PagedAttention)将 KV Cache 切分为固定大小的块,常见的块大小为 16 或 64 个 token。以块为单位追踪缓存命中,既能让路由器快速估算可复用的 token 数,也让分离式架构下通过 NIXL/RDMA 搬运缓存变得可行——只需搬需要的块而非整段序列。文中公式里的“Cached tokens”与“Block size”正是基于这一粒度。
TTFT 与吞吐量的权衡本质:TTFT 优化追求让每个请求尽快复用缓存以减少等待,这会把流量集中到少数“热” worker;而吞吐量优化追求把负载摊平到所有 GPU 以提升总体利用率。两者目标相反,因此路由器需要一个可调的权重参数来在二者之间滑动,这也是 DYN_KV_OVERLAP_SCORE_WEIGHT 成为核心调优旋钮的原因。
环境准备与基础设施搭建
硬件与软件前提
配置智能路由前需要满足以下条件:
- 聚合式服务需要2块GPU,分离式服务则需要4块
- 已配置NVIDIA Container Toolkit的GPU服务器
- Docker Engine与Docker Compose
- Hugging Face账号及访问令牌(用于Llama等受限模型)
- 对LLM推理基础概念的理解(prefill/decode阶段、KV cache)
克隆仓库与容器镜像
首先克隆Dynamo仓库并切换到稳定版本:
$ git clone https://github.com/ai-dynamo/dynamo.git
$ cd dynamo
$ git checkout release/0.9.0
接着验证CUDA版本。使用 nvidia-smi 查看驱动支持的CUDA版本,然后从NGC拉取对应标签的vLLM运行时容器。CUDA 13.x用户执行:
$ docker pull nvcr.io/nvidia/ai-dynamo/vllm-runtime:0.9.0-cuda13
CUDA 12.x用户则使用不带后缀的标签:
$ docker pull nvcr.io/nvidia/ai-dynamo/vllm-runtime:0.9.0
CUDA版本不匹配会导致GPU内核不兼容,务必确保主机驱动与容器运行时一致。
Hugging Face缓存权限
容器以UID 1000运行,需要写入权限才能下载模型权重:
$ mkdir -p container/.cache/huggingface
$ sudo chown -R 1000:1000 container/.cache/huggingface
$ sudo chmod -R 775 container/.cache/huggingface
权限设置不当会直接导致worker初始化失败。
启动基础设施服务
Dynamo的KV Router依赖两个基础服务:etcd用于worker发现与注册,NATS负责KV缓存事件(块创建与驱逐)的实时传播。通过Docker Compose一键启动:
$ docker compose -f deploy/docker-compose.yml up -d
$ docker compose -f deploy/docker-compose.yml ps
确认 deploy-etcd-server-1 和 deploy-nats-server-1 两个容器均处于运行状态。
etcd 与 NATS 为何缺一不可:分布式推理系统的路由器必须知道“当前有哪些 worker 在线、各自监听什么地址”,这一职责由 etcd 承担。etcd 是一个强一致的分布式键值存储,常被用作服务发现与配置中心;Dynamo 中每个 worker 启动时会向 etcd 注册自身元数据并定期续租,worker 崩溃或掉线时租约到期即被自动摘除,避免路由器把请求发往已死节点。
NATS 承担的实时事件通道:如果说 etcd 维护的是“静态的成员列表”,NATS 则负责“动态的缓存状态流”。vLLM worker 在创建或驱逐 KV 块时会产生事件,Dynamo 的 bridge 组件把事件转成 NATS 消息,路由器订阅后即可在毫秒级获知某 worker 上新增或失效了哪些块。没有这条链路,路由器只能靠自身路由历史去“猜”缓存分布,精度显著下降。NATS 还提供 JetStream 持久化能力,用于跨前端副本同步缓存块等持久状态,这是多副本容错部署的基础。
本地部署的端口与网络假设:Docker Compose 模板默认在宿主机暴露 etcd 的 2379 端口和 NATS 的 4222 端口。所有 worker 与前端都通过 localhost 或容器网络访问这两个服务,因此在单机多卡场景下通常无需额外配置;若扩展到多节点,则必须把 etcd 与 NATS 的地址改为可达的集群地址,并确保防火墙放行相应端口,否则 worker 注册和事件订阅都会静默失败。
核心路由参数详解
KV Router通过环境变量控制路由行为、缓存追踪与worker选择逻辑。以下参数均可在Dynamo前端通过环境变量或命令行参数设置。
关键路由参数
| 变量 | 说明 | 默认值 | 推荐值 |
|---|---|---|---|
DYN_ROUTER_MODE | 路由策略模式 | round_robin | kv |
DYN_ROUTER_TEMPERATURE | 通过softmax采样控制路由随机性 | 0.0 | 0.1 |
DYN_KV_OVERLAP_SCORE_WEIGHT | 前缀缓存重叠的权重 | 1.0 | 1.5 |
DYN_KV_CACHE_BLOCK_SIZE | KV缓存块大小(token数) | 取决于后端 | 16 |
DYN_KV_EVENTS | 启用实时KV事件追踪 | true | true |
其中 DYN_KV_OVERLAP_SCORE_WEIGHT 是最关键的调优参数——值越高越偏向TTFT优化,值越低越偏向负载均衡。DYN_KV_CACHE_BLOCK_SIZE 必须与后端(如vLLM)的块大小一致,否则成本计算会出错。
Worker容量阈值
这两个参数定义worker何时被视为"繁忙"并排除在路由之外:
DYN_ACTIVE_DECODE_BLOCKS_THRESHOLD:基于KV缓存块利用率的阈值,建议设为0.85(0.0-1.0之间)DYN_ACTIVE_PREFILL_TOKENS_THRESHOLD:基于预填充token绝对数量的阈值,建议设为10000
两者采用OR逻辑,任一阈值被突破,worker即被标记为繁忙。阈值还可通过 /busy_threshold API在运行时动态更新,无需重启前端。
参数调优策略
面向TTFT优化(低延迟场景):
- 将
DYN_KV_OVERLAP_SCORE_WEIGHT提高到1.5-2.0,优先缓存命中 - 降低繁忙阈值:
DYN_ACTIVE_DECODE_BLOCKS_THRESHOLD=0.70,DYN_ACTIVE_PREFILL_TOKENS_THRESHOLD=500 - 保持
DYN_ROUTER_TEMPERATURE在0.0-0.1,确保确定性选择
面向吞吐优化(高负载场景):
- 将
DYN_KV_OVERLAP_SCORE_WEIGHT降低到0.5-1.0,平衡缓存命中与负载 - 提高繁忙阈值:
DYN_ACTIVE_DECODE_BLOCKS_THRESHOLD=0.95,DYN_ACTIVE_PREFILL_TOKENS_THRESHOLD=2000 - 将
DYN_ROUTER_TEMPERATURE提高到0.3-0.5,改善负载分布
聚合式服务配置实战
聚合式服务将prefill和decode阶段放在同一个worker上。KV感知路由根据缓存KV块优化请求分配,即使worker同时处理两个阶段也能获得性能提升。
部署脚本
在容器内创建聚合式部署脚本,启动两个vLLM worker(分别占用GPU 0和1)并启用KV事件发布。前端配置为KV感知路由:
#!/bin/bash
source ~/kv_routing.env
MODEL="${1:-nvidia/Llama-3.1-Nemotron-Nano-4B-v1.1}"

python -m dynamo.frontend --router-reset-states &
sleep 10

# Worker 1 - GPU 0(ZMQ端口5557)
DYN_SYSTEM_PORT=${DYN_SYSTEM_PORT1:-8081} \
CUDA_VISIBLE_DEVICES=0 python3 -m dynamo.vllm \
    --model "$MODEL" \
    --trust-remote-code \
    --connector none \
    --enable-prefix-caching \
    --kv-events-config '{"enable_kv_cache_events":true,"endpoint":"tcp://*:5557"}' &
脚本的关键设计包括:--connector none 表示聚合模式;--enable-prefix-caching 启用前缀缓存复用;每个worker配置独立的ZMQ端口和系统端口避免冲突。
KV事件流架构
vLLM原生通过ZMQ发布KV缓存事件,而Dynamo的bridge组件自动将这些事件转换为NATS消息供路由消费:
vLLM Worker 1 (ZMQ:5557) ──┐
                            ├──→ Dynamo Bridge ──→ NATS Server ──→ KV Router
vLLM Worker 2 (ZMQ:5558) ──┘
这种架构让路由器获得跨所有worker的统一缓存状态视图,同时保留vLLM原生的事件发布机制。
验证路由效果
发送第一个请求后,前端日志会显示每个worker的成本计算:
Formula for worker_id=...892 with 0 cached blocks: 5.188 = 1.5 * 2.125 + 2.000
Selected worker: worker_id=...892, logit: 5.188, cached blocks: 0
冷启动时两个worker均无缓存块,成本相同(5.188),路由器通过温度采样选择其一。
发送第二个具有相似前缀的请求后,缓存复用生效:
Formula for worker_id=...890 with 0 cached blocks: 5.375 = 1.5 * 2.250 + 2.000
Formula for worker_id=...892 with 1 cached blocks: 3.875 = 1.5 * 1.250 + 2.000
Selected worker: worker_id=...892, logit: 3.875, cached blocks: 1
成本从5.375降至3.875,预填充计算量从2.250块减少到1.250块,直接体现为更快的首Token响应。
分离式服务配置实战
分离式服务将prefill和decode阶段拆分到不同的worker池。KV Router同时优化预填充worker选择(基于缓存命中)和解码worker分配(基于负载),并通过NIXL协调阶段间的KV缓存传输。
部署架构
分离式配置需要4块GPU:GPU 0-1作为解码worker,GPU 2-3作为预填充worker。核心区别在于使用 --connector nixl 启用NIXL进行KV缓存传输,预填充worker启用 --is-prefill-worker,解码worker启用 --is-decode-worker。
# 解码Worker - GPU 0
CUDA_VISIBLE_DEVICES=0 python3 -m dynamo.vllm \
    --model "$MODEL" \
    --connector nixl \
    --is-decode-worker \
    --enable-prefix-caching \
    --trust-remote-code &

# 预填充Worker - GPU 2(ZMQ端口5559)
CUDA_VISIBLE_DEVICES=2 python3 -m dynamo.vllm \
    --model "$MODEL" \
    --connector nixl \
    --is-prefill-worker \
    --enable-prefix-caching \
    --kv-events-config '{"enable_kv_cache_events":true,"endpoint":"tcp://*:5559"}' &
双重路由决策
分离式模式下前端会做出两轮路由决策。预填充路由基于缓存重叠选择worker,解码路由则基于负载分配。
首次请求时预填充worker均无缓存,成本相同(4.125)。解码路由的公式中预填充块权重为0.0——解码worker不计算prefill,它们通过NIXL接收KV缓存:
Formula: 2.000 = 0.0 * 2.750 + 2.000
第二个相似前缀请求到来时,预填充路由显示缓存复用效果:
Formula for worker ...930 with 1 cached blocks: 2.250 = 1.5 * 1.500 + 0.000
Formula for worker ...934 with 0 cached blocks: 3.750 = 1.5 * 2.500 + 0.000
缓存命中使成本从3.750降至2.250,再次验证了KV感知路由在TTFT优化上的效果。
NIXL传输验证
worker日志中会输出NIXL兼容性检查结果:
INFO nixl_connector._nixl_handshake: NIXL compatibility check passed
NIXL通过RDMA实现预填充到解码worker之间低延迟、高带宽的KV缓存块传输,这是分离式架构性能的关键保障。
NIXL 是什么:NIXL(NVIDIA Inference Xfer Library)是 NVIDIA 为推理场景设计的点对点数据传输库,它把底层可用的高速互联(NVLink、InfiniBand RDMA、RoCE,乃至 TCP 回退)抽象为统一接口。在分离式架构中,预填充 worker 算出的 KV Cache 块必须搬给解码 worker 才能继续生成,这段搬运若走普通内存拷贝会严重拖慢流水线。NIXL 让数据在 GPU 显存之间直接传输,绕过 CPU 和系统内存,从而把搬运开销压到最低。
RDMA 与零拷贝:RDMA(Remote Direct Memory Access)允许一台机器的网卡直接读写另一台机器的内存,无需对方 CPU 参与,也无需在内核态与用户态之间反复拷贝。NIXL 借助 RDMA 把一块 KV 块从预填充 GPU 显存写入解码 GPU 显存,端到端延迟通常在数十微秒量级。这也是分离式部署对硬件有要求的原因——若集群没有 RDMA 网络(如 InfiniBand 或支持 RoCE 的以太网),传输会退化到 TCP,分离式带来的收益可能被抵消。
握手检查的含义:日志中的 NIXL compatibility check passed 表示两个 worker 已就传输协议、内存注册方式和设备能力达成一致。若该检查失败,常见原因包括:两端 CUDA 驱动版本不一致、未安装对应的 RDMA 用户态库(如 libibverbs)、或容器未以 --privileged / 正确挂载设备的方式运行。此时 worker 通常不会崩溃,但缓存传输会失败并导致解码阶段数据缺失,表现为输出乱码或请求报错。
多后端支持与统一配置
KV Router的环境配置在vLLM、SGLang和TensorRT-LLM三大推理后端间通用。相同的环境变量可直接复用,仅需针对块大小和KV事件发布方式做后端特定调整。
块大小差异
| 后端 | 典型块大小 | 配置 |
|---|---|---|
| SGLang | 16 | DYN_KV_CACHE_BLOCK_SIZE=16 |
| TensorRT-LLM | 64或128 | DYN_KV_CACHE_BLOCK_SIZE=64 |
| vLLM | 16 | DYN_KV_CACHE_BLOCK_SIZE=16 |
路由器与worker之间的块大小不匹配会导致成本计算错误和路由决策失误,务必核实后端配置。
事件发布方式对比
SGLang使用NATS URL格式:--kv-events-config nats://localhost:4222。TensorRT-LLM仅需一个标志:--publish-events-and-metrics。vLLM使用JSON配置格式指定ZMQ端点。
预测模式
当后端不支持KV事件发布时,可通过 --no-kv-events 切换到预测模式。路由器基于自身路由决策预测缓存状态,使用TTL过期机制(默认120秒)。预测模式精度不及实时事件,但无需NATS依赖,基础设施开销更低。
实时事件模式与预测模式的取舍:实时事件模式(默认)让路由器拥有“上帝视角”——它确切知道每个 worker 当前缓存了哪些块,路由决策最准确,代价是必须运行 NATS 并处理持续的事件流,对基础设施和网络稳定性有依赖。预测模式(--no-kv-events)则放弃外部事件源,路由器根据自己下发过的请求自行推算各 worker 的缓存状态:它假定发往某 worker 的请求会在该 worker 上留下对应块,并记录这些块的创建时间。
TTL 过期机制:由于没有驱逐事件通知,预测模式必须靠超时来模拟块的失效。默认 120 秒的 TTL 意味着路由器认为一个块在创建后 120 秒内仍有效,超时即从本地视图中删除。这个值需要与后端实际的缓存驱逐策略匹配:设得过长会导致路由器把请求发往已实际驱逐该块的 worker,造成虚假命中、预填充并未减少;设得过短则会低估缓存命中率,退化为接近轮询的行为。
适用场景:预测模式适合后端本身不支持 KV 事件发布、或希望简化基础设施(不部署 NATS)的中小规模部署,也常用于快速验证。但它对请求前缀高度重复、缓存被频繁驱逐的高并发场景精度较差,因为在缓存状态快速变化时,推算视图与真实状态的偏差会被放大。生产环境中更推荐实时事件模式并配合监控观察缓存命中率指标。
生产环境监控与扩展
部署Grafana和Prometheus可可视化KV缓存路由性能指标,跟踪TTFT改善、缓存命中率和worker选择模式。
当需要多个前端副本实现容错和水平扩展时,启用 --router-replica-sync 标志。每个副本维护自己视图中的活跃块状态(瞬时状态),副本之间通过NATS核心消息交换路由决策,而缓存块状态(持久状态)通过JetStream自动同步。新副本从零活跃块开始,但通过同步快速收敛,保证路由决策的一致性。
生产部署的后续优化方向包括:基于真实流量模式调优 DYN_KV_OVERLAP_SCORE_WEIGHT 和 DYN_ROUTER_TEMPERATURE;搭建Grafana监控面板持续追踪TTFT、缓存命中率和worker负载;测试SGLang或TensorRT-LLM后端以对比缓存效率。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。