NVIDIA Nemotron 3 说话人分离实测:8人混音精准识别
NVIDIA开放权重说话人分离模型Nemotron 3:4GB显存跑通8人混音,可完全本地部署。
语音识别能告诉你"说了什么",但在播客分析、会议纪要、语音智能体等场景中,同样关键的问题是"谁说的"——这正是说话人分离技术的价值所在。NVIDIA 最新发布的 Nemotron 3 说话人分离模型以约1亿参数、4GB显存的极低门槛,支持多达8位说话人的准确区分,即使在声音重叠互相打断的情况下也表现稳定,在 DER(说话人分离错误率)上显著超越前代 SortFormer 及竞争对手。模型采用可商用的开放权重许可证,与 ASR 模型解耦,支持流式与离线两种模式。实测中,8个合成声音同时说话可准确归属,一小时播客约148秒完成处理。整条流水线可完全在本地运行,适合注重数据隐私的团队批量处理音视频内容。
语音转录的最后一公里:谁在说话
市面上的语音识别模型已经相当成熟——Whisper、Parakeet、Canary,如果只是要一份转录文本,这个问题基本已经被解决。但一旦你想把语音数据喂给大语言模型或构建智能体应用,仅有文本远远不够。你需要时间戳来知道每句话何时说出,更关键的是要知道到底是谁说的。
设想一个四人辩论的播客,你需要区分谁持哪方观点;做会议纪要时,你需要明确谁认同了哪项行动项。当我们用智能体去处理这些内容、提取隐含意图并归属到具体的人时,一份混在一起、分不清说话人的逐字稿几乎没有价值。这正是**说话人分离(Speaker Diarization)**要解决的核心问题。
简单说:语音识别告诉你「说了什么」,说话人分离告诉你「谁说的」,两者结合就得到了带说话人标注的转录文本。
Nemotron 3 说话人分离:轻量且开放
NVIDIA 新发布的 Nemotron 3 说话人分离模型,是专门针对这一问题的开放权重模型,且采用允许商业使用的许可证。它最吸引人的地方在于参数量仅约1亿,只需4GB显存即可运行,这意味着许多小型GPU、甚至笔记本上的RTX显卡都能跑得相当顺畅。
在能力上,它可以处理多达8位说话人,而过去大多数模型的上限通常只有3到4位。更重要的是,它不仅能在大家清晰发言时区分8人,即使出现互相打断、声音重叠的情况,表现依然相当稳定。
该模型被设计为与任何语音识别模型解耦配合——你可以搭配自己偏好的ASR模型(比如Parakeet)使用,而不必绑定单一提供商。
一个被忽视的语音模型家族
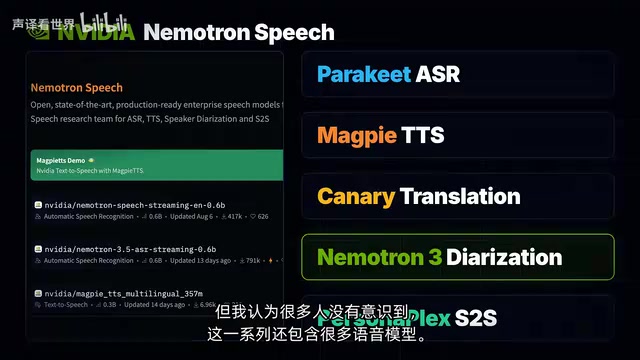
NVIDIA 将其作为 Nemotron 语音模型系列的一部分推出。很多人只知道 Nemotron 的大语言模型,却没意识到这个系列还包含丰富的语音模型:
- 识别方向:Parakeet、Canary、Nemotron ASR,共同支持43种语言的流式与批量转录;
- 语音合成:名为 Magpie 的 TTS 模型,支持多语言与语音定制;
- 翻译与语音到语音:如支持全双工处理的 PersonaPlex。
在说话人分离方面,此前的选项叫 SortFormer,最多支持4位说话人,一度相当受欢迎——旧版 SortFormer 仅在8月就获得超过30万次下载,说明已有不少生产环境在使用。新的 Nemotron 3 可以视作对它的直接替代,且效果显著更好。从这些迭代节奏看,NVIDIA 正在系统性地补齐一整套完整的语音模型套件。
衡量标准:DER 与流式/离线的区别
说话人分离最大的挑战之一是声音重叠。会议中有人提问时,往往两三个人同时回答,旧系统在声音重叠时容易混乱,难以区分不同声音。作者也坦言,没有任何模型能在这件事上做到完美,即便对人类也是难题。
业界用**说话人分离错误率(DER, Diarization Error Rate)**来评估,它把三类错误相加:模型遗漏的语音、误判为非语音的内容,以及把语音错误归属给他人的次数。分数越低越好。据视频演示的数据,NVIDIA 最新模型不仅击败了竞争对手,也大幅超越了自家前代模型。
另一个关键概念是**流式(streaming)与离线(offline)**的区别:
- 离线模式:模型可以查看整段录音(包括后续内容再做判断),适合已录制好的播客、会议存档;
- 流式模式:必须在音频到达时即时决策,适合实时字幕或语音智能体,代价是准确率会略有下降。
Nemotron 3 支持流式与离线两种模式,且是语言无关的。
DER 的计算方式值得进一步了解。它通过将音频时间轴上的三类错误时长加总后除以实际语音总时长得出百分比:**漏检错误(Miss)**指真实语音被识别为静音或噪音而遗漏;**虚检错误(False Alarm)**指将背景噪音误判为语音;**说话人混淆错误(Speaker Error)**指语音片段被分配给了错误的说话人。其中说话人混淆通常是三类中占比最大的,也是最难优化的。值得注意的是,DER 不惩罚说话人数量预测错误本身——如果模型把8个人识别成了6个,只要每段音频在时间上归属正确,DER 仍可能较低。因此评估说话人分离模型时,通常还会结合最优说话人映射(匈牙利算法)来做标签对齐后再计算。
本地部署实测:8人合成声音的极限测试
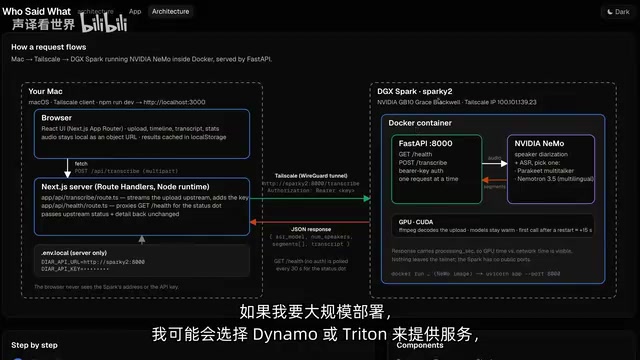
作者搭建了一套完整的本地方案:前端是运行在 Mac 上的 Next.js 应用,通过 Tailscale 调用后端;后端跑在 DGX Spark 上,用一个包含 NVIDIA NEMO 的 Docker 容器提供服务,其中集成了说话人分离模型、Parakeet ASR 以及 Nemotron 3.5 多语言 ASR。服务层用 FastAPI 封装(若要大规模部署,可换用 Dynamo 或 Triton)。
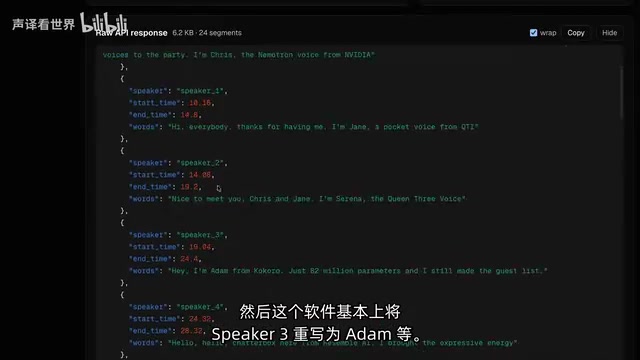
最亮眼的测试环节,是让8个不同来源的开放TTS声音同时登场——包括 NVIDIA 的 Nemotron 声音 Chris、QTI 的 Pocket、Qwen3 声音 Serena、Cocoro 的 Adam、Resemble AI 的 Chatterbox、Nari Labs 的 John Dyer、Maya Research 的 Maya 等。当这八个声音互相打断、同时说话时,模型依然能准确标记出每个声音归属于谁。
处理速度同样惊人:一段一分半的音频,转录加分离只需三四秒。模型返回的原始JSON里,说话人被标记为 speaker_1、speaker_2……应用层再把它们重命名为真实姓名(模型本身不会自动识别人名,只输出编号,但补一段代码替换即可)。
文中提到的 NVIDIA NeMo 是理解这套部署方案的关键。NeMo(Neural Modules)是 NVIDIA 开源的大规模语音与语言模型训练及推理框架,提供从数据处理、模型训练到推理部署的完整工具链,涵盖 ASR、说话人分离、TTS、NLP 等多个模块。其说话人分离组件封装了声纹嵌入提取、聚类算法(如 MSDD 多尺度解码器)等完整流水线,用户可以直接调用预训练模型而无需了解底层实现细节。DGX Spark 则是 NVIDIA 面向个人开发者和小团队推出的紧凑型 AI 工作站,搭载 Grace Blackwell 芯片,定位是「桌面级超算」,正是作者用来运行本地后端的硬件。对于没有 DGX Spark 的用户,4GB 显存的低门槛意味着主流消费级 GPU(如 RTX 3060/4060)同样可以胜任。
长音频与统计能力
作者进一步放入了一整集 All-In 播客(黄仁勋受访那期,时长超过一小时)。模型约在**148秒(两分半)**内完成了全部处理,输出了每位说话人的逐字转录,还能生成统计数据——每个人的说话时长、发言次数等。结果显示黄仁勋作为嘉宾说得最多,符合直觉。
转录结果可导出为纯文本或 SRT 字幕文件。若需要多语言场景,还能切换到多语言ASR模型,该模型标注为「适配就绪(adapter-ready)」,可通过微调在其他语言上获得更好表现。
为什么这件事值得关注
随着语音需求持续上升——无论是单用户与智能体交互,还是智能体抓取 YouTube 视频等多模态内容以提取上下文——「谁说了什么」的精确归属正在成为构建可靠语音应用的基础设施。
Nemotron 3 说话人分离的价值在于三点叠加:开放权重且可商用、极低的4GB显存门槛、8人混音下的稳定表现,再加上可与任意ASR模型解耦组合,并且能完全在本地完成整条流水线。对于注重数据隐私、需要批量处理会议或播客的团队来说,这是一个值得认真评估的方案。
相关推荐

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。

构建语义代码搜索的RAG管道:原理与实践
本文解析如何为语义代码搜索构建RAG管道,涵盖代码分块、向量化、检索重排与生成四大环节,并探讨分块策略、embedding模型选择和索引维护等落地挑战。