NVIDIA PAIR:把家里闲置算力串成本地AI集群
NVIDIA PAIR 将家中多台闲置设备的算力整合为统一本地AI算力池,支持动态调度且完全免费。
NVIDIA 推出的 PAIR 软件旨在把家庭中分散的闲置设备算力汇聚成一个统一资源池,让本地 AI 智能体跨设备调度运行。用户只需在各台设备上安装 PAIR,软件便会自动评估每台机器的可用算力,并将任务动态路由至最合适的设备——当某台机器因游戏等任务占用算力时,PAIR 会实时重新分配。它支持 Windows、NVIDIA 硬件以及 Apple 设备,兼容混合品牌的家庭环境。所有模型与任务均在本地运行,数据不上传云端,兼顾隐私与控制权,且软件完全免费。目前该方案基于单一演示来源,跨设备延迟、带宽瓶颈及异构硬件兼容性等工程挑战仍待实测验证。
NVIDIA 推出的一款名为 PAIR 的新软件,正在尝试解决一个很多人都有的痛点:家里散落着好几台电脑,但真正跑 AI 任务时往往只用得上其中一台。PAIR 的思路是把这些设备的空闲算力汇聚起来,让本地 AI 智能体(agent)在整个家庭网络中调度运行。
PAIR 想解决什么问题
很多技术爱好者家里不止一台电脑——除了主力机,可能还有一台备用机,甚至一台放了五年的游戏主机。这些设备平时大部分时间处于闲置状态,算力被白白浪费。PAIR 的核心价值就在于把这些「零散算力」整合成一个可用的资源池。
用户在演示中描述了一个直观场景:在一台电脑上敲下指令并回车,任务其实并不在本机执行,而是被转发到另一台电脑上完成。对使用者来说,交互入口是统一的,底层的算力调度则由 PAIR 在后台完成。
跨设备的智能调度
PAIR 的做法是在你所有的设备上都安装这款软件。安装完成后,PAIR 会评估每台设备当前可用的算力,并据此把任务路由到最合适的机器上。
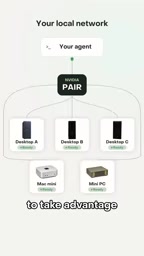
值得关注的是它的兼容性——不仅支持 Windows 或英伟达自家的硬件生态,连 Apple 设备也在支持范围之内。这意味着一个混合品牌、混合新旧的家庭设备环境,理论上都能被纳入同一个算力池。
动态感知负载变化
PAIR 的调度并不是静态的一次性分配。演示中提到了一个关键能力:假设你开始在某台电脑上打游戏,PAIR 会识别到这台机器的可用算力已经被占用,从而自动把 AI 任务重新路由到其他空闲设备上。
这种动态重新分配的机制,让算力池在实际使用中更贴近真实场景。用户不必手动干预,也不用担心 AI 任务和日常使用(游戏、办公)互相抢占资源。
本地运行与隐私优势
PAIR 主打的另一个卖点是「完全本地化」。模型、智能体、任务执行全部在自己的设备上进行,数据不必上传到云端。对于重视隐私、希望对自己的 AI 智能体拥有完整控制权的用户来说,这是一种颇具吸引力的部署方式。
此外,据介绍这款软件完全免费。免费加上本地隐私,降低了普通用户尝试本地 AI 集群的门槛——不需要额外购买昂贵的专用硬件,利用手头现有的设备就能起步。
「本地 AI 推理」与云端推理的本质区别在于计算发生的位置。云端方案需要将用户的提示词(prompt)和上下文数据发送至远程服务器,由服务商的 GPU 集群完成运算后再返回结果;本地推理则把模型权重下载到用户自己的设备,整个前向传播过程在本机完成,数据全程不离开物理边界。这一点对于处理个人文件、私密对话或企业敏感信息的 AI 智能体尤为重要。PAIR 的「完全本地化」承诺延伸了这个概念——即便任务被路由到家中另一台设备上执行,数据依然在用户可控的局域网内流转,而非流向第三方数据中心。这与 Ollama、LM Studio 等本地推理框架的隐私主张一脉相承,区别在于 PAIR 将算力边界从「单台设备」扩展到了「家庭网络」。
一点观察
本文基于 YouTube 上的单一演示来源,PAIR 的实际表现——比如跨设备任务调度的延迟、不同硬件间的模型兼容性、网络带宽是否会成为瓶颈——都还需要更多实测来验证。分布式本地推理在概念上很吸引人,但把家用网络里性能参差的设备协调成一个高效算力池,工程上并不简单。
不过从方向上看,PAIR 代表了一个有意思的趋势:让本地 AI 不再受限于单台设备的天花板,而是把「家里所有机器」当作一个整体资源来使用。对于想要摆脱云端依赖、追求隐私和完全掌控的用户,这类工具值得持续关注。
分布式推理在工程层面面临几个经典挑战,值得读者在评估 PAIR 时留意。首先是模型分片(model sharding / tensor parallelism):将一个大模型切割后分布在多台设备上并行计算,需要设备间频繁同步中间张量,对网络带宽和延迟极为敏感;家用千兆有线网络理论上尚可,但 Wi-Fi 环境下的抖动可能成为明显瓶颈。其次是异构硬件的调度复杂度:不同架构的 GPU(NVIDIA vs Apple Silicon)指令集不同,要在同一推理任务中协同,通常需要统一的中间表示层(如 ONNX 或 llama.cpp 的跨平台后端),否则只能让不同设备跑相互独立的任务而非真正并行同一模型。PAIR 目前公开的技术细节有限,这两个问题的实际解法尚不明朗,是后续值得重点关注的技术披露方向。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。