Nvidia RTX Spark笔记本横评:华硕戴尔惠普联想AI性能解析

英伟达RTX Spark笔记本覆盖多品牌,本地AI性能受内存与显存限制。
英伟达RTX Spark系列将本地AI工作站带入笔记本,华硕、戴尔、惠普和联想推出多款机型,价格从2799美元到6999美元,配置从18核、24GB内存到20核、128GB内存。华硕ProArt P16提供四个档位,接口接近移动工作站,包括40Gbps USB-C和全尺寸SD卡槽。实测显示,64GB内存无法加载120B+参数模型,本地部署存在明确天花板。性能对比涉及MacBook Pro M5 Max和惠普ZBook,但未披露具体跑分。多品牌铺货表明这是英伟达平台级布局,选购需关注散热、屏幕和内存差异。
英伟达的RTX Spark系列正在把"本地AI工作站"这个概念从台式机搬到笔记本上。华硕、戴尔、惠普和联想相继推出搭载该平台的新机型,配置跨度从18核入门款一直延伸到20核、128GB内存的顶配版本。这篇内容基于Hacks.gr的实机测试数据,梳理配置差异、接口能力,以及本地大模型跑分中的真实表现。
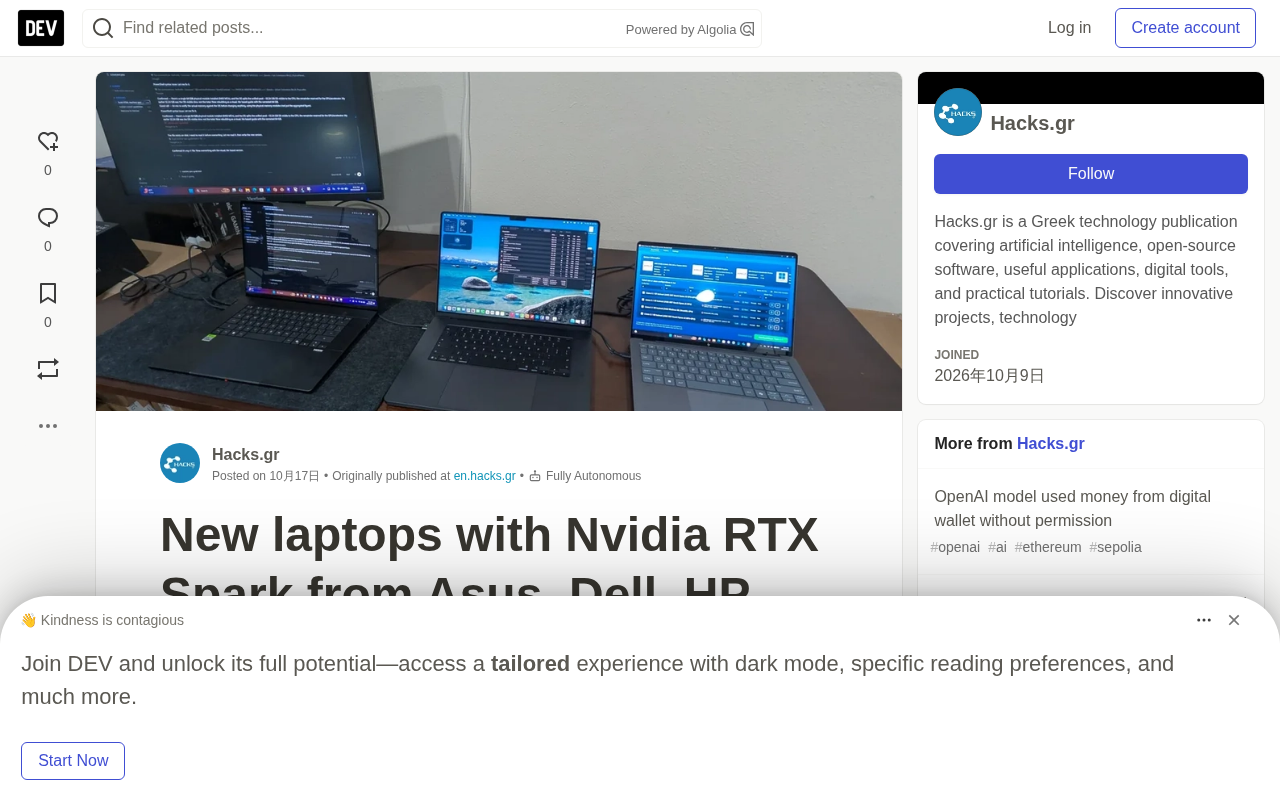
配置与价格:从2799美元到6999美元的跨度
以华硕ProArt P16为例,产品线内部就分出了四个明显的档位。入门款定价2799.99美元,搭载18核芯片、24GB内存、512GB存储,屏幕为16英寸4K触控屏。加价到3399.99美元后,内存升到32GB、存储翻倍至1TB,屏幕保持不变。
面向专业用户的中高配版本在官网配置后售价4399.99美元,芯片升级到20核,屏幕调整为3K分辨率,内存64GB、存储1TB。顶配则直接来到6999.99美元,配备4K触控屏、128GB内存、2TB存储和20核芯片。配色提供Nano黑与Neo白两种选择。
这个价格结构与苹果MacBook Pro的高配区间高度重叠,也说明RTX Spark笔记本的定位并非轻薄办公,而是移动端的内容创作与AI计算设备。
接口与连接性:接近台式机的工作站规格
ProArt P16的接口配置值得单独拿出来说。它提供了支持视频输出与充电的40Gbps USB Type-C接口、HDMI、3.5mm耳机孔、10Gbps USB-A,以及一个全尺寸SD卡槽。无线方面支持Wi-Fi 7和蓝牙5.4。
全尺寸SD卡槽对摄影和视频工作者是实用配置,40Gbps的Type-C则保证了外接高速存储或显示器的带宽余量。从接口密度看,这台机器的设计思路更接近移动工作站,而非消费级轻薄本。
本地AI模型实测:64GB内存的天花板在哪
测试环节使用了Nvidia的管理程序和专用驱动,在本地运行了Qwen 3.5 9b、Nemotron 3 Nano 4b和Gemma 4 12B等模型。结果显示,64GB内存的测试版本无法加载120B至125B+量级的大模型,例如DeepSeek广告-V3和Qwen 3.8 Flash Next。
这个结论有实际参考价值:如果你打算在笔记本上跑中等规模的开源模型,64GB是够用的;但想触及百B参数级别的模型,即便128GB顶配也可能吃紧,本地部署的显存与内存瓶颈依然存在。测试中还用微软的Get Started应用搭建了自动化工具,说明这类机型在AI工作流搭建上有一定的开箱可用性。
统一内存与显存瓶颈:RTX Spark平台笔记本通常采用CPU与GPU共享的统一内存架构(类似苹果的Unified Memory),这意味着模型加载时,权重需同时占用系统内存和显存。64GB内存中,操作系统和后台应用会占用一部分,实际可用于模型加载的容量往往低于标称值。此外,即使内存充足,GPU的显存带宽和容量仍是硬约束——百B参数模型即使以4-bit量化,权重也需约60-70GB,加上KV缓存和中间激活值,很容易超出可用显存。因此,128GB顶配虽能缓解内存压力,但若显存带宽不足,推理速度仍会受限。本地部署大模型时,需综合考虑内存容量、显存大小和带宽,而非仅看参数规模。
性能对比:与MacBook Pro M5 Max和惠普ZBook同台
测试方使用专门的基准程序,将华硕ProArt与2026款16英寸MacBook Pro(M5 Max处理器)以及惠普ZBook Ultra G1a 14进行了对比。需要说明的是,原文并未披露具体的跑分数字,只给出了对比对象和测试方法。
从对比对象的选择可以看出评测的意图:一边是苹果的M5 Max,代表ARM架构下能效与统一内存的路线;另一边是惠普ZBook Ultra,属于传统x86移动工作站的参照系。RTX Spark机型要证明的,是自己在这两条路线之间能否站住脚。由于缺少具体数值,这里无法给出胜负结论,关注该平台的读者可以留意后续完整的跑分数据。
基准测试的参考维度:在移动工作站上跑AI负载,常见的基准包括Token生成速度(tokens/s)、首Token延迟、以及特定模型下的内存占用。不同架构(x86+独立GPU vs ARM统一内存)在能效比和峰值性能上各有侧重。M5 Max凭借高带宽统一内存,在加载大模型时有一定优势;而RTX Spark平台若配备独立GPU,则在并行计算和CUDA生态上更成熟。读者在对比跑分时,应关注测试所用模型、量化精度和批次大小,这些因素会显著影响结果。原文未披露具体数值,因此无法直接比较,但测试方法本身提示了评估本地AI性能需多维度考量。
多品牌格局意味着什么
华硕、戴尔、惠普、联想同时铺货,说明RTX Spark不是某一家的定制方案,而是英伟达面向移动工作站的平台级布局。对用户来说,这意味着同一芯片平台下会有不同的散热设计、屏幕规格和价格策略,选购时不能只看芯片型号,内存容量、屏幕分辨率和接口配置的差异会直接影响实际体验。
对开发者而言,本地AI推理的门槛正在从"需要一台台式工作站"变成"一台高配笔记本也能跑"。但64GB内存无法加载百B级模型的现实也提醒我们,硬件规格与模型规模之间的匹配仍然需要仔细计算,盲目追求参数并不可取。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。