NVIDIA Topograph:让GPU工作负载调度感知网络拓扑
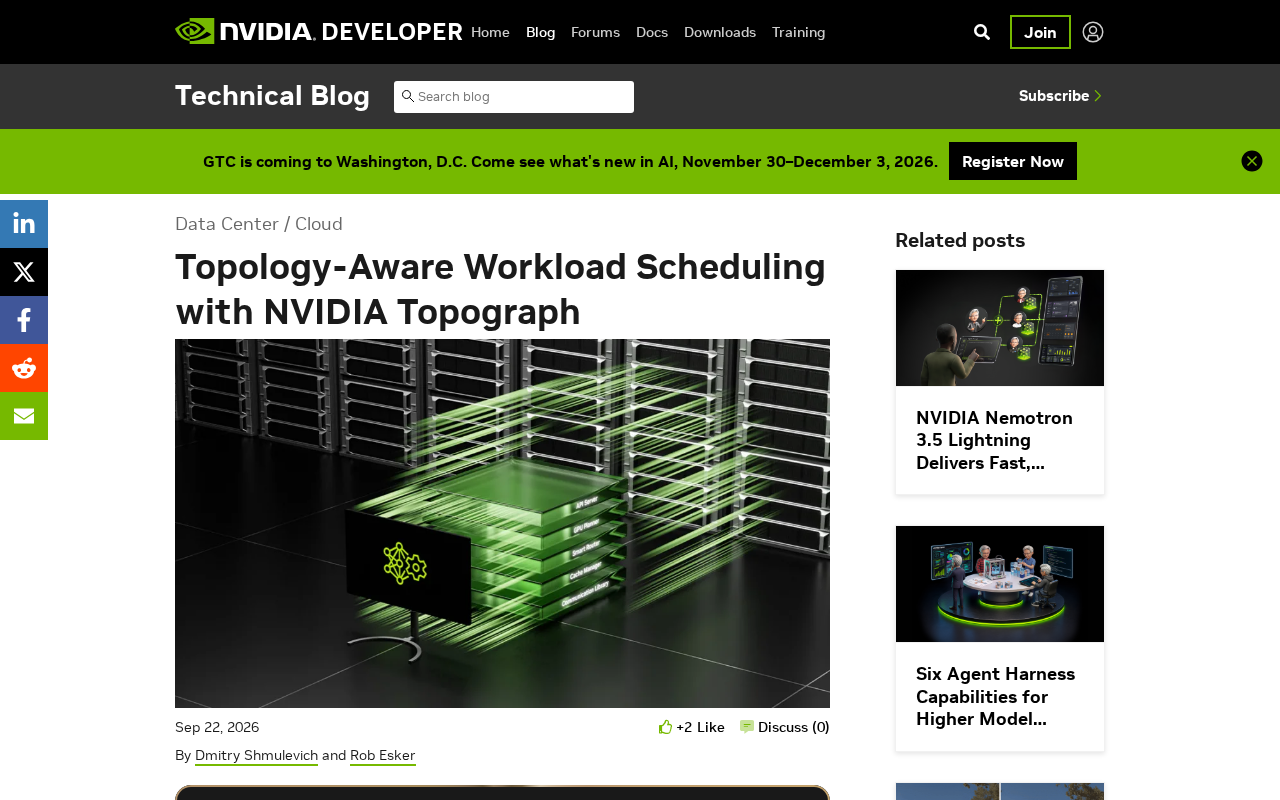
NVIDIA Topograph 通过感知集群硬件拓扑实现智能GPU工作负载放置,提升AI工厂的计算利用率与能效比。
AI工厂的效率瓶颈并非总在算力本身,GPU工作负载的放置策略同样关键。当调度器忽视底层硬件拓扑时,通信密集型任务可能被分散到带宽低、延迟高的跨节点链路上,导致集群整体吞吐下降。拓扑感知调度(Topology-aware Scheduling)通过构建硬件连接层次的"地图",将高频通信任务收拢至NVLink等高带宽近端链路,降低跨域流量。NVIDIA Topograph 正是将这一拓扑信息暴露给调度层的工具,结合Dynamo推理框架可实现智能工作负载放置。在电力与硬件成本双高的背景下,这类软件层优化能够在不扩容的前提下榨取现有硬件的性能余量,也体现了NVIDIA向全栈软件生态延伸的战略布局。
AI工厂本质上是受功耗限制的系统,只有在充分优化的前提下才能发挥最大价值。而在这套优化体系中,GPU工作负载的放置(workload placement)往往是被忽视却又至关重要的一环。当成百上千块GPU通过复杂的多层网络互联时,任务被调度到哪些节点、哪些GPU上,直接决定了通信开销的高低,进而影响整个集群的吞吐效率。
为什么工作负载放置如此关键
在大规模分布式训练和推理场景中,GPU之间需要频繁交换梯度、激活值和中间结果。这些通信不是均匀分布的——同一台服务器内的GPU通过NVLink高速互联,跨机架、跨交换机的通信则要经过带宽更低、延迟更高的网络链路。
如果调度器对底层硬件拓扑一无所知,它可能会把需要密集通信的任务分散到网络上距离很远的节点,导致大量数据在低带宽链路上来回穿梭。这种"糟糕的放置"会让通信成为瓶颈,即便每块GPU的算力都被拉满,集群整体利用率依然低下。对于以功耗为硬约束的AI工厂而言,这意味着每一瓦特电力产出的有效计算量都在缩水。
NVLink 是 NVIDIA 开发的高速 GPU 互联总线,用于同一服务器内多块 GPU 之间的直接通信,第四代 NVLink 的单向带宽可达 900 GB/s,远超 PCIe 的 ~64 GB/s。与之形成对比的是跨节点通信所依赖的 InfiniBand 或 RoCE(RDMA over Converged Ethernet)网络,尽管高端 InfiniBand HDR/NDR 可提供 200-400 Gb/s 的链路速率,但在多跳路由和交换机竞争下,实际可用带宽通常比 NVLink 低一到两个数量级。这种层级带宽落差(intra-node vs. inter-node)正是拓扑感知调度发挥价值的根本原因:如果两块需要每秒交换数百 GB 数据的 GPU 被分配到不同服务器,通信开销将成倍放大,形成明显的系统瓶颈。
拓扑感知调度的核心思路
Topology-aware scheduling(拓扑感知调度)的核心,是让调度系统"看得见"硬件的物理布局。它需要理解GPU之间的连接层次:哪些GPU在同一节点内、哪些节点挂在同一个交换机下、哪些跨越了不同的机架或网络域。
有了这份拓扑地图,调度器就能把通信紧密的任务尽量收拢到"距离"更近的硬件上,让高频通信走高带宽的近端链路,从而减少跨域流量。这一思路在HPC领域并不新鲜,但在动辄数千卡的现代AI集群中,其收益被显著放大——通信模式越复杂、规模越大,拓扑优化带来的加速就越明显。
在分布式训练中,通信负载主要来自三种并行策略:数据并行(Data Parallelism)需要在所有节点间同步梯度,通信量与模型参数规模成正比;张量并行(Tensor Parallelism)将单层权重切分到多 GPU,要求极低延迟的 all-reduce 操作,对 NVLink 带宽依赖最强;流水线并行(Pipeline Parallelism)则在不同层之间传递激活值,对节点间链路要求相对较低。拓扑感知调度的实践意义在于:张量并行组的 GPU 应优先放置在同一节点内(利用 NVLink),流水线阶段可跨节点但应尽量同机架,数据并行副本则可灵活分布。不同并行策略对通信拓扑的敏感程度不同,调度器需要理解任务的通信模式才能做出最优决策。
NVIDIA Topograph 的定位
NVIDIA Topograph 正是为解决这一问题而生的工具。它的目标是把集群的网络与硬件拓扑信息暴露给调度层,使得工作负载能够按照拓扑结构进行智能放置,而不是简单地按空闲资源随机分配。
结合 NVIDIA Dynamo 等推理与调度框架,Topograph 让运维者能够在部署训练或推理任务时,自动考虑底层互联结构。这对于运行大语言模型推理、分布式训练这类通信敏感的工作负载尤为重要——合理的放置可以直接转化为更低的端到端延迟和更高的集群吞吐。
NVIDIA Dynamo 是 NVIDIA 推出的分布式推理框架,专为大语言模型(LLM)在多 GPU、多节点集群上的高效服务而设计。其核心能力包括 KV Cache 的跨节点调度与复用、请求的动态路由,以及与 Kubernetes 等编排系统的集成。Topograph 作为拓扑信息层,可以被视为 Dynamo 调度决策的"地图"输入——Dynamo 负责"决定做什么",Topograph 负责"告知在哪里做最合适"。两者结合使得推理请求能被路由到与已缓存 KV 数据物理距离最近的 GPU 节点,减少缓存迁移带来的额外通信开销,这对于长上下文推理场景的吞吐量提升尤为显著。
对AI基础设施的意义
随着模型规模持续扩张,单纯堆砌GPU数量的边际收益正在递减,如何"用好"已有算力成为新的竞争焦点。拓扑感知调度代表了基础设施优化从"资源分配"向"资源编排"的演进。
对于运营AI工厂的团队,这类工具意味着无需盲目扩容,就能通过更聪明的调度榨取现有硬件的性能余量。在电力和硬件成本双双高企的当下,这种软件层面的优化往往有着极高的投入产出比。Topograph 的出现,也反映出NVIDIA正在从芯片向上延伸,构建覆盖调度、编排、推理的全栈软件生态。
注:本文基于NVIDIA开发者博客的公开介绍整理,具体功能细节与性能数据以官方文档为准。
相关推荐
AWS MCP Server 配置指南:让 Claude 直连你的云环境
本文详解如何通过 OAuth 方式配置 AWS MCP Server,将 Claude 与 AI agent 安全连接到 AWS 云环境,涵盖 CLI 验证、清理旧配置、安装服务器、OAuth 授权及 IAM 权限边界等完整步骤。

用MCP给AI编程助手共享记忆:告别重复解释代码
AI编程助手常因缺乏跨会话、跨仓库记忆而需要反复解释代码。本文解析如何通过MCP协议和mFlow平台为AI助手搭建共享记忆与知识库,实现自动文档生成、技术债务工单拆分及多助手协同。

用 Clippy 录屏喂给 AI 编程助手:更快的开发工作流
一位开发者分享如何用录屏工具 Clippy 配合 Claude、Codex 等 AI 编程助手:口述演示需求生成结构化链接,Agent 直接获取截图、转录和摘要,省去逐帧处理的时间与 token,大幅提升开发效率。