NVIDIA金融交易基础模型构建指南:从预训练到下游应用全解析

引言:交易数据蕴含的行为密码
每一次刷卡、转账和支付,都在现代金融网络中编码着人类行为的模式。交易数据是金融机构所拥有的最丰富的信号之一,但长期以来,如何系统性地挖掘这些数据的深层价值,一直是行业面临的核心挑战。
NVIDIA近日在其开发者博客上发布了一篇重磅技术文章,详细介绍了如何构建专属的交易基础模型(Transaction Foundation Model),为金融智能应用提供底层支撑。这一方案的提出,标志着基础模型的理念正从自然语言和视觉领域,进一步渗透到金融交易这一垂直场景。
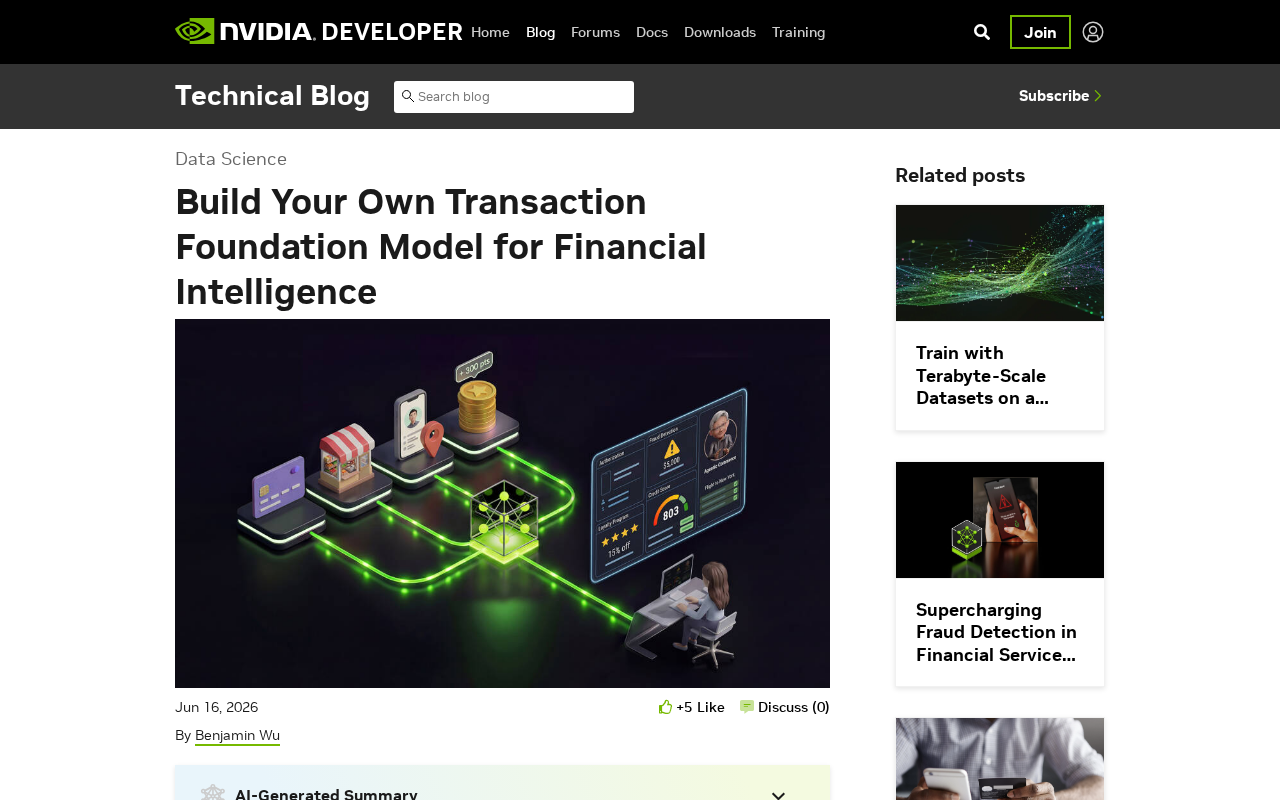
什么是交易基础模型?
从传统模型到基础模型的范式转变
在传统金融AI应用中,每一个具体任务——欺诈检测、信用评分、客户分群——通常需要独立训练一个专用模型。这种方式不仅开发成本高昂,而且各模型之间无法共享学到的知识。
交易基础模型借鉴了大语言模型(LLM)的成功经验:先在海量交易数据上进行大规模预训练,学习交易序列中蕴含的通用行为模式,然后通过微调(fine-tuning)快速适配到各种下游任务。这种"预训练+微调"的范式,能够显著降低每个具体应用的开发门槛,同时提升模型的泛化能力。
"基础模型"(Foundation Model)这一概念由斯坦福大学人类中心人工智能研究院(HAI)在2021年正式提出,其核心思想是:在大规模数据上训练的单一模型可以作为众多下游任务的基础。GPT系列、BERT等语言模型是这一理念最成功的实践。而在金融领域,这一范式的引入经历了从传统机器学习(如XGBoost、随机森林等针对单任务的模型)到深度学习(如LSTM序列模型),再到如今基础模型的三次跃迁。每一次跃迁都意味着模型对数据中隐含知识的利用效率大幅提升——基础模型的关键突破在于,它能够从未标注数据中提取可迁移的通用表征,这在标注成本极高的金融场景中尤为珍贵。
交易数据的独特性
与文本数据不同,金融交易数据具有几个显著特征:
- 多模态混合:每笔交易包含数值型(金额、时间戳)、类别型(商户类别、交易类型)和序列型(交易历史)等多种数据类型
- 时序依赖性强:用户的消费行为具有明显的时间模式,周末消费、月初发薪等周期性特征至关重要
- 分布高度不均衡:正常交易与异常交易的比例可能达到10000:1,这对模型训练提出了特殊要求
- 隐私敏感性:金融数据受到严格的合规监管,模型构建需要在数据安全的前提下进行
值得深入理解的是,这些特征的组合使得金融交易建模的难度远超一般的NLP任务。在自然语言处理中,词汇表是有限且离散的,而交易数据中的金额是连续值,其分布往往呈现重尾特征(少数大额交易与大量小额交易并存)。分布不均衡问题在学术界被称为"类别不平衡学习"(Class Imbalance Learning),传统解决方案包括过采样(如SMOTE算法)、欠采样和代价敏感学习等,但这些方法在超大规模数据集上的效果有限。基础模型通过自监督预训练绕过了对标注数据的依赖,从根本上缓解了不均衡标注带来的偏差问题——模型先学习"什么是正常",再通过少量异常样本学习"什么是异常",这与人类认知异常事件的方式高度一致。
技术架构与实现路径
数据预处理与表征学习
构建交易基础模型的第一步是将异构的交易记录转化为统一的向量表征。NVIDIA的方案建议采用类似于Transformer架构的编码器,将每笔交易的多维特征映射到一个高维嵌入空间中。关键技术包括:
- 数值特征的分桶编码:将连续的金额、时间间隔等数值离散化,便于模型学习
- 位置编码的时间感知设计:不同于NLP中的固定位置编码,交易序列需要感知真实的时间间隔
- 自监督预训练目标:通过掩码预测(Masked Transaction Prediction)等任务,让模型在无标注数据上学习交易模式
Transformer架构最初由Google在2017年的论文《Attention Is All You Need》中提出,专为序列到序列的NLP任务设计。然而,近年来研究者发现其自注意力机制(Self-Attention)在处理表格数据和时序数据时同样表现出色。TabTransformer(2020)和FT-Transformer(2021)等工作证明了Transformer在结构化数据上可以媲美甚至超越传统的梯度提升树模型。在交易数据场景中,自注意力机制的优势尤为突出:它能够直接建模任意两笔交易之间的关联(例如一笔大额转出后紧跟一笔小额消费可能暗示特定行为模式),而无需像RNN/LSTM那样逐步传递信息。自监督学习方面,掩码预测的思路直接借鉴了BERT的Masked Language Model(MLM),但在交易场景中需要同时预测被掩码交易的多个属性(金额、商户、时间等),这比预测单个词汇token要复杂得多,需要设计多任务联合损失函数。
模型训练策略
在预训练阶段,模型需要处理数十亿条交易记录。NVIDIA建议利用GPU集群进行分布式训练,并采用以下策略提升效率:
- 序列打包(Sequence Packing):将不同长度的用户交易序列紧凑地打包到固定长度的批次中,减少填充浪费
- 课程学习(Curriculum Learning):从简单的短序列预测逐步过渡到复杂的长序列建模
- 混合精度训练:利用FP16/BF16加速计算,同时保持模型精度
分布式训练是处理大规模数据的必要手段,其核心策略分为数据并行(Data Parallelism)和模型并行(Model Parallelism)两大类。数据并行将训练数据分片到多个GPU上,每个GPU持有完整的模型副本并独立计算梯度,最后通过AllReduce等通信原语同步梯度;模型并行则将模型本身拆分到多个GPU上,适用于单卡显存无法容纳完整模型的场景。对于交易基础模型,由于单条交易的嵌入维度相对有限(通常在256-1024维),模型参数量可能在数亿级别,数据并行通常是更高效的选择。混合精度训练利用了NVIDIA GPU(从Volta架构的V100开始)内置的Tensor Core硬件单元,这些专用计算核心能够以FP16/BF16精度执行矩阵乘法,吞吐量是FP32的2-8倍。BF16相比FP16具有更大的动态范围(与FP32相同的指数位宽),因此在训练稳定性上更具优势,这也是为什么NVIDIA在A100及后续GPU中重点支持BF16格式的原因。
下游应用场景
欺诈检测
预训练后的交易基础模型可以通过少量标注数据微调,快速部署到欺诈检测场景。由于模型已经学习了正常交易的行为模式,异常交易会在嵌入空间中表现出明显的偏离,从而实现更精准的检测。
当前全球支付欺诈损失每年超过300亿美元(据Nilson Report统计),而传统欺诈检测系统主要依赖两类方法:基于规则的专家系统和基于监督学习的机器学习模型。规则系统(如"单日跨境交易超过5笔则触发警报")虽然可解释性强,但面对不断演化的欺诈手法时更新缓慢且容易产生大量误报;监督学习模型(如随机森林、XGBoost)虽然更灵活,但严重依赖高质量标注数据,而欺诈标注往往存在数周甚至数月的延迟(需要持卡人报案后才能确认)。基础模型方法的革命性在于:它通过自监督预训练建立了对"正常行为"的深度理解,本质上是一种异常检测(Anomaly Detection)范式——任何偏离已学习模式的交易都会获得较高的异常分数。这种方法对新型欺诈手法具有天然的泛化能力,因为它不需要见过特定的欺诈样本就能识别"不正常"。
信用风险评估
通过分析用户的历史交易序列,模型能够捕捉到传统信用评分模型难以发现的行为特征,例如消费稳定性、收入波动模式等,为信用决策提供更丰富的信号。
个性化金融服务
交易嵌入还可以用于客户分群和个性化推荐,帮助金融机构更精准地理解客户需求,提供定制化的产品和服务。
行业影响与展望
交易基础模型的出现,代表了金融AI从"单任务专用模型"向"通用基础模型+任务适配"的架构升级。这一转变的意义在于:
- 降低AI落地成本:金融机构不再需要为每个业务场景从零开始训练模型
- 提升数据利用效率:无标注的海量交易数据可以通过自监督学习被充分利用
- 加速创新迭代:新的业务需求可以通过微调快速响应,而非重新建模
说个细节,NVIDIA此次发布的是构建指南而非开箱即用的模型,这意味着各金融机构需要基于自身数据进行定制化训练。这既保护了数据隐私,也确保了模型能够适配不同机构的业务特点。
在更广阔的行业视角下,NVIDIA并非唯一在金融基础模型方向发力的玩家。Mastercard早在2023年就宣布利用其覆盖全球的交易网络数据训练专有的交易AI模型;Visa则通过其AI平台Visa Advanced Authorization每年实时评估超过1500亿笔交易;摩根大通的AI研究团队也发表了多篇关于交易序列建模的学术论文。在开源社区,IBM的TabFormer和蚂蚁集团的相关工作也在探索类似方向。NVIDIA的独特定位在于:作为算力基础设施提供商,它提供的是"如何高效训练"的方法论和工具链(包括RAPIDS、Merlin等加速库),而非与金融机构竞争数据或模型本身。这种"卖铲子"的策略使其能够与整个金融AI生态形成互补而非竞争关系。
随着金融行业数字化转型的深入,交易基础模型有望成为金融智能基础设施的核心组件,推动整个行业的AI能力从碎片化走向系统化。
核心要点
相关推荐
AI编程代理持久记忆方案:逆向解析Understand Anything插件
逆向解析Understand Anything插件:它如何为Claude Code、Codex、Cursor等AI编程代理构建本地持久知识库,通过代码地图、业务逻辑连接与增量更新实现项目级记忆,而非依赖更大的上下文窗口。
Cursor、Claude Code、Qwen Code 1.0 三大AI编程Agent横评
对比 Cursor、Claude Code 与 Qwen Code 1.0 三款 AI 编程 Agent 的差异:Qwen Code 开源且无需 Node.js,Claude Code 覆盖终端与 IDE,Cursor 支持多模型并接入 Slack 与 GitHub 评审。从开源、模型绑定和工作流入口三个维度给出选型思路。
AI Agent开发者必知的5个免费GitHub仓库
探索AI Agent开发者必知的5个免费GitHub仓库,涵盖Agent项目模板、代码生成与Claude等大模型集成工具,帮助你快速搭建和优化AI智能体,降低开发门槛。