NVLink 6 多层容错:NVIDIA如何保障AI工厂持续算力
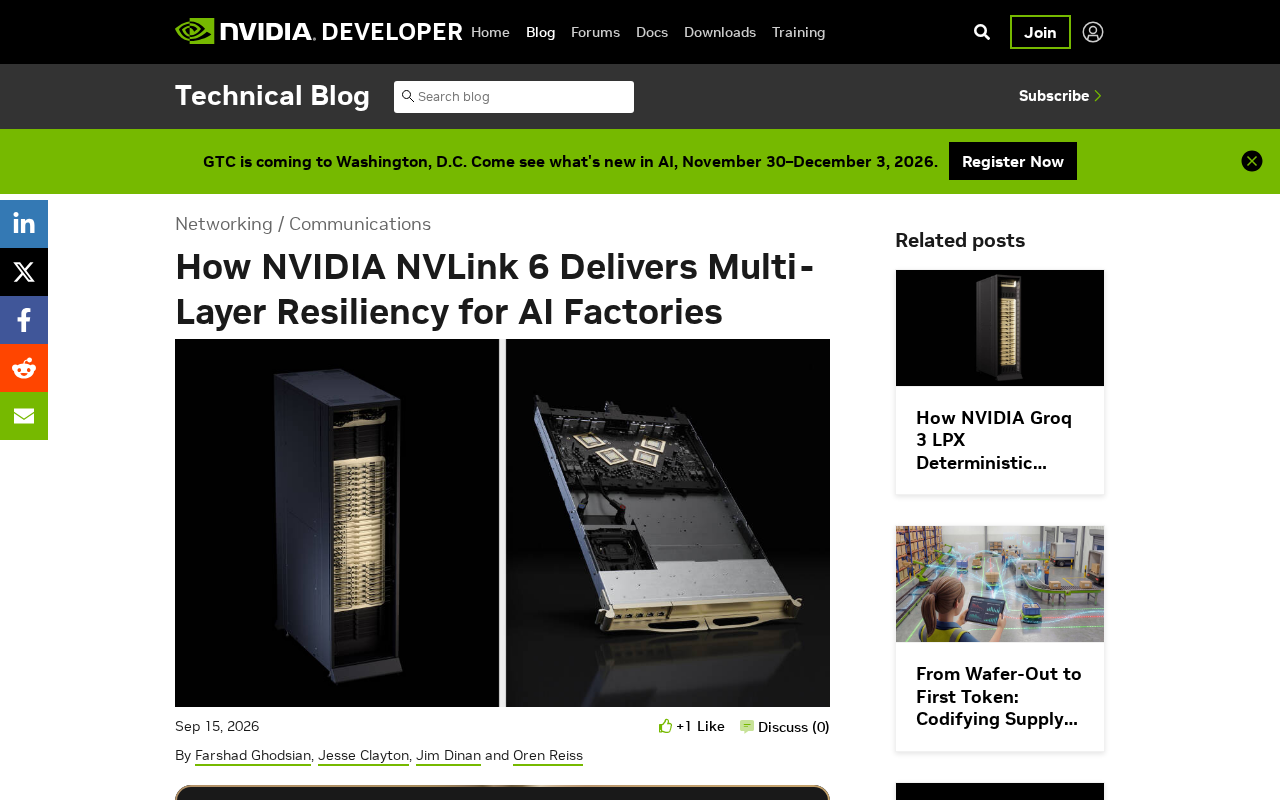
NVLink 6多层容错机制通过分层冗余设计,让超大规模GPU集群在局部故障时维持训练连续性。
本文围绕NVIDIA NVLink 6的多层容错(Multi-Layer Resiliency)设计展开,阐述其对大规模AI训练集群的实际意义。文章指出,在万亿参数模型的训练场景中,集群GPU数量庞大,硬件故障几乎是常态,互连层的稳定性直接决定有效算力利用率。NVLink 6的多层容错设计分三个层级:链路级冗余通过自动重传等机制透明消化瞬态错误;故障隔离机制在出现硬故障时快速定位并隔离问题节点,减少检查点回滚;系统级健康监测则支持预测性维护,降低非计划停机概率。文章最终得出结论:AI基础设施的竞争正从单纯算力堆叠转向系统级可靠性工程,互连层韧性应成为基础设施选型的核心考量。
AI工厂的核心命题:可用性即生产力
对于运营大规模AI工厂的团队而言,持续产出算力就是核心生产力指标。在超大规模AI训练场景下,集群中的每一块GPU都参与同一个任务——一旦某个节点或链路发生故障,整个训练作业可能被迫中断甚至回滚到上一个检查点,代价高昂。
随着模型参数规模跨入万亿级别,训练集群的GPU数量动辄成千上万。规模越大,硬件故障的概率就越高:链路抖动、单卡失效、交换机异常等问题在数千节点的系统中几乎是常态而非例外。因此,如何让互连结构在面对局部故障时保持整体运转,成为衡量AI基础设施成熟度的关键。NVIDIA为NVLink 6引入的多层容错(Multi-Layer Resiliency)机制,正是针对这一痛点的系统性设计。
为什么互连层是韧性的关键
在传统认知中,人们往往关注GPU本身的算力,却容易忽视连接这些GPU的互连网络。事实上,在大规模并行训练中,GPU之间需要频繁交换梯度和参数,通信带宽和稳定性直接决定训练效率。NVLink作为NVIDIA GPU间的高速互连技术,承担着这一重任。
当集群扩展到成百上千块GPU时,互连拓扑变得极为复杂。任何单点链路故障若无法被系统优雅处理,都可能级联影响整个训练任务。这意味着,互连层不仅要追求峰值带宽,更要具备在故障发生时维持服务的能力——这正是「韧性(Resiliency)」概念的核心。
NVLink 是 NVIDIA 专有的 GPU 间高速互连总线技术,最早随 Pascal 架构(2016年)推出,逐代演进至今。与 PCIe 相比,NVLink 提供更高的双向带宽和更低的延迟,使多 GPU 系统能够以近乎统一内存的方式共享数据。在 Hopper 架构(H100)中,NVLink 4 已提供每 GPU 900 GB/s 的双向带宽;到 Blackwell 架构对应的 NVLink 6,带宽和可扩展性进一步提升。在大规模训练场景中,常见的并行策略(张量并行、流水线并行、数据并行)都要求 GPU 之间频繁同步,NVLink 的带宽上限直接决定了这些同步操作的瓶颈在哪里。NVSwitch 则是配套的交换芯片,用于构建全互连拓扑,使机柜内乃至跨机柜的 GPU 都能以全带宽互相通信,这是 DGX SuperPOD 等大规模集群的基础互连架构。
多层容错的设计思路
NVLink 6 强调的是「多层」容错,即在不同层级构建冗余与故障隔离机制,而非依赖单一防护手段。这种分层设计的逻辑在于:不同类型的故障需要在不同层级被检测和处理。
链路级冗余
在物理链路层面,通过冗余通道和自动重传等机制,系统可以在个别链路出现瞬时错误时自动恢复,避免故障向上层传播。这类机制对用户和上层应用透明,能够消化大量的瞬态错误。
自动重传(ARQ,Automatic Repeat reQuest)与前向纠错(FEC,Forward Error Correction)是互连协议中处理物理层错误的两类主要机制。FEC 通过在发送端附加冗余校验码,使接收端在不重传的前提下纠正一定范围内的比特错误,延迟极低;ARQ 则在检测到不可纠正的错误时触发重传请求,适合处理突发的较严重错误。NVLink 在链路层结合这两类机制,使得因信号衰减、串扰或瞬态干扰导致的零星错误几乎对上层不可见。这一层透明恢复能力越强,越能减少错误向上层传播并触发更昂贵恢复流程的概率,是整个多层容错体系的第一道防线。
故障隔离与快速恢复
当出现无法在链路层修复的硬故障时,系统需要能够快速定位故障节点,将其隔离出通信拓扑,并尽可能保证其余节点的训练任务继续推进。对于大规模训练,减少检查点回滚的频率和范围,直接关系到有效算力的利用率。
检查点(Checkpoint)机制是大规模分布式训练中对抗故障的主要手段:训练框架定期将模型权重、优化器状态等持久化到存储系统,一旦发生中断即可从最近的检查点恢复,而无需从头重训。然而,保存检查点本身会占用 I/O 带宽并产生短暂的计算停顿,过于频繁会降低训练效率;过于稀疏则意味着故障后可能损失数小时乃至更长的计算进度。当集群规模扩展到数千 GPU 时,每次全量检查点的存储开销也相当可观。因此,能够在链路层或节点层直接恢复故障、而不触发检查点回滚,是多层容错机制最直接的价值所在——它把「需要回滚」的故障事件数量压缩到最低,从根本上改善了有效算力利用率(MFU,Model FLOPs Utilization)这一核心指标。
系统级监测
在整个AI工厂的层面,持续的健康监测与遥测数据采集,使运维团队能够提前发现潜在风险、进行预测性维护,从而把非计划停机降到最低。
对AI工厂运营的实际意义
对于大规模训练作业,中断意味着算力浪费和交付延期。多层容错机制的价值,本质上是在提升集群的「有效运行时间」——即真正用于有效计算的时间占比。
随着模型规模持续增长,训练任务动辄需要连续运行数周乃至数月,任何一次意外中断都可能造成显著损失。通过在互连层构建纵深防御,NVLink 6 试图让超大规模集群从「故障必然导致中断」转变为「故障可被容忍与恢复」,这对AI工厂的产出稳定性具有直接影响。
结语
NVLink 6 的多层容错设计,反映出AI基础设施竞争正从单纯的算力堆叠,转向系统级可靠性工程。当集群规模不断突破极限,如何让庞大的互连网络在故障中依然保持整体运转,将成为决定AI工厂竞争力的重要因素。对于关注大模型训练效率的团队而言,互连层的韧性能力值得纳入基础设施选型的核心考量。
(注:本文基于NVIDIA开发者博客的公开介绍整理,具体技术参数与实现细节请以官方文档为准。)
相关推荐
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。