Olares One评测:本地AI服务器上手,5000美元值不值?

5000美元的Olares One紧凑AI服务器上手评测:开箱即用跑本地大模型,但值不值看使用强度。
Olares One是一台售价约5000美元的个人AI服务器,搭载Intel Core Ultra 9 275HX、RTX 5090(24GB GDDR7)、96GB内存和2TB存储,机身紧凑且满载噪音仅38分贝。系统通过手机LarePass应用引导安装,日常在浏览器桌面中使用,底层Olares OS基于Kubernetes但无需Linux知识。评测者跑通了Ollama+Qwen 3.5 9B+Open WebUI的本地大模型流程,体验了ComfyUI图像生成和Hermes Agent助手,并指出容器隔离导致需手动配置连接、ComfyUI模型目录易放错等坑。1.12.7版本新增Router统一连接管理和Laris聊天应用。结论是机器本身物有所值,重度AI订阅用户可用其替代部分云服务并掌控数据,轻度用户则未必划算。
本地运行大模型一直有门槛:硬件贵、配置复杂、软件生态散乱。Olares One 试图用一台紧凑的“个人 AI 服务器”把这些麻烦一次性解决。YouTube 频道 DistroTube 对这台设备做了详细上手,从开箱到跑通本地大模型、图像生成和 AI 助手,全程记录。这台机器售价约 5000 美元,到底适合谁?
硬件配置:紧凑机身里的移动工作站
Olares One 的核心是一颗 Intel Core Ultra 9 275HX 处理器,24 核,最高睿频 5.4GHz。GPU 是 NVIDIA GeForce RTX 5090,配 24GB GDDR7 显存;内存 96GB DDR5-5600,存储为 2TB NVMe 固态。整机塞进铝合金机箱,尺寸约 12.6 × 7.8 英寸,厚度略超 2 英寸,重约 2.2 公斤。
这显然不是普通迷你主机,而是一台围绕高性能移动 GPU 搭建的紧凑工作站。RTX 5090 的 24GB 显存是本地跑大模型的关键门槛,96GB 内存则让多个容器化应用同时运行时不至于捉襟见肘。接口方面,机身只有四个主要 I/O:Thunderbolt、HDMI、USB-A 和 2.5G 以太网。作为无头服务器够用,但如果你想把它当工作站接显示器和键鼠,得另配扩展坞——评测者收到的测试套件里就附了一个 USB Hub,带额外 HDMI、SD 卡槽和第二个以太网口。
散热和噪音是这台机器的一大亮点。官方标称待机低于 23 分贝,满载 38 分贝。评测者第一次通电时甚至无法确认是否开机,手摸机箱也没有震动感。对于需要安静环境的创作者来说,这个表现相当友好。
RTX 5090 的 24GB GDDR7 显存之所以被视为本地大模型的“门槛”,是因为模型权重必须驻留在显存中才能获得可接受的推理速度。粗略估算,7B 参数模型以 4-bit 量化约需 4-5GB 显存,14B 约 8-10GB,32B 则接近 18-20GB,24GB 正好覆盖到 30B 级别量化模型。GDDR7 相比 GDDR6 带宽提升明显,对 token 生成速度有直接帮助。
Intel Core Ultra 9 275HX 属于移动端 Arrow Lake-HX 系列,24 核由 8 个性能核与 16 个能效核组成,最高睿频 5.4GHz。它集成了 NPU,但本地大模型推理主要仍依赖独立 GPU。选择移动版 CPU 而非桌面版,是整机能把体积和噪音压下来的关键取舍。
安装与系统:手机 App 引导,浏览器里用桌面
Olares One 的定位是服务器,设计为无头运行,不需要接显示器和键盘。首次设置只需要插电源和网线,然后在手机(iOS 或 Android)上安装 LarePass 应用。App 会自动扫描设备并引导安装 Olares OS,设置账号密码,之后还会生成一次性验证码,相当于双因素认证。
日常使用通过浏览器完成。输入专属 URL(形如 desktop.用户名.olares.com),再用 LarePass 取一次性密码登录,就能看到一个简洁的 Linux 桌面,布局类似 GNOME,左侧是应用坞,右下角显示时间和系统监控。
底层系统 Olares OS 是基于 Kubernetes 的开源 Linux 个人云操作系统。听起来很重,但实际使用不需要任何 Linux 或 K8s 知识,应用安装和普通应用商店一样点按钮即可。应用市场里有数百款应用,覆盖本地 AI 工具、图像生成、媒体服务器、密码管理、文件存储和自动化平台,每个应用运行在隔离的容器环境里,互不干扰。
文件互通也做了优化。评测者演示了从本地电脑直接拖拽文件到 Olares 桌面,文件会同步过去,反向操作同样可行。
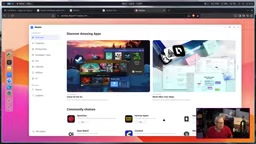
Kubernetes 是一个容器编排系统,原本用于数据中心管理成百上千个服务:它负责调度容器到不同节点、自动重启失败的服务、管理网络与存储。个人设备上直接使用 K8s 通常意味着大量 YAML 配置和命令行操作,这正是 Olares OS 要封装的部分——它把每个应用打包成独立容器,由 K8s 负责隔离与生命周期管理,用户只看到应用商店的安装按钮。这种架构的好处是应用之间互不污染,一个应用崩溃或升级不影响其他应用;代价是容器间默认网络隔离,所以 Open WebUI 才需要手动填写 Ollama 的共享入口 URL 才能通信。
跑通本地大模型:Ollama + Qwen + Open WebUI
评测者的核心场景是本地大语言模型。系统已经预装了 Ollama 引擎基础,所以第一步是直接在市场里搜索并安装模型。他选了 Qwen 3.5 9B,下载花了大约 20 分钟——大模型体积大,这是初次配置中最耗时的部分。
装完模型后,点击 Ollama 图标只能看到一个运行状态窗口,并不是终端界面。要真正对话,需要再装一个图形前端 Open WebUI。装好后注册管理员账号,却发现模型列表是空的。原因是每个应用都在自己的容器里,Open WebUI 看不到 Ollama 里的模型,必须手动建立连接。
具体做法是:进入 Olares 设置 → 应用 → 找到 Ollama → 共享入口,复制那里的 URL,再回到 Open WebUI 的 设置 → 连接 → 管理连接,添加一个 Llama API 连接并粘贴该 URL。验证显示连接成功后保存,模型列表里就出现了 Qwen 3.5 9B。评测者让它写一首俳句,几秒后输出了结果——虽然质量见仁见智,但流程完整跑通了。
Ollama 是一个本地模型运行时,负责下载模型权重、加载到 GPU/CPU 并提供统一的推理 API(默认兼容 OpenAI 接口格式)。Open WebUI 则是独立的网页聊天前端,本身不包含模型,只通过 API 地址连接后端推理引擎。两者分离的设计让用户能自由更换模型或前端,但也要求手动配置连接。Qwen 3.5 9B 是阿里通义千问广告系列的中等规模模型,9B 参数在 24GB 显存下可轻松运行,适合作为本地助手的起步选择。
图像生成:ComfyUI 的坑与修复
接下来是 AI 图像生成工具 ComfyUI。安装很快,但首次打开模板就提示缺少四个模型。ComfyUI 提供“本地下载”和“服务器下载”两个选项,这里必须选服务器下载,否则模型会落到本地电脑而不是 Olares One 上。
四个模型下载完成后,刷新页面,三个错误消失,但还剩一个缺失模型。评测者进文件管理器排查,发现其中一个文件被下载到了 models/checkpoints 目录,而它应该在 models/text_encoders 里。手动剪切粘贴后刷新,错误全部清除。
这个细节值得注意:ComfyUI 的模型目录结构有严格要求,下载路径放错就会导致模板无法运行。对不熟悉 ComfyUI 的用户来说,这类问题会消耗不少时间。
修复后,评测者运行了一个“中世纪骑士骑战马”的模板,生成效果不错。他把提示词里的 horse 改成 camel,重新生成,得到了一张相当有趣的装甲骆驼图。
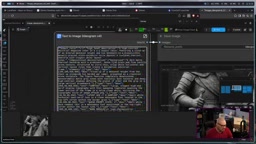
ComfyUI 采用节点式工作流,一个模板往往由多个模型协同完成:checkpoint 提供基础图像生成能力,text encoder 负责把提示词编码成模型可理解的条件向量,VAE 负责在像素与潜空间之间转换,LoRA 则用于微调风格。这些组件必须分别放入 models/checkpoints、models/text_encoders、models/vae 等固定目录,ComfyUI 按目录扫描可用模型。放错目录不会报“文件不存在”,而是表现为“模型缺失”,排查时需要对照模板要求的文件名逐一核对路径。
AI 助手与 Router:新系统的连接管理
评测者还试了 Hermes Agent,一个会从对话中积累技能、持久化知识的聊天助手。通过终端运行快速设置,选择本地连接,跳过消息平台绑定。配置 provider 时,他选择自定义直连 API,把 Olares 设置里 Ollama 的共享入口 URL 填入作为 API base,系统自动检测到了模型。
测试问题是“这台机器的 RAM 是多少”。Hermes 打开终端执行了 free -h,返回结果:总内存约 93GB,当前可用约 58GB。这说明助手具备调用系统命令的能力,不只是聊天。
评测过程中他还发现 Olares OS 有系统级更新,需要通过 LarePass 手机应用完成,而不是应用市场里的更新按钮——后者只更新已安装的应用。更新到 1.12.7 版本后,市场里出现了新应用,其中两个官方工具值得一提:
- Router:统一管理模型与应用的连接。之前 Open WebUI 需要手动复制 Ollama 的共享入口 URL,现在 Router 提供统一的路由地址,在 Open WebUI 里添加 OpenAI API 连接并粘贴 Router URL 即可,验证通过后模型名显示为“olares/Qwen 3.5 9B”。
- Laris:内置聊天应用,直接对接 Router。评测者让它查询系统资源,它调用 Laris Dashboard 技能,列出了 Ollama、Hermes、Open WebUI、Router 等应用各自的 CPU 和内存占用。输出默认折叠在“工具与命令”区域里,需要手动展开,交互上略显别扭,但信息本身是准确的。
系统更新后市场里还出现了 Blender。评测者不碰 3D 建模,但看重它的视频编辑能力,这意味着 Olares One 理论上可以承担视频剪辑任务。市场里甚至提供 Windows 和 macOS 的安装选项——在本地服务器上跑 macOS,这个能力确实少见。
5000 美元值不值:看你是不是重度 AI 用户
评测者的结论是:机器本身值这个价。硬件规格扎实,静音表现优秀,软件把 Kubernetes 的复杂性藏了起来,普通用户不需要系统管理经验。
但他也坦言,自己虽然用不少 AI 工具,却不算重度投入,个人未必能说服自己掏这笔钱。他的判断逻辑是:如果你订阅了大量 AI 服务,一年花在各类订阅上的费用可能超过一千美元,那么用一台本地服务器替代部分订阅、数据完全自己掌控,经济账是算得过来的。隐私和自主权是另一层价值——不必把数据交给第三方平台,也不用猜测企业怎么处理你的信息。
对他自己而言,Olares One 最实际的用途是跑大语言模型。本地 LLM 动辄几十 GB,他办公室的工作站存储很快就紧张,而 Olares One 的 2TB 空间给了足够余量。后续他还打算深入试试 ComfyUI 这类图像生成工具。
这台设备的定位很清晰:不是给所有人准备的通用电脑,而是给愿意为本地 AI 和数据主权付费的用户。如果你只是偶尔用用聊天机器人,云端服务更划算;如果你在本地跑模型、需要长期在线的私有云、又不想折腾服务器运维,Olares One 提供了一条开箱即用的路径。
相关推荐

阿尔茨海默病真实体验:从自知到遗忘的五年
一位家属讲述陪伴父亲走过阿尔茨海默病最后五年的真实经历:早期患者自知却否认,中期问题从自身转向家人,终末期一切功能逐一关闭。揭示患者视角下最令人恐惧的疾病体验。

单个图超网络零样本生成多架构权重,开源实现跨模态泛化
Reddit开发者开源图超网络GHN,单次前向传播为零样本生成ResNet、MLP-Mixer、MobileNet和Transformer权重,覆盖视觉、文本、波形模态,并公布零样本准确率。
图注意力网络+低成本硬件:癫痫检测新方案
解读一项基于图注意力网络(GAT)与可获取硬件的癫痫检测研究:为何选择图神经网络处理EEG信号、低成本硬件带来的信号挑战,以及该方案在低资源地区落地的现实障碍与社区质疑。