Ollama+Cline本地部署Qwen3编码模型全教程
用Ollama+VSCode+Cline三件套,在本地显卡上免费运行媲美顶级闭源模型的编码AI。
本文介绍了一套以Ollama、VSCode和Cline为核心的本地AI编程方案,可让开发者在自己的电脑上免费运行开源编码大模型,彻底摆脱API Token限制和代码隐私顾虑。模型选型的关键门槛是显存:24G以上可运行Qwen3系列大参数量化版,能力接近顶级闭源模型;8-12G显存则退而使用轻量模型兜底。配置流程相对简单,核心步骤包括将Cline的API提供商指向Ollama、调整Context窗口大小,以及解除VSCode的文件夹信任限制。实测可在几分钟内生成3D地球可视化和Flappy Bird等项目,还支持MCP工作流集成与无审查模型,兼顾能力、成本与数据隐私,是厌倦订阅费和调用限制的开发者值得尝试的方向。
本地跑编码大模型,为什么值得一试
把编码大模型搬到自己的电脑上运行,这件事在过去几乎不可想象——要么显存不够,要么开源模型能力太弱,做不出像样的项目。但据这位B站UP主的实测演示,如今在一台配备高端显卡的游戏PC上,本地运行的开源模型已经能接近甚至在某些编码基准上超越顶级闭源模型。
这套方案的核心卖点很直接:100%免费、无Token限制、数据完全本地化。对于经常撞到API调用上限、又不想把代码上传到第三方服务器的开发者来说,本地部署是一个相当有吸引力的选择。UP主强调,整套流程搭建起来其实比想象中简单,普通开发者花十几分钟就能跑通。
需要提醒的是,视频中提到的模型命名和基准分数表述略显混乱(口播中出现了"Qwen3.8""27B"等不同说法,实际应为Qwen3系列的编码模型),阅读时建议以模型官方页面的准确信息为准。
三件套:Ollama + VSCode + Cline
整个本地部署方案由三个工具组成,分工清晰:
- Ollama:本地模型运行引擎,负责下载、加载和推理。前往 ollama.com 下载安装即可,过程与安装普通软件无异。
- VSCode:代码编辑器兼操作界面,用来查看代码、管理项目文件。UP主将它类比为Cursor那样的编程环境。
- Cline:VSCode的AI编程插件(视频语音识别误写为"Slime/Client"),在扩展商店搜索"Cline"安装即可。它负责把本地模型接入编辑器,实现Agent式的自动编码。
安装完成后,进入Cline的设置,把API提供商(API Provider)切换为Ollama,此时就能看到本地已下载的所有模型。这里还可以设置Context窗口大小——UP主用RTX 5090将上下文设到了64K,并建议显存有限的用户降到32K左右以保证稳定性。
Cline 是一个开源的AI编程Agent插件,区别于GitHub Copilot等"代码补全"工具,它以"任务驱动"方式工作:你用自然语言描述目标,Cline会自主规划步骤、读写文件、执行终端命令,直到任务完成。整个过程对用户透明可审查,每一步操作都会请求确认。Cline的架构设计使它可以对接任意兼容OpenAI API格式的后端,这正是它能无缝接入Ollama本地模型的原因——Ollama在本地启动一个HTTP服务,暴露与OpenAI API格式兼容的接口,Cline只需把请求发往 localhost:11434 即可。
按硬件选模型:24G显存是分水岭
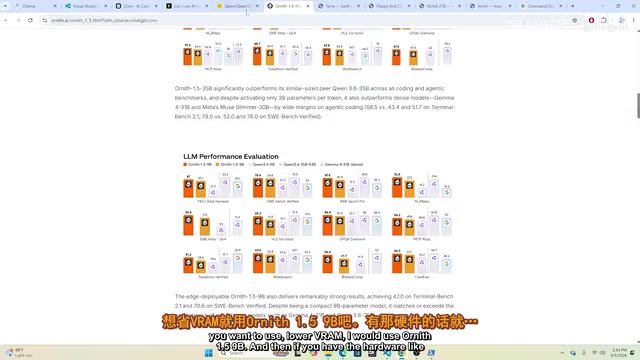
选模型的关键在于量力而行。UP主推荐用一个叫"Kneron AI"(口播发音,应为模型硬件匹配类工具)的网站来查询自己的硬件能跑什么模型。核心的选择逻辑大致如下:
显存24-36G:跑大参数量化版
如果显卡显存在24到36G之间,可以直接上Qwen3系列较大参数的量化版本(视频中反复提到的"Q款")。这是能力最强、最接近顶级闭源模型的档位,也是本教程主推的方案。
显存8-12G:小参数模型保底
显存只有8到12G的电脑或笔记本,UP主推荐更小的模型(口播为"Ornith 1.5B",实际应为对应的轻量模型)。虽然编码基准得分较低,运行也偏卡顿,但对小硬件来说这是相对最优的兜底选择。
下载模型的方式很简单:进入对应模型页面,复制官方给出的命令行指令,Windows用户在PowerShell里执行,Mac用户直接开终端即可。较大的量化模型体积约17-20G,下载完成后就能在Ollama中直接调用。
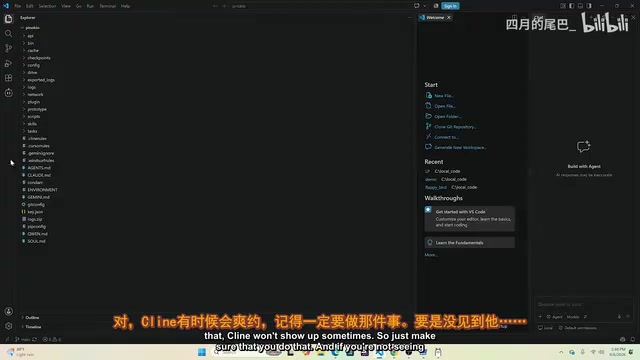
一个常见的坑:在VSCode里打开项目文件夹后,可能会遇到"受限模式"的提示。这是VSCode保护代码安全的机制,需要在"管理 → 信任此文件夹"中手动确认。UP主特别提醒,Cline有时连不上模型,多半就是这个信任设置没做好。
**量化(Quantization)**是让大模型跑在消费级显卡上的关键技术。原始模型的权重通常以16位或32位浮点数存储,量化则将其压缩为4位、5位或8位整数,显存占用可缩减至原来的1/4到1/2。以"Q4_K_M"为例,Q4代表4位量化,K_M是具体的量化算法变体,在压缩率与精度损失之间取得平衡。Qwen3系列的量化版本(GGUF格式)正是通过这种方式将数十亿参数模型塞进普通游戏显卡。代价是:推理速度和输出质量相比全精度版本会有一定损耗,参数量越大、量化位数越高,损耗越小。
实测效果:Flappy Bird与3D地球演示
配置完成后,UP主用本地模型现场做了几个演示项目,效果颇为惊艳:
- 3D地球可视化:一次性生成,可切换白天/黑夜视图、北极光效果,还能调节旋转速度、云层、大气和城市灯光等参数。UP主称这个项目"三分钟就做出来了"。
- Flappy Bird复刻:经典小游戏的翻版,同样在短时间内完成,运行流畅。
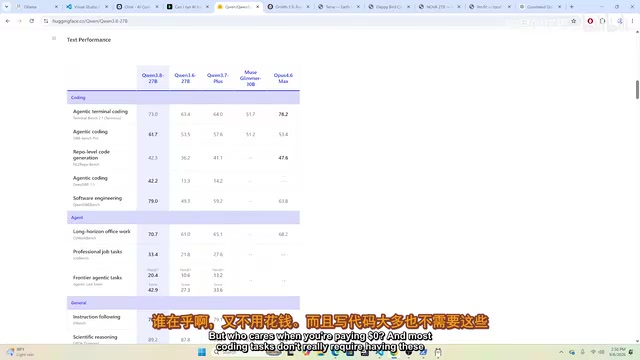
关于性能,UP主给出的对比是:Qwen3编码模型在SWE-Bench Pro上得分约61.7,而作为参照的顶级闭源模型得分53.4(该数字与命名在口播中存在混乱,仅供参考)。他反复强调的核心观点是——半年前需要付费、还常撞Token限制才能用到的编码能力,现在能免费在本地实现。
他也坦言本地开源模型通常比前沿闭源模型"慢几个月",视觉设计的精致度也还有提升空间,但对于日常绝大多数编码任务,这个差距已经无关紧要。
MCP集成与无审查模型
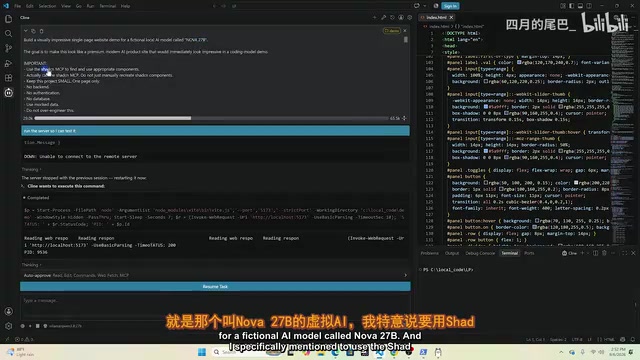
Cline的另一个亮点是支持MCP(Model Context Protocol)。UP主在配置界面里可以自由添加免费或付费的MCP服务,即便使用开源本地模型,也能跑通完整的MCP工作流。他用一段提示词要求模型"用ShadCN做一个视觉冲击力强的单页落地页",最终在完全免费、零Token消耗的前提下生成了效果不错的成品。
视频后半段还提到了一个更进阶的玩法:通过Open Router获取的无审查(uncensored)版本模型,同样可以用Ollama在本地运行。这类模型"几乎不会拒绝任何编码请求",且由于全程本地运行,不会向任何大公司上传数据,隐私性极强。
这一点是本地部署方案最实在的价值所在:无论是成本、限制还是隐私,本地运行都给了开发者更大的掌控权。当然,无审查模型的使用需自行承担合规责任,这一部分UP主未作展开。
**MCP(Model Context Protocol)**是Anthropic于2024年底推出的开放协议,旨在标准化AI模型与外部工具、数据源之间的交互方式。类比USB接口:在MCP出现之前,每个AI应用都需要为每种外部工具单独写集成代码;MCP定义了一套通用的"插头"标准,工具开发者只需实现一次MCP服务,任何支持该协议的AI客户端(如Cline)就能直接调用。常见的MCP服务包括:网页搜索、数据库查询、文件系统操作、GitHub API等。在本地模型场景下,MCP尤其有价值——它能让能力相对有限的本地模型借助外部工具弥补自身短板,完成单纯依赖语言模型参数无法完成的任务。
总结
这套 Ollama + VSCode + Cline 的组合,为拥有中高端显卡的开发者提供了一条完全免费、无限制、高隐私的本地AI编程路径。硬件门槛是最大的现实约束——24G以上显存才能获得接近顶级的体验,8-12G显存则只能退而求其次。对于厌倦了API限制和订阅费用的开发者,这无疑是一个值得动手尝试的方向。
相关推荐
自建AI监控Agent:自动追踪KLSE持仓股新闻
一位马来西亚散户自建AI监控Agent,每30分钟轮询KLSE新闻与Bursa公告,仅在持仓股被点名时通过微信/Telegram/飞书推送。本文解析这个精准静默的个股信息工具及其产品思路。
Ollama本地大模型部署入门:中文手册助你少走弯路
不会安装 Ollama 本地大模型?本文介绍一份覆盖安装部署、模型下载、Modelfile 定制、OpenAI 兼容接口和 GGUF 量化的中文手册,帮新手和开发者快速上手本地大模型,少走弯路。
AI破解图灵未竟难题:Astra与Opus的密码学突破
前沿AI模型Astra与Opus据报正在完成图灵二战时期未竟的密码破译工作,这项'图灵的另一项测试'标志着AI从对话模仿走向硬核逻辑推理,也反映出AI能力评估范式的深刻转变。