Ollama+OpenWebUI 私有化部署:打造团队专属ChatGPT替代方案
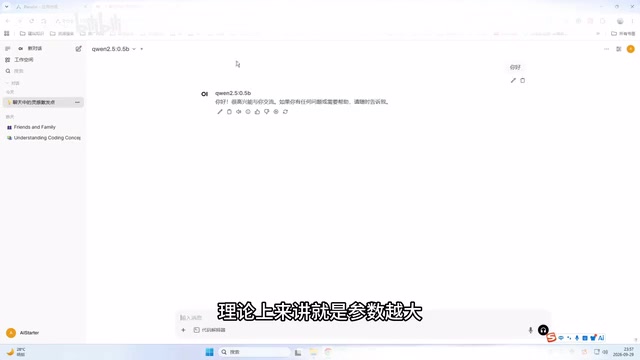
用Ollama和OpenWebUI在私有服务器上部署开源大模型,实现数据不出本地的ChatGPT平替。
本文介绍了以Ollama与OpenWebUI为核心的AI算力私有化部署方案。面对ChatGPT等闭源云服务带来的数据安全隐患和持续订阅成本,私有化部署将开源大模型运行在自有服务器上,实现数据本地化和一次投入多人共用。方案支持独享与全局两种多用户模式,满足团队协作与数据隔离的不同需求;通过节点管理和内网穿透,还可横向扩展算力并对外提供有偿服务。文章同时指出,Ollama与OpenWebUI本身是成熟的免费开源组合,第三方管理面板的价值在于封装了节点调度、运营计费等增值功能,是否付费取决于实际运营需求,个人用户直接使用开源工具完全可行。
为什么要把AI算力私有化
越来越多的企业和个人开始意识到一个现实问题:当下主流的大模型服务——无论是ChatGPT还是Claude——本质上都是闭源的云端服务。使用这些服务意味着两件事:你的数据必须上传到第三方服务器,以及你需要持续支付订阅费或按量计费。
对于注重数据安全、希望控制长期成本的团队来说,这两点都构成了实实在在的痛点。原视频作者(B站UP主熊哥)提出的核心思路很明确:把开源模型部署到自己的服务器上,实现算力和数据的完全私有化。这不仅解决了数据外流的隐患,也让团队可以一次部署、多人共用,摆脱对大厂的持续付费依赖。
私有化部署的价值不止于替代ChatGPT。开源生态里的AI项目远不止对话模型一种——搜索引擎、知识库(DeFi类)、推理框架等都可以本地化落地,根据团队实际需求搭建专属工作流。
Ollama + OpenWebUI 的基础组合
实现私有化对话体验的最小技术栈其实非常清晰:
- Ollama(欧拉玛)或 vLLM:负责运行本地大模型,是算力层的核心
- OpenWebUI:提供类似 ChatGPT 的对话交互界面,是用户使用的前端
两者配合,就能在自己的服务器上获得一个完整的对话式AI应用。按照原视频的演示流程,部署逻辑被简化为「选择节点 → 一键部署 → 点击运行」三步,模型拉起后即可直接对话,让它写方案、写代码都没有问题。
需要强调的一点是模型选择与硬件的关系。原视频演示时为了快速展示,仅加载了一个最小的 0.5B 模型。实际应用中,模型参数越大,能力越强,但对服务器显存和内存的要求也越高。演示用的测试主机配置为 i5-12400F、32GB 内存、22GB 显存级别的显卡——这也提醒我们,私有化部署的实际体验很大程度上取决于你愿意投入多少硬件资源。
Ollama 是一个专为本地运行大语言模型设计的开源工具,支持 macOS、Linux 和 Windows,通过简单的命令行指令即可拉取并运行 Llama、Mistral、Qwen 等数十种开源模型。它在底层封装了模型量化、上下文管理和推理加速等复杂逻辑,对用户暴露出类似 Docker 的使用体验——ollama run llama3 这样一条命令就能启动对话。vLLM 则是另一个主流选择,由 UC Berkeley 团队开发,以高吞吐量和连续批处理(Continuous Batching)著称,更适合多用户并发请求的生产环境,但配置门槛相对更高。OpenWebUI(前身为 Ollama WebUI)是一个开源的前端界面项目,提供对话历史管理、多模型切换、提示词模板、RAG 文档上传等功能,设计上刻意对标 ChatGPT 的交互逻辑,降低普通用户的使用门槛。三者均可通过 Docker 容器一键部署,是目前私有化 AI 部署领域使用最广泛的开源组合。
多用户与团队协作的部署模式
私有化部署真正区别于个人玩票的地方,在于团队协作能力。原视频中提到了两种关键的部署模式:
独享模式 vs 全局模式
像 Ollama 这类项目默认是单实例独立使用——每个人在工作台打开的都是属于自己的独立实例,数据互不干扰。这对于需要数据私有化的个人项目非常适合。
而 OpenWebUI 本身支持多用户,因此可以灵活设置:
- 全局(全集)模式:所有用户共用一台服务器上的同一个实例
- 独享(安息)模式:系统自动调度,哪台服务器有空闲资源就调起哪一台,更加灵活
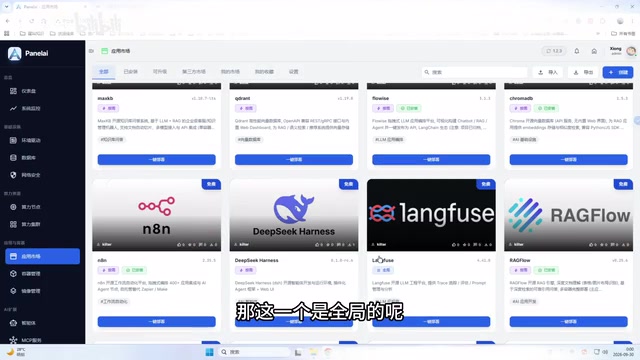
这种设计让团队管理员可以根据项目性质灵活选择——对需要共享协作的场景用全局模式,对强调数据隔离的场景用独享模式。
对外运营与节点管理能力
除了团队内部使用,原视频还演示了一个进阶场景:把私有化算力对外运营。
通过内网穿透工具(视频中称为「一鸣」)绑定端口放出,外部用户就能对接你本地的算力。配套的运营配置允许设置不同的用户权限层级——免费、VIP、专享、即时等,相当于把自建的AI服务变成可对外提供的产品。
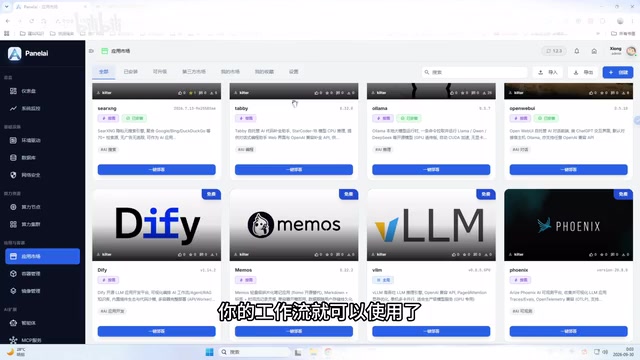
在算力扩展方面,节点管理机制解决了单机性能瓶颈。当一台服务器跑不动时,可以直接增加算力节点,系统通过统一的监控仪表盘管理所有节点状态——包括显卡、CPU、内存的实时占用情况。节点掉线时会有明确提示,开机后一键即可重新接入管理。
内网穿透是指将局域网内的服务器端口映射到公网可访问的地址,使外部用户无需 VPN 即可访问本地部署的服务。常见工具包括 frp、ngrok、Cloudflare Tunnel 等。对于家庭宽带或企业内网没有固定公网 IP 的场景,内网穿透是实现「对外提供服务」的关键基础设施。需要注意的是,将本地算力暴露到公网会引入安全风险——访问控制、HTTPS 加密和速率限制等安全措施是不可忽视的配套要求。多节点管理在架构上类似于轻量级的 GPU 集群调度,核心思路是通过统一的控制面(Control Plane)汇聚多台机器的算力,按需将推理任务分发到有空闲资源的节点,从而突破单机显存瓶颈、提升整体并发能力。
权限控制与应用生态
在应用层面,这套系统提供了细粒度的可见性控制。管理员可以针对每个应用(如视频中演示的「小龙虾」项目)设置是否对前端用户可见——关闭「阴影配置」后,普通用户在前端就看不到该应用。
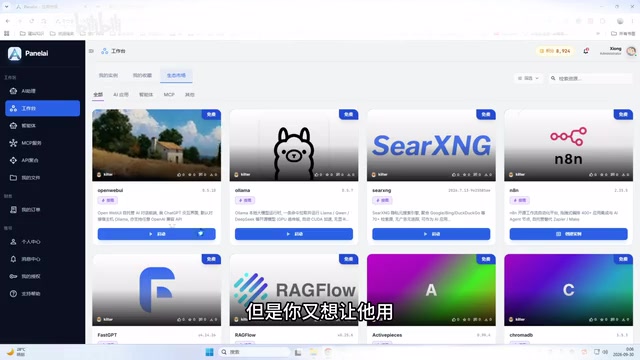
结合前面提到的 VIP 权限分级,管理员可以精确控制「谁能看到什么、谁能用什么」:想让所有人用的就全局开放,想让个别人用的就设为 VIP 专享,既想开放又想限制的则可以配置即时授权。
原视频还提到系统集成了 100 多个应用项目,涵盖本地模型与商用 API 的统一接入,以及 AI 助理、工作台、智能体、MCP、API 契合等功能模块(其中 MCP 服务、智能体等部分功能尚未完全开放)。
客观看待这套方案
需要说明的是,原视频整体带有较强的产品推广属性,作者多次强调自己的系统「目前应该是唯一的」「核心功能已跑通」,并引导观众订阅会员。对于这类自评式的宣传话术,读者应保持理性判断。
从技术角度看,Ollama + OpenWebUI 本身是成熟的开源组合,无需依赖任何第三方管理面板也能独立完成部署——官方文档和社区都有大量公开教程。原视频中演示的「一键部署」面板,本质上是在开源组件之上封装了节点管理、多用户、运营计费等便捷功能,适合不想折腾命令行、有团队运营需求的用户。
如果你只是个人使用,直接用一条命令在 Linux 服务器上部署 Ollama 和 OpenWebUI 完全可行且免费;如果你有团队协作、对外运营、多节点管理的复杂需求,这类封装面板能省去不少运维成本。至于是否值得为其付费,取决于你对这些增值功能的实际依赖程度。
判断是否需要第三方管理面板,有几个实用参考维度:并发用户数——Ollama 默认单并发,若需支持多人同时请求需要额外配置;模型切换频率——频繁在不同模型间切换的团队,统一面板能减少命令行操作成本;计费与权限需求——纯开源方案缺乏原生的用户分级与计费模块,OpenWebUI 提供了基础的多用户权限管理,但商业运营级别的计费逻辑通常仍需二次开发。对于有能力维护 Linux 环境的技术团队,Ollama 官方文档、OpenWebUI GitHub 仓库以及 Reddit 的 r/LocalLLaMA 社区已经覆盖了绝大多数部署场景,无需依赖商业封装产品即可实现完整功能。
小结
AI 算力私有化的趋势背后,是企业对数据主权和成本可控的双重诉求。Ollama 加 OpenWebUI 的组合为这一诉求提供了可落地的技术路径——数据不出本地、团队共享共用、硬件按需扩展。无论你选择纯手工部署还是借助管理面板,理解这套底层逻辑都比追随任何单一产品更重要。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。