Ollama 入门指南:本地部署开源大模型的利器
Ollama 是免费开源的本地大语言模型管理平台,让开发者无需付费即可部署和调用开源模型。
Ollama 是一款面向开发者的开源工具,核心功能是将 DeepSeek、LLaVA 等开源大语言模型便捷地部署到本地机器,彻底摆脱 API 按 token 付费的依赖。它支持 macOS、Windows、Linux 和 Docker 四大平台,提供命令行与 Web UI 两种管理方式,并通过兼容 OpenAI 风格的 API 接口支持 Python、Java 等多语言调用。在硬件层面,Ollama 底层借助量化技术同时兼容 CPU 与 GPU 运行,降低了本地跑大模型的门槛。典型应用场景包括搭建私有知识库、企业内部问答系统等对数据隐私有要求的场合。对于希望进行个性化 AI 开发却不想持续承担云端费用的开发者,Ollama 是值得优先掌握的入门工具。
在线大语言模型用起来方便,但个性化开发时往往绕不开 API 申请与按 token 付费的成本。当越来越多的开源模型(如 DeepSeek、LLaVA 等)出现后,把模型部署到本地、摆脱付费依赖成了不少开发者的选择。而实现这一步的关键工具,就是 Ollama。
什么是 Ollama
Ollama 可以理解为一个大语言模型的管理平台。它的核心作用是帮助用户将开源模型下载、部署到本地机器,并提供统一的方式进行调用和管理。
在没有这类工具之前,想在本地跑一个开源模型并不轻松——你需要自己配置复杂的 GPU 环境,还要看电脑硬件是否支持,即便支持也得折腾一整套依赖。Ollama 把这些流程都封装好了,安装完成后就能直接下载和管理模型。
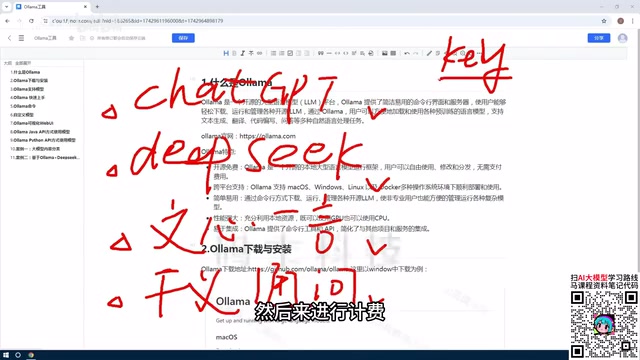
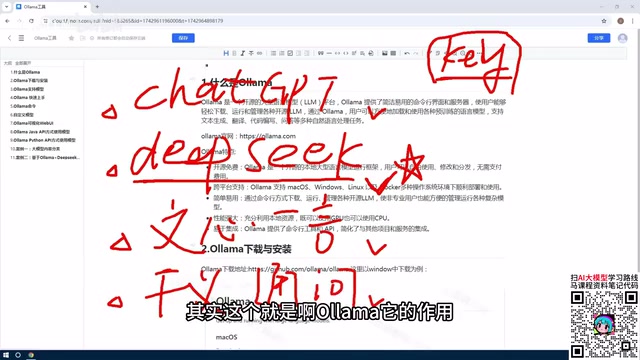
和在线模型的本质区别在于:使用 ChatGPT、DeepSeek 在线版时,你连接的是别人服务器上部署好的模型,聊天可能免费,但一旦通过 API 做个性化开发,就要根据返回 token 的大小计费。而通过 Ollama 部署到本地的模型,调用时不再产生费用,这对需要长期开发或搭建私有应用的团队来说很有吸引力。
为什么选择本地部署
以 DeepSeek 为例,虽然它相比早期的在线服务已经便宜了不少(此前注册还赠送额度,如今取消了),但按 token 计费的模式在高频调用场景下仍是一笔持续开销。
把开源模型部署到本地后,最典型的应用场景之一是搭建私有知识库。你可以基于现有开源模型,灌入企业或个人的私有数据,做私有领域的问答与记忆能力扩展。这类需求在企业内部非常常见,而 Ollama 让实现门槛大幅降低。
需要提醒的是,模型越大对硬件要求越高。最新版的 DeepSeek 模型体积可能达到数百 GB,本地部署时不仅要下载庞大的模型文件,还需要相应的机器资源支撑运行。
私有知识库的技术基础通常是 RAG(检索增强生成)架构:将私有文档切片后转化为向量存入数据库,用户提问时先检索出相关片段,再连同问题一并送入本地模型生成回答。这样既保留了大模型的语言理解能力,又让模型能"读到"它训练时从未见过的私有数据。由于整个链路都在本地运行,敏感数据不会上传到外部服务器,满足企业对数据合规的基本要求。结合 Ollama 部署的本地模型,RAG 应用的单次推理成本几乎为零,高频查询场景下的经济优势尤为明显。
Ollama 的核心特点
免费开源、跨平台
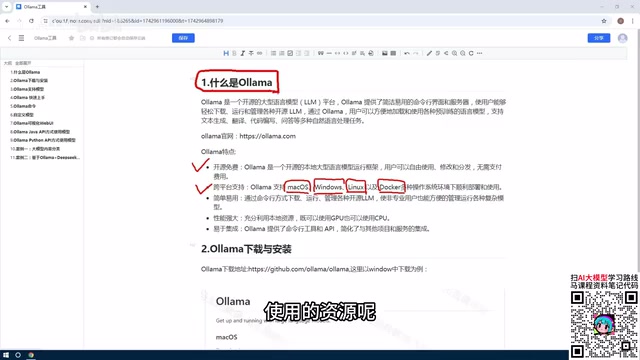
Ollama 完全免费且开源。它支持 macOS、Windows、Linux 以及 Docker 环境。个人学习可以在 Windows 或 Mac 上安装体验;企业部署则更适合选择 Linux 或 Docker 方案。
使用简单,两种交互方式
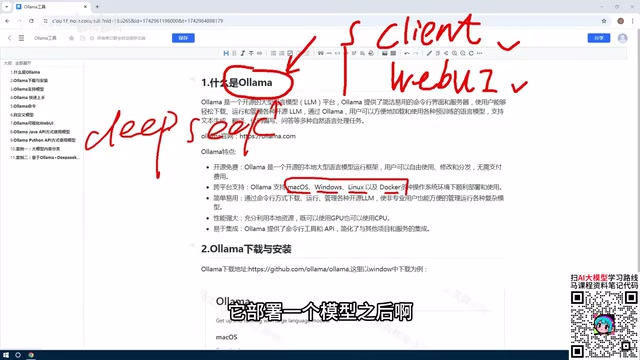
Ollama 提供了两种操作方式:一是**命令行(CLI)**方式,即交互式的终端命令,没有图形界面;二是 Web UI 界面。两种方式都可用来下载、管理、删除和创建模型,用户可以根据习惯选择。
性能强大:CPU 与 GPU 兼顾
这是 Ollama 降低使用门槛的关键一点。通过它管理的模型能够充分利用机器资源——既可以调用 GPU,也可以使用 CPU。这意味着即便硬件条件有限,用户依然能够运行大模型,而不必像过去那样为 GPU 环境配置伤脑筋。
Ollama 在底层依赖 llama.cpp 实现跨硬件推理。llama.cpp 是一个用纯 C/C++ 编写的推理引擎,它引入了 GGUF 量化格式,可以将模型权重从原始的 16 位或 32 位浮点数压缩为 4 位甚至更低精度,从而大幅减小模型体积和显存占用。量化后的模型在精度上略有损失,但推理速度和资源消耗改善显著——一个原本需要 80 GB 显存的 70B 参数模型,经过 4-bit 量化后可能只需 40 GB 左右,普通消费级显卡或纯 CPU 环境也能勉强运行。这正是 Ollama 能够"降低硬件门槛"的技术根源。
扩展性与生态
Ollama 提供了丰富的命令和 API 接口。开发者可以用 Python、Java 等多种语言访问和调用模型,最常见的方式就是通过 API 与本地模型交互。这种开放的接入方式让它很容易嵌入到各类应用开发流程中。
Ollama 的 API 遵循与 OpenAI 接口高度兼容的设计,这意味着大量基于 OpenAI SDK 编写的现有代码,只需把 base_url 指向本地地址(默认为 http://localhost:11434)便可切换到本地模型,几乎不用改动业务逻辑。LangChain、LlamaIndex 等主流 AI 应用开发框架也均已内置对 Ollama 的原生支持,可直接作为 LLM 后端或 Embedding 来源接入,极大降低了将现有项目迁移至本地模型的工程成本。
小结
回顾 Ollama 的价值,可以归纳为三点:
- 它是一个模型管理工具,能把开源模型便捷地部署到本机,调用时不再付费;
- 特点丰富——免费开源、跨平台、支持 API 与命令行两种管理方式;
- 扩展性强,能灵活利用 CPU 或 GPU 资源,降低本地运行大模型的门槛。
对于想要摆脱在线模型付费限制、或需要搭建私有 AI 应用的开发者来说,Ollama 是一个值得优先掌握的入门工具。后续可以从安装配置和命令行操作开始,逐步进入本地大模型开发的实战。
相关推荐
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。
全盲创业者靠Claude做出无障碍产品,卖出1700美元
一位全盲创业者用 Claude 为盲人客户打造无障碍产品并卖出 1700 美元。他的经历揭示了 Vibe Coding 的真相:AI 能写代码,但真正的好体验离不开领域知识,也展现了 AI 赋能残障人群自主构建工具的独特价值。
Datamimic:给AI编程助手一个可控的测试数据世界
Datamimic 是一款开源工具,主张不要让AI编程助手自行编造测试数据。本文解析AI生成测试数据的可靠性隐患,以及可控测试数据世界对开发质量的价值。