Ollama v0.40.7-rc1:MLX与GGML共享CUDA运行时,打包体积瘦身

Ollama 通过去重 CUDA 运行时、划分共享与私有边界,缩小发行包并降低依赖风险。
Ollama v0.40.7-rc1 的核心改动是去重 GGML 与 MLX 两个后端重复携带的 CUDA 运行时库,将其集中到同级 CUDA payload 目录,并同步调整进程内与子进程的 MLX 加载逻辑以解析新路径。改动并未一刀切合并:MLX 私有库与 JIT 头文件仍保留在 MLX overlay,按归属而非体积决定去留;同时要求完整打包 OpenBLAS Fortran 运行时闭包,并在发布打包阶段增加依赖校验作为兜底。对用户而言,下载体积与磁盘占用下降;对维护者而言,发布前验证清单变长,但运行时行为更可预测。这属于典型的发布工程优化,体现"共享归共享、私有归私有、用校验锁定结果"的思路。
一次"去重",两个后端的体积优化
Ollama 发布 v0.40.7-rc1,核心改动只有一行标题:mlx: deduplicate CUDA runtime payloads。这个改动看似平淡,实际指向本地推理工具长期存在的一个工程痛点——当同一个发行包里同时存在 GGML 和 MLX 两套后端时,CUDA 运行时库被重复打包,既浪费体积,也让依赖解析变得复杂。
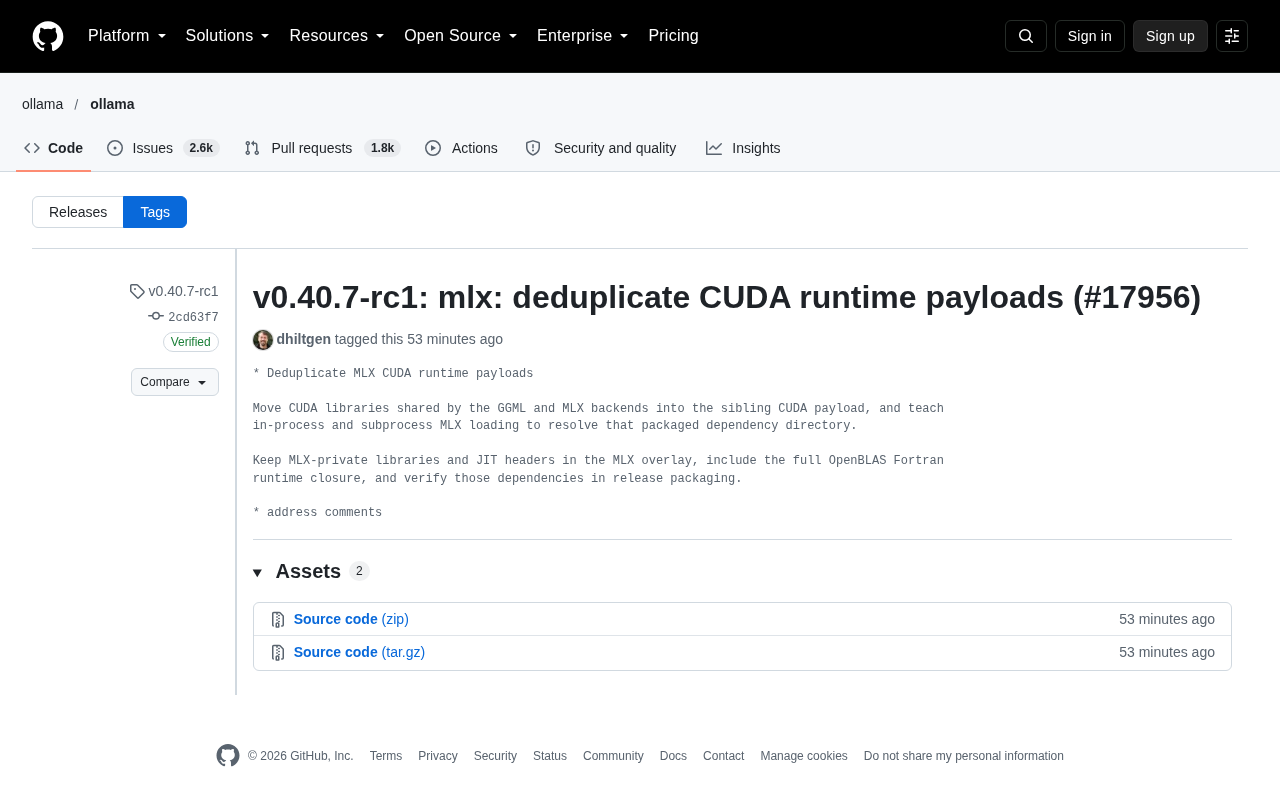
提交由 dhiltgen 完成,采用 GitHub 验证签名。改动本身围绕三个动作展开:移动、保留、验证。
改动拆解:哪些库被搬走,哪些留下
共享库迁移到"兄弟目录"
提交说明写得很明确:把 GGML 与 MLX 后端共享的 CUDA 库,移动到同级(sibling)的 CUDA payload 目录中。也就是说,原本每个后端各自携带一份的 CUDA 运行时,现在集中到一处存放。
随之调整的是加载逻辑:无论是进程内加载还是子进程加载 MLX,都需要能够解析到这个打包后的依赖目录。这属于典型的"改结构就得改加载器"的连锁修改,也解释了为什么一个去重提交会同时触碰打包与运行时两条路径。
CUDA runtime payload 指的是随发行包一起分发的 CUDA 运行时组件集合,典型包括 libcudart、libcublas、libcublasLt、libcudnn 等动态库及其依赖。它们体积可观,单个库常达数百 MB,因此重复携带两份对发行包大小影响显著。Ollama 的打包方式是把这些组件组织成独立的 payload 目录,由加载器在启动时按需定位并加入动态链接搜索路径(如 LD_LIBRARY_PATH 或平台等价机制)。"同级目录"意味着该 payload 位于 GGML 与 MLX 各自后端目录的共同父级下,两个后端都能以相对路径引用同一份文件,从而在物理上只保留一份副本。
MLX 私有库与 JIT 头文件保留原位
去重不等于全部合并。提交中特别说明,MLX 私有的库和 JIT 头文件继续留在 MLX overlay 中。这类文件是 MLX 后端独有的,共享给 GGML 没有意义,强行合并反而会引入耦合。
边界划得很清楚:共享的进公共目录,私有的留在 overlay。这种按归属而非按体积决定去留的做法,是打包工程里比较稳妥的思路。
MLX overlay 是 Ollama 打包体系中的分层概念:基础层提供通用运行时,overlay 层则叠加某个后端专属的文件。MLX 的 JIT(即时编译)头文件之所以不能共享,是因为 MLX 在部分平台上会在运行时用这些头文件编译生成内核代码,头文件版本必须与 MLX 库本身严格匹配;若被 GGML 侧或其他版本的 MLX 覆盖,可能导致编译失败或行为不一致。同理,MLX 私有动态库(如 libmlx)只被 MLX 后端链接,放进公共目录既无收益,又会让 GGML 路径意外依赖到它。把这类文件留在 overlay,等于在目录结构上固化"谁拥有、谁使用"的边界。
OpenBLAS Fortran 运行时闭包被完整纳入
一个容易被忽略的细节是:提交要求包含完整的 OpenBLAS Fortran 运行时闭包(closure)。闭包意味着不仅是顶层库,连带它依赖的运行时组件也要一并打包。MLX 在 macOS 之外的部分平台依赖 OpenBLAS,如果闭包不完整,运行时可能才暴露出缺失符号的问题——这类问题往往在发布后才被用户发现。
运行时闭包(runtime closure) 是打包领域的术语,指一个库及其递归依赖的全部动态库集合。以 OpenBLAS 为例,它依赖 libgfortran、libquadmath、libgcc_s 等 Fortran/GCC 运行时库;若只打包 libopenblas 而遗漏其依赖,程序在开发机上因系统已安装这些库而正常,到了干净的用户环境才在加载或首次调用时报告 undefined symbol 或 cannot open shared object file。要求"完整闭包"意味着打包脚本需要沿依赖图递归收集,而不是仅复制直接引用的文件。这类问题具有隐蔽性和滞后性,因此在发布流程中显式校验闭包完整性是必要的防线。
发布打包阶段增加依赖校验
改动还要求在发布打包流程中对上述依赖进行验证。去重之后,依赖关系从"每个后端自带"变成"公共目录提供",任何打包遗漏都可能导致某个后端在用户机器上加载失败。把校验放进 release 打包环节,是在流水线层面兜底。
GGML 与 MLX 是 Ollama 的两套推理后端。GGML 是 ggml/llama.cpp 生态的底层张量计算库,以 C/C++ 实现、跨平台、支持 CPU 与多种 GPU 加速(CUDA、Metal、Vulkan 等),是 Ollama 在多数平台上运行模型的默认路径。MLX 则是 Apple 为 Apple Silicon 设计的数组计算框架,充分利用统一内存架构,在 M 系列芯片上通常有更好的性能表现。Ollama 在 macOS 上引入 MLX 后端作为可选或默认路径,于是同一个发行包需要同时容纳两套后端。两者虽然计算图实现不同,但都可能在特定平台上调用同一批底层运行时(如 CUDA 相关库),这正是重复打包的根源。
对使用者的实际影响
对普通用户而言,这次改动最直接的结果是发行包中不再存在重复的 CUDA 运行时副本,下载体积和磁盘占用相应减少。对使用 MLX 后端的 Apple Silicon 用户,加载路径的调整需要加载器正确解析新的依赖目录,这也是提交中同时修改进程内与子进程加载逻辑的原因。
对发行维护者来说,多了一层打包校验,意味着发布前的验证清单更长,但换来的是更可预测的运行时行为。
工程视角:为什么这类改动值得关注
本地推理工具的竞争力,很大程度上取决于发行包是否"干净"。GGML 与 MLX 各自演进,共享的底层依赖却越来越多,重复打包会随着版本迭代不断放大。这次提交选择在 CUDA payload 层面做去重,而不是简单删文件,说明维护者在控制耦合范围——共享的归共享,私有的归私有,再用发布校验锁住结果。
这是典型的发布工程(release engineering)工作,不会出现在功能更新日志的显眼位置,却直接影响安装成功率和包体积。v0.40.7-rc1 作为候选版本,仍处于验证阶段,最终行为以正式版为准。
要点回顾
- CUDA 共享库移到同级 CUDA payload 目录,GGML 与 MLX 不再各自携带一份
- MLX 私有库与 JIT 头文件保留在 MLX overlay,避免不必要耦合
- 完整打包 OpenBLAS Fortran 运行时闭包,降低运行时缺符号风险
- 进程内与子进程 MLX 加载逻辑同步调整以解析新依赖目录
- 发布打包阶段新增依赖校验,作为流水线兜底
相关推荐

广告主撤下Meta广告:AI“美化”翻车引发信任危机
Meta的AI广告工具擅自为广告素材添加“美化”效果,引发广告主撤下广告。本文分析事件背后的品牌控制权、合规风险与平台AI工具的设计困境,并给出AI内容工具的三点改进启示。

艾伦·斯蒂尔曼访谈:一场街头鸡尾酒会的商业传奇
基于艾伦·斯蒂尔曼2010年访谈,回顾T.G.I. Friday's从街头派对到连锁品牌的创业历程,解析其社交空间定位、体验标准化与时代红利,提炼可复用的经营哲学。

CowAgent:开源超级AI助手亮相
CowAgent是一款在Hacker News上亮相的开源超级AI助手,本文介绍其定位、开源AI助手的价值与挑战,以及社区反应。