Ollama教程:17万Star的本地大模型运行框架深度解析
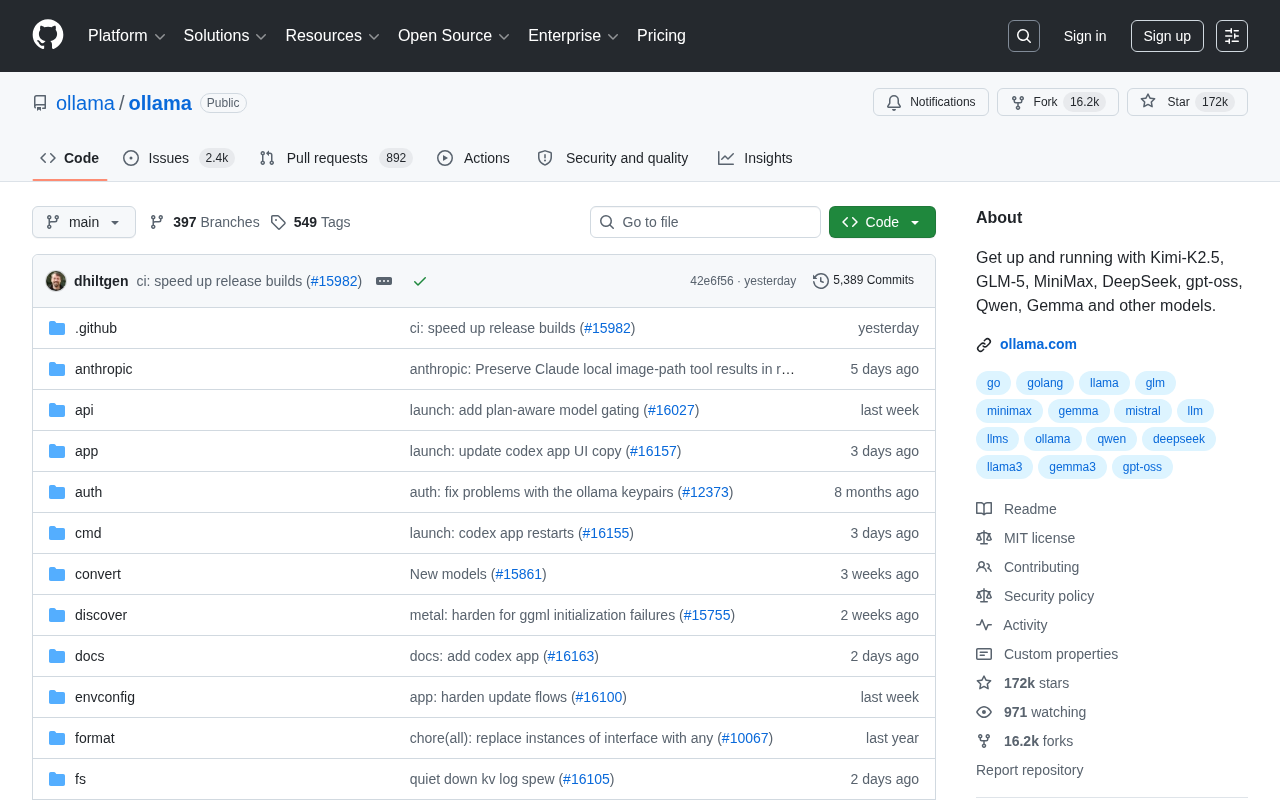
Ollama是GitHub 17万Star的本地大模型运行框架,极简部署,生态广泛
Ollama是用Go语言开发的开源本地大模型运行框架,GitHub超17万Star。它以类Docker的极简命令实现一行跑模型,支持DeepSeek、Qwen、Kimi-K2.5等众多主流模型,并提供兼容OpenAI格式的API接口,可无缝对接LangChain等开发框架。其爆发式增长反映了本地化AI部署需求激增和开源模型生态繁荣的行业趋势。
Ollama 项目概览:GitHub 17万Star的本地大模型框架
Ollama 是一个用 Go 语言编写的开源项目,旨在让用户能够在本地轻松运行各种大语言模型(LLM)。该项目在 GitHub 上已获得超过 17 万颗 Star,Fork 数接近 1.6 万,是目前最受欢迎的本地大模型运行框架之一。
从项目的最新动态来看,Ollama 已经支持了包括 Kimi-K2.5、GLM-5、MiniMax、DeepSeek广告、gpt-oss、Qwen、Gemma 在内的众多主流模型,几乎覆盖了国内外所有热门的开源大模型生态。
为什么 Ollama 如此受欢迎?
一行命令跑模型:极简的使用体验
Ollama 的核心设计哲学是「Get up and running」——让用户以最小的成本把模型跑起来。与传统的模型部署方式相比,Ollama 将模型下载、量化、推理引擎配置等复杂步骤封装成了类似 Docker 的简洁命令。
用户只需一行命令即可完成模型的拉取和启动:
ollama run deepseek
这种设计大幅降低了本地部署 LLM 的技术门槛,即使没有深度学习背景的开发者也能在几分钟内跑通整个流程。
Ollama 借鉴了 Docker 的容器化设计哲学,引入了 Modelfile 的概念。Go 语言由 Google 于 2009 年发布,其静态链接特性意味着编译产物是一个自包含的二进制文件,不依赖系统动态库,这与 Docker 的「Build once, run anywhere」理念高度契合。用户可以像编写 Dockerfile 一样,通过 Modelfile 定义模型的运行配置,包括基础模型选择、系统提示词、温度参数、上下文窗口大小等,实现模型运行环境的标准化和可复现。
Ollama 支持的模型列表
从最新的项目描述可以看出,Ollama 的模型生态正在快速扩展:
- 国产大模型:Kimi-K2.5(月之暗面)、GLM-5(智谱)、DeepSeek、Qwen(通义千问广告)、MiniMax
- 国际大模型:Gemma(Google)、gpt-oss 等
- 经典开源模型:Llama、Mistral、Phi 等主流开源模型
Kimi-K2.5 和 GLM-5 等最新模型的快速接入,说明 Ollama 团队在紧跟模型发布节奏方面做得相当出色。对于希望第一时间体验新模型的开发者来说,这一点极具吸引力。
Go 语言技术选型带来的优势
Ollama 选择 Go 作为主要开发语言,这一技术决策带来了几个实际好处:
- 跨平台编译简单:Go 天然支持交叉编译,使得 Ollama 能够轻松覆盖 macOS、Linux、Windows 三大平台
- 单二进制分发:无需复杂的依赖管理,下载即用,不会遇到 Python 环境那样的依赖冲突问题
- 高效的并发处理:Go 的 goroutine 机制非常适合处理模型推理中的并发请求场景
Go 语言的设计目标是解决大规模软件工程中的编译速度、依赖管理和并发编程问题。其 goroutine 是一种轻量级协程,创建成本仅为几 KB 内存,配合 channel 通信机制,可以高效处理数千个并发连接。这使得 Ollama 在作为本地 API 服务运行时,能够流畅地处理来自多个客户端的同时请求,而不会像传统线程模型那样产生大量资源开销。
17 万 Star 背后的行业趋势
Ollama 的爆发式增长并非偶然,它反映了几个正在发生的重要行业变化。
本地化部署需求持续增长
随着数据隐私意识的提升和企业合规要求的加强,越来越多的用户和组织希望在本地运行大模型,而非将敏感数据发送到云端 API。Ollama 恰好填补了这一需求空白,提供了一个轻量级、开箱即用的本地推理方案。
开源模型生态的全面繁荣
2024 到 2025 年是开源大模型集中爆发的时期。DeepSeek、Qwen、Kimi-K2.5 等高质量开源模型的密集发布,为 Ollama 这样的运行框架提供了丰富的内容支撑。可用的模型越多,Ollama 的实用价值就越大——这形成了一个正向飞轮效应。
与主流AI开发框架无缝集成
Ollama 不仅仅是一个模型运行工具。它提供了兼容 OpenAI 格式的 API 接口,开发者可以直接对接 LangChain、LlamaIndex 等主流 AI 开发框架,无需修改已有代码。这种生态兼容性极大地拓展了 Ollama 的应用场景,从简单的对话测试到复杂的 RAG 系统搭建都能胜任。
OpenAI 的 Chat Completions API 已成为 LLM 应用开发的事实标准接口,其核心端点 /v1/chat/completions 定义了 messages 数组、temperature、max_tokens 等统一参数格式。Ollama 实现这一接口意味着,任何基于 OpenAI SDK 开发的应用只需将 base_url 修改为本地端口(默认为 localhost:11434),即可零代码改动切换到本地模型推理。这极大降低了从云端 API 迁移到本地部署的工程成本,也让开发者可以在开发阶段使用免费的本地模型进行调试,上线时再切换到云端服务。
Ollama 适用场景与使用建议
推荐使用 Ollama 的场景
- 个人开发者:快速体验和横向评测各类开源大模型的效果
- 中小团队:在内网环境中部署 AI 能力,保障数据不出域
- RAG 应用开发:构建基于本地模型的检索增强生成系统
- 教育与科研:模型实验、课程教学、论文复现等学术场景
RAG(Retrieval-Augmented Generation,检索增强生成)是当前最热门的 LLM 应用架构之一。其核心流程是:先将用户查询通过向量化检索(通常使用 Embedding 模型将文本转换为高维向量,再通过余弦相似度等方法匹配)从知识库中找到相关文档片段,然后将这些片段作为上下文注入到 LLM 的提示词中,让模型基于真实数据生成回答。这种方式有效缓解了 LLM 的「幻觉」问题(即模型编造不存在的事实),同时避免了对整个模型进行微调的高昂成本。Ollama 同时支持对话模型和 Embedding 模型的本地运行,使得整个 RAG 管线都可以在本地完成。
使用前需要了解的限制
- 硬件要求:本地运行大模型对显存有一定要求,7B 模型建议至少 8GB 显存,70B 模型则需要更高配置
- 量化精度损失:为了降低资源占用,Ollama 默认使用量化模型,在某些任务上精度会有所下降
- 生产环境局限:高并发的生产环境可能需要更专业的推理框架,如 vLLM 或 TGI
关于量化技术,这里需要做进一步说明。量化(Quantization)是将模型参数从高精度浮点数(如 FP32 占 4 字节、FP16 占 2 字节)转换为低精度表示(如 INT8 占 1 字节、INT4 占 0.5 字节)的压缩技术。以一个 7B 参数的模型为例,在 FP16 精度下需要约 14GB 显存加载,而经过 4-bit 量化后仅需约 4GB,使得消费级显卡(如 RTX 3060 12GB)也能流畅运行。Ollama 默认采用的 GGUF 格式由 llama.cpp 项目定义,支持 Q4_0、Q4_K_M、Q5_K_M 等多种量化级别,用户可根据自身硬件条件在模型体积、推理速度和输出质量之间灵活权衡。一般而言,Q4_K_M 是性能与质量的最佳平衡点。
对于生产环境的推理需求,vLLM 和 TGI 代表了不同的技术路线。vLLM 是 UC Berkeley 开发的高性能推理引擎,其核心创新是 PagedAttention 技术——通过类似操作系统虚拟内存的分页机制管理 KV Cache(Transformer 注意力机制中缓存的键值对),将显存利用率提升了 2-4 倍,显著提高了批处理吞吐量。TGI(Text Generation Inference)则是 Hugging Face 推出的生产级推理服务,支持连续批处理(Continuous Batching)和张量并行(Tensor Parallelism)等企业级特性。相比之下,Ollama 更侧重单用户或小规模场景的易用性,而非极致的吞吐量优化,两者定位互补而非竞争。
总结
Ollama 凭借极简的设计理念和广泛的模型支持,已经成为本地运行大模型的标杆工具。GitHub 上 17 万 Star 的成绩不仅是社区对项目本身的认可,更折射出整个行业对本地化、隐私友好的 AI 部署方案的迫切需求。
随着 DeepSeek、Qwen、Kimi 等更多高质量开源模型的持续涌现,Ollama 的生态价值还将进一步放大。如果你正在寻找一个简单可靠的本地大模型运行方案,Ollama 无疑是当前最值得尝试的选择。
核心要点
- Ollama 在 GitHub 获得超过 17 万 Star,是最受欢迎的本地大模型运行框架之一
- 已支持 Kimi-K2.5、GLM-5、MiniMax、DeepSeek、Qwen、Gemma 等众多主流开源模型
- 采用 Go 语言开发,提供类 Docker 的极简命令行体验,大幅降低本地部署门槛
- 项目的爆发式增长反映了本地化 AI 部署需求激增和开源模型生态繁荣的行业趋势
- 提供兼容 OpenAI 格式的 API 接口,可无缝对接主流 AI 开发框架
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。