Ollama保姆级教程:本地部署AI大模型完全指南

什么是Ollama?
Ollama是一款开源免费的本地大模型管理平台,它让普通用户也能轻松地在自己的电脑上部署和运行各类开源AI大模型。简单来说,Ollama就像是AI模型的"管家"——你不需要懂复杂的环境配置,不需要折腾GPU驱动,只需要几条简单的命令,就能把DeepSeek广告、Llama、Qwen等热门开源模型跑在本地。
这里提到的三款模型代表了当前开源大模型的三大阵营:Llama由Meta(原Facebook)开源发布,是目前全球使用最广泛的开源基座模型之一;Qwen(通义千问广告)由阿里巴巴达摩院推出,在中文理解和生成方面表现突出;DeepSeek则由深度求索公司开发,以极高的性价比和出色的推理能力在2024-2025年迅速崛起。正是这些高质量开源模型的涌现,催生了Ollama这类本地部署工具的繁荣发展。
事实上,2023-2025年间开源大模型经历了爆发式增长。Meta的Llama系列从Llama 1到Llama 3,参数规模从7B扩展到405B,推动了整个开源社区的繁荣。与此同时,Mistral、Phi、Gemma等模型也纷纷涌现,形成了百花齐放的格局。这种开源浪潮的背后是一个重要趋势:大模型正在从云端API走向本地部署,从企业专属走向个人可用。Ollama正是在这一趋势下应运而生的关键基础设施工具。
更重要的是,通过Ollama部署的模型完全运行在本地,使用时无需付费、无需联网,数据也不会外泄。对于企业用户来说,还可以基于现有模型灌入私有知识库,构建专属的AI问答机器人,这在实际业务场景中非常常见。这里所说的"灌入私有知识库",实际上指的是RAG(Retrieval-Augmented Generation,检索增强生成)技术——先将企业内部文档(如产品手册、FAQ、技术文档等)切分为小段文本并转化为向量存入向量数据库,当用户提问时,系统先从知识库中检索最相关的内容片段,再将这些片段作为上下文传递给大模型生成回答。这种方式既能利用大模型的语言生成能力,又能确保回答基于企业真实数据,有效避免模型"幻觉"(即生成看似合理但实际错误的内容)问题。
值得补充的是,RAG技术中提到的向量数据库(如Chroma、Milvus、Pinecone等)是一种专门用于存储和检索高维向量的数据库系统。文本被转化为向量的过程称为Embedding(嵌入),它通过专门的嵌入模型将文字映射到高维数学空间中,语义相近的文本在这个空间中距离更近。检索时通过余弦相似度等算法快速找到最相关的内容片段,整个过程通常在毫秒级完成。Ollama本身也支持运行嵌入模型(如nomic-embed-text),可以作为RAG系统中的嵌入服务使用。

Ollama的核心特点
开源免费,跨平台支持
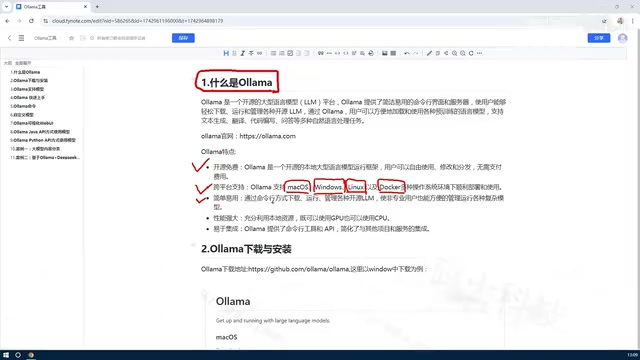
Ollama完全开源免费,支持macOS、Windows、Linux以及Docker等多种运行环境。个人用户可以直接在Windows或Mac上安装体验;企业用户则可以选择Linux服务器或Docker容器化部署,灵活性非常高。
对于企业场景而言,Docker部署是更为推荐的方式。Docker是一种轻量级的容器化技术,它将应用程序及其所有依赖打包成一个标准化的容器镜像,确保在任何环境中都能一致运行。Docker的核心概念包括镜像(Image)、容器(Container)和仓库(Registry)——镜像是只读的应用模板,容器是镜像的运行实例,仓库则用于存储和分发镜像。在AI部署场景中,Docker还支持NVIDIA Container Toolkit(原nvidia-docker),允许容器内的应用直接访问宿主机的GPU资源,这意味着在Docker中运行Ollama同样可以获得GPU加速能力,而不会因为容器化而损失性能。
使用Docker部署Ollama的优势在于:环境隔离避免与其他服务冲突、便于横向扩展和负载均衡、支持通过Docker Compose编排多服务架构(如同时部署Ollama后端和Open WebUI前端),以及方便通过CI/CD流水线实现自动化运维。
简单易用,上手门槛低
Ollama提供了两种主要的交互方式:
- 命令行(CLI)方式:通过简洁的命令即可完成模型的下载、运行、管理等操作
- API方式:提供RESTful API接口,方便与其他应用程序集成
Ollama的RESTful API默认监听在本地11434端口,其API格式与OpenAI的API高度兼容。OpenAI的Chat Completions API已经成为AI应用开发的事实标准接口,其核心端点包括/v1/chat/completions(对话补全)、/v1/embeddings(文本嵌入)等。Ollama兼容这套接口意味着许多已经对接了OpenAI接口的应用(如Chatbox、Dify、LangChain等主流AI开发框架和工具)只需修改API地址即可无缝切换到本地Ollama模型,无需重写代码。开发者甚至可以在开发阶段使用本地免费模型进行调试,在生产环境中根据需要灵活切换到云端API,实现开发成本和部署灵活性的最优平衡。这种兼容性设计是Ollama生态快速壮大的重要原因之一。
此外,社区还有丰富的第三方UI工具(如Open WebUI)可以搭配使用,让不习惯命令行的用户也能通过图形界面管理模型。
自动适配硬件,性能优化到位
Ollama的一大亮点是自动处理GPU/CPU的调度问题。在没有Ollama之前,想要在本地跑大模型,你需要手动配置CUDA环境、安装各种驱动,过程繁琐且容易出错。
这里有必要解释一下CUDA——它是NVIDIA推出的并行计算平台和编程模型,允许开发者利用GPU的大规模并行处理能力来加速计算密集型任务。大模型推理本质上是大量矩阵运算,而GPU拥有数千个计算核心,天然适合这类并行计算任务。更具体地说,大模型推理的核心计算是Transformer架构中的注意力机制(Attention Mechanism),它涉及大量的矩阵乘法运算。以一个7B参数的模型为例,单次推理可能涉及数十亿次浮点运算。CPU通常只有几个到几十个核心,而现代GPU(如NVIDIA RTX 4090)拥有超过16000个CUDA核心,能够同时处理大量并行计算任务——这就是为什么GPU推理速度可以比CPU快10-100倍的根本原因。
传统部署方式需要手动安装匹配版本的CUDA Toolkit、cuDNN深度学习加速库以及对应的显卡驱动,版本之间的兼容性问题是最常见的报错原因,往往让初学者望而却步。AMD显卡则通过ROCm平台提供类似的GPU加速能力,Ollama对NVIDIA和AMD两者都提供了支持。
而Ollama将这一切都封装好了——如果你的电脑有独立显卡(NVIDIA或AMD),它会自动检测并利用GPU加速推理;如果没有独立显卡,也能退回到CPU模式运行,只是速度会慢一些。对于Apple Silicon(M1/M2/M3/M4系列芯片)的Mac用户,Ollama还能利用其统一内存架构和Metal GPU加速框架,在没有独立显卡的情况下也能获得相当不错的推理性能。这种"开箱即用"的设计理念,正是Ollama受到广泛欢迎的关键原因。
扩展性强,支持多语言调用
Ollama支持Python、Java、JavaScript等多种编程语言的调用方式。开发者可以通过官方API或社区SDK,将本地模型无缝集成到自己的应用中。这意味着你可以用Ollama作为后端,快速搭建一个私有化的AI应用。
在Python生态中,除了直接调用HTTP API外,还可以使用ollama-python官方SDK或通过LangChain、LlamaIndex等主流AI应用开发框架来调用Ollama。LangChain提供了ChatOllama集成组件,LlamaIndex则提供了Ollama的LLM和Embedding接口封装,这些框架大大简化了基于本地模型构建复杂AI应用(如多轮对话、Agent智能体、RAG系统等)的开发工作。
Ollama下载与安装实战
第一步:下载Ollama安装包
访问Ollama官网 ollama.com,页面非常简洁,点击「Download」按钮即可看到三个平台的下载选项:
- macOS:下载DMG安装包
- Linux:提供一键安装命令(
curl -fsSL https://ollama.com/install.sh | sh) - Windows:下载EXE安装包
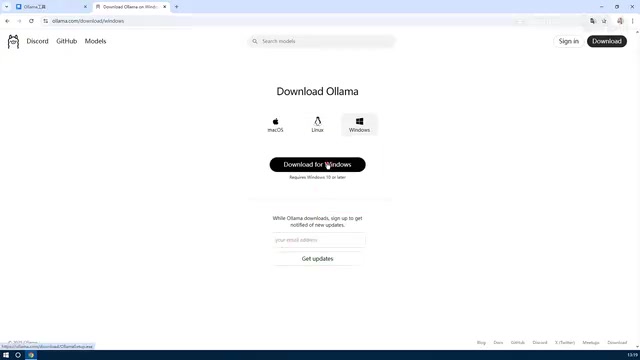
另外,你也可以通过Ollama的GitHub仓库下载安装包,GitHub页面上同样提供了Windows、macOS、Linux和Docker的安装方式。Windows安装包大约1GB左右,下载时建议开启稳定的网络环境。
第二步:安装Ollama到本地
以Windows系统为例,双击下载好的OllamaSetup.exe安装包,会弹出一个简洁的安装界面,直接点击「Install」即可。
安装路径说明:Ollama会固定安装到以下路径,且无法自定义修改:
C:\\\\Users\\\\{你的用户名}\\\\AppData\\\\Local\\\\Programs\\\\Ollama

安装过程只需等待几分钟,完成后点击「Finish」即可。
第三步:验证Ollama是否安装成功
安装完成后,注意观察电脑右下角的系统托盘区域,会出现一个羊驼图标(Ollama的Logo就是一只羊驼)。看到这个图标,说明Ollama已经成功安装并在后台运行了。
提示:Ollama安装后默认开机自启动,无需手动开启。
你也可以打开命令提示符(CMD)或PowerShell,输入以下命令验证:
ollama --version
如果正确返回版本号,说明安装成功。
Ollama模型存储与磁盘空间规划
这里有一个非常重要的提醒:安装Ollama之前,请确保C盘至少预留10GB以上的可用空间。
原因很简单——Ollama本身只有1GB左右,但后续你通过它下载的开源模型都会存储在本地。不同模型的体积差异很大:
| 模型规模 | 大致体积 | 适用场景 |
|---|---|---|
| 小型模型(1-3B参数) | 几百MB~2GB | 轻量级对话、测试 |
| 中型模型(7-14B参数) | 3~8GB | 日常使用、开发调试 |
| 大型模型(70B+参数) | 几十GB~上百GB | 专业场景、高质量生成 |
这里的B代表Billion(十亿),即模型包含的参数数量。参数量是衡量模型规模的核心指标——参数越多,模型理论上能学习到的知识和模式就越丰富,生成质量也越高,但对硬件的要求也成倍增长。值得注意的是,表格中的体积是经过**量化(Quantization)**处理后的大小。量化是一种模型压缩技术,通过降低参数的数值精度(例如从16-bit浮点数降到4-bit整数)来大幅减少内存占用和计算量,同时尽量保持模型的输出质量。
常见的量化级别包括FP16(16-bit浮点)、INT8(8-bit整数)、INT4(4-bit整数)以及更激进的2-bit量化。Ollama默认使用的GGUF格式(由llama.cpp项目定义)支持多种量化方案,如Q4_0、Q4_K_M、Q5_K_M、Q8_0等,其中Q4_K_M是目前社区公认的质量与体积平衡最佳的方案。量化虽然会带来一定的精度损失,但在4-bit级别,大多数用户在日常对话中几乎感知不到质量差异。以7B模型为例,原始的16-bit版本约需14GB显存,而4-bit量化后仅需约4GB显存即可流畅运行,这也是为什么普通消费级显卡也能跑大模型的关键原因。
这里提到的GGUF格式值得进一步说明——它是llama.cpp项目(一个用纯C/C++实现的大模型推理引擎)定义的模型文件格式,Ollama的底层推理引擎正是基于llama.cpp构建的。GGUF格式的优势在于它将模型权重和元数据(如分词器配置、模型架构参数等)打包在单个文件中,便于分发和加载,同时支持灵活的量化配置和CPU/GPU混合推理(即模型的一部分层在GPU上运行,另一部分在CPU上运行),这使得即使显存不足以加载整个模型,也能通过部分卸载到内存的方式运行更大的模型。
对于大多数个人用户来说,7B左右的模型(约3-5GB)就能满足日常需求,性价比最高。建议至少预留10GB空间,以便同时存放2-3个常用模型。如果C盘空间确实紧张,可以通过设置环境变量OLLAMA_MODELS来将模型存储路径指向其他磁盘分区。
总结
Ollama的核心价值可以用三句话概括:
- 降低门槛:将复杂的模型部署流程简化为"一键安装+一条命令",零基础用户也能上手
- 本地私有:模型运行在本地,数据不外泄,使用不付费,特别适合企业私有化部署
- 生态丰富:支持多平台、多语言、多种交互方式,扩展性极强
安装好Ollama只是第一步,接下来你就可以通过ollama pull命令下载心仪的开源模型,开始你的本地AI之旅了。无论是个人学习、开发调试,还是企业级的私有知识库搭建,Ollama都是目前最值得推荐的本地模型管理工具之一。
核心要点
相关推荐

WorkBuddy实战:桌面AI智能体自动化办公与购物全解析
深度解析腾讯WorkBuddy桌面AI智能体的核心能力:打通微信、飞书、钉钉、百度网盘,实现文件整理、周报生成、PDF数据提取与浏览器自动购物。结合B站256集实战教程,分析标准任务与审美任务的执行边界,以及OpenCLI桥接、登录态复用等落地细节。

Copilot使用指标升级:自定义技能与代理可命名追踪
GitHub Copilot使用指标更新:自定义技能、代理、MCP服务器和插件现在可按名称追踪,每个列表容量从5提升至25,帮助管理员精确评估内部AI工具的采用率与投入产出。

亚马逊封杀AI代理,沃尔玛却开门迎客:零售入口争夺战
亚马逊在法庭和防火墙层面封堵AI购物代理,沃尔玛却推出官方MCP服务器允许代理搜索和下单。本文分析两大零售巨头对AI代理的相反策略、代理接入的消费限额与交易审批机制,以及开发者应如何按平台规则构建AI购物代理。