Ollama本地部署大模型全攻略:零成本实现Token自由
Ollama让本地部署大模型像装普通软件一样简单,免费、离线、数据不外传。
Ollama 是目前 GitHub 上最热门的本地大模型部署工具(star超18万),旨在解决云端大模型的收费、隐私和断网痛点。它支持 Windows/Mac/Linux 全平台,安装全程无需命令行,能自动识别显卡并加速。模型选型的核心原则是量力而行:4B模型约3GB、适合轻薄本入门,8B满足日常使用,27B以上则需要高端显卡。推荐模型包括中文最佳的 Qwen 3、推理见长的 DeepSeek R1 和综合能力强的 Llama 3.1。对开发者而言,Ollama 兼容 OpenAI API 格式,现有项目只需修改 base URL 即可从云端无缝切换到本地,迁移成本几乎为零。
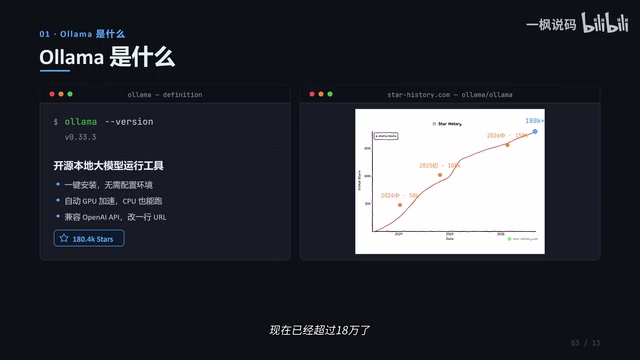
云端大模型虽然方便,但用久了会发现几个绕不开的痛点:API调用按量收费越用越贵、部分服务要求绑卡实名、公司代码和个人文档往云端传总归不放心、断网时直接罢工。这些问题,用一款开源工具就能一次解决——它就是 Ollama,目前 GitHub 上最火的本地大模型部署工具,三年时间star数已经突破18万。
本文根据B站UP主的实战教程整理,从安装、选型到开发者调用,把本地部署这件事一次讲清楚。
Ollama是什么,为什么值得用
Ollama 本质上是一个帮你在本地跑大模型的工具。它最大的价值在于降低门槛:不用手动配环境、不用装驱动,安装后会自动识别你的显卡,能加速就加速,没显卡也能退回到 CPU 运行。
从star增长曲线看,这个项目2023年启动,2024年中达到5万,2025年突破10万,如今已超过18万,是本地部署赛道当之无愧的头部工具。
它的核心优势可以概括为三点:完全免费、数据不出本机、Windows/Mac/Linux 全平台支持。对于注重隐私和成本的用户来说,这三条几乎是刚需。
安装:全程无需敲命令
以 Windows 为例,流程非常简单:打开 Ollama 官网下载页,点击 Download for Windows,双击运行安装包,点 Install,等进度条走完即可。整个过程不需要输入任何命令,Mac 和 Linux 的流程也基本一致。
这里有一个新手最容易忽略的坑:Ollama 默认安装在 C 盘,模型也会存在 C 盘。而一个模型动辄几十 GB,C 盘很容易被塞满。
建议在安装阶段就自定义路径:安装命令后加上 DIR 参数指定目录,装完后再到设置里修改 Model Location。这样软件本体和模型文件都不会挤占系统盘空间,后续管理也更清爽。
模型选型:看配置,别盲目求大
模型名字后面的数字(如4B、8B)代表参数量,数字越大越"聪明",但对硬件的要求也越高。选型的核心逻辑就是量力而行:
- 4B左右:约3GB,6GB内存即可运行,轻薄本也流畅,适合刚上手试水;
- 7B~8B:约5GB,需8GB显存,日常对话、写代码都够用,是大多数人的最佳选择;
- 14B以上:需16GB内存,适合对回答质量要求更高的场景;
- 27B~32B:需24GB显存显卡,是追求高质量输出的高端选择。
一句话总结:不知道选什么就从4B起步,8B满足日常,有好显卡再上27B。
主流模型怎么挑
具体到模型品牌,教程推荐了四个主流选项:
- Llama 3.1(Meta):综合能力最强,最通用;
- DeepSeek R1(深度求索):擅长深度思考和推理;
- Qwen 3(阿里通义千问):中文效果最好;
- Gemma 3(谷歌):多模态,能看图、听声音。
对新手而言,中文场景选 Qwen 3 的4B版本,想要全能表现选 Llama 3.1 的8B版本,基本能覆盖绝大多数需求。
这里的参数量(Parameter)指模型中可训练权重的数量,通常以"B"(Billion,十亿)为单位。参数量越大,模型能记住的知识和处理复杂任务的能力通常越强,但同时对内存/显存的占用也成正比增长。本地运行时,模型文件会被加载进显存(有独显时)或内存(仅CPU运行时),因此显存/内存大小直接决定了你能跑多大的模型。此外,模型通常以量化压缩版本发布(如Q4、Q8),Q4意味着每个参数用4位精度存储,会损失少量精度但大幅减小体积——Ollama默认下载的就是量化版本,这也是为什么4B模型只需约3GB而非更多空间的原因。
两种使用方式:客户端与命令行
下载和使用模型有两条路径。第一种是用 Ollama 自带的客户端,选好模型直接发消息,程序会自动下载,对新手最友好。
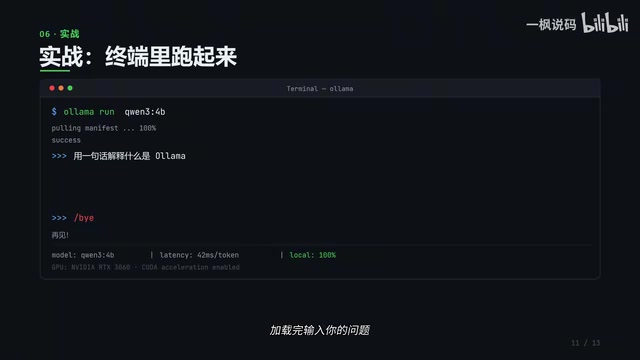
第二种是命令行,更灵活:ollama pull 下载模型,ollama run 下载并启动,ollama list 查看已安装的模型。第一次启动会自动下载,之后就能直接调用。
实测运行时,输入 ollama run qwen3:4b 回车,加载完成后就能开始提问。回答会一个字一个字往外蹦,体验与云端几乎一致,区别只在于——它完全在你自己的电脑上运行,不花钱、不联网、数据也不上传。
开发者视角:兼容OpenAI API
Ollama 对开发者格外友好,它兼容 OpenAI 的 API 格式。你可以继续使用熟悉的 OpenAI SDK,只需把 base URL 指向本地的 11434 端口,API Key 随便填一个,model 参数写本地模型名字,其他调用方式与云端完全一样。
这意味着现有项目几乎零改造成本——改个地址就能从云端无缝切换到本地。对于想控制成本或有数据合规要求的团队,这是极具吸引力的一点。
此外,最新版本还带来了不少能力升级:支持多模态(Gemma 3 可看图、听声音)、支持工具调用(模型可主动调用外部接口)、支持深度思考模式、全平台 GPU 加速(NVIDIA、Apple 芯片、AMD 均可)。近期还新增了接入 ChatGPT 和 Claude 桌面端模型的能力,可以把本地模型当云端模型来用。
OpenAI API 是目前大模型领域事实上的接口标准。它定义了一套通用的 HTTP 请求格式,开发者通过向 /v1/chat/completions 等端点发送结构化 JSON 即可与模型交互。由于绝大多数主流大模型服务(包括 Claude、Gemini 等)都提供了兼容此格式的接口,围绕它开发的 SDK、框架(如 LangChain、LlamaIndex)和工具链极为丰富。Ollama 在本地启动后会监听 localhost:11434,并模拟同一套接口规范,因此任何使用 OpenAI SDK 编写的代码,只需将 base_url 由 https://api.openai.com/v1 改为 http://localhost:11434/v1,即可将请求从云端重定向到本地模型,无需修改业务逻辑。
新手避坑指南
实际使用中,有几个常见问题值得提前了解:
- 显存不够:Ollama 会自动改用 CPU 运行,速度会慢但仍可用,建议稳妥起见跑8B以内的模型;
- 下载慢:大模型体积大,网络不好时可以挂后台下载,或配置镜像加速;
- 端口冲突:默认
11434端口若被占用,改个环境变量即可解决。
其余问题查阅官方文档基本都能找到答案。
结语
Ollama 用一键安装、自动加速、简单命令三板斧,把本地大模型的门槛降到了新手也能上手的程度。选模型看配置,4B起步、8B日常够用;开发者还能借助 OpenAI 兼容接口无缝迁移。对于关注成本、隐私和离线可用性的用户,它几乎是当下最优解——三分钟即可拥有一个零成本、全私有、离线可用的本地大模型。
相关推荐
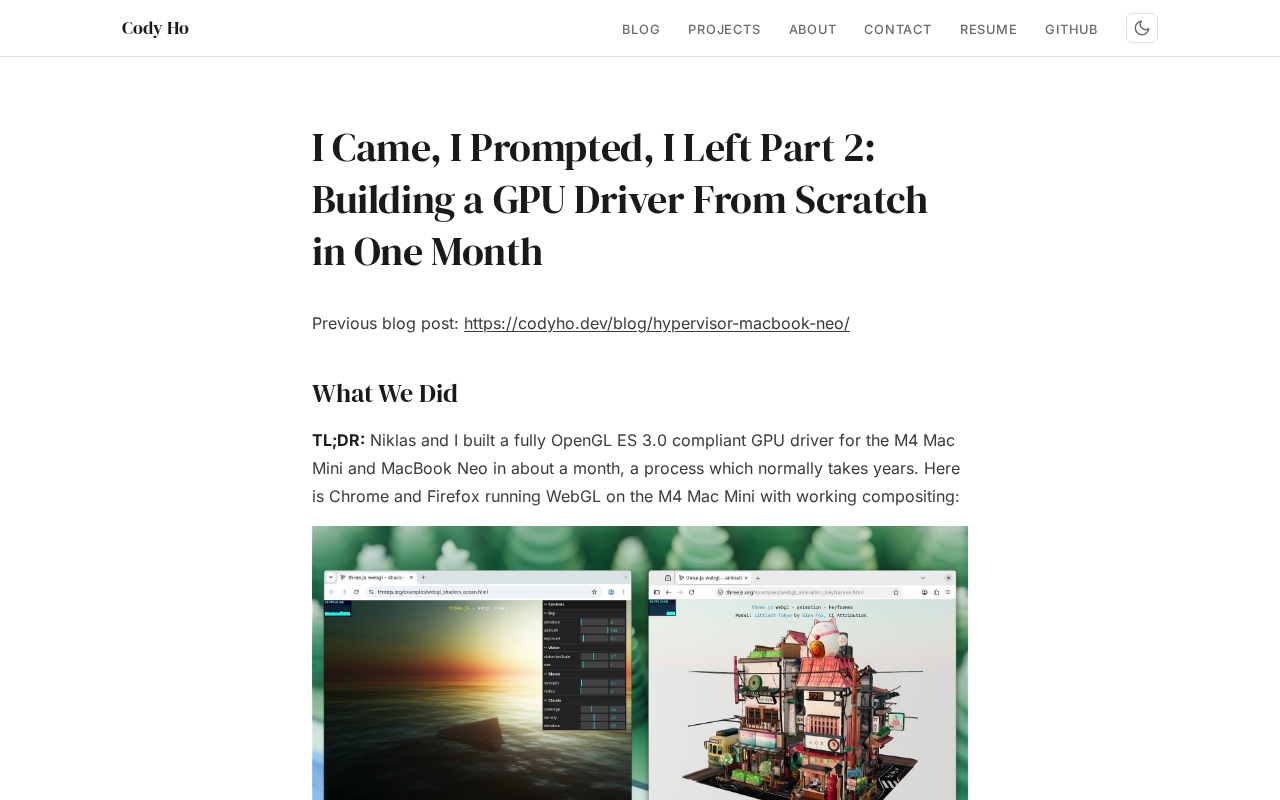
一个月为M4 Mac Mini开发Linux GPU驱动的技术挑战
开发者Cody Ho用一个月时间为M4 Mac Mini构建Linux GPU驱动,本文解析Apple Silicon GPU逆向工程的核心难点、开源社区协作价值及其对Linux硬件生态的意义。
SEO Page Builder Enhanced:让AI生成的SEO内容摆脱套路味
开发者基于octelens原版seo-page-builder打造的增强版开源工具,通过引入编辑审校、一手经验、事实与时效校验及写作风格护栏,专门解决AI生成SEO内容套路化、缺乏原创洞见的问题。
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。