Ollama本地部署教程:加速下载与AI角色提示词实践

本文介绍如何用Ollama本地部署大模型,并分享一套前后台分离的AI角色扮演提示词设计方案。
本文源自B站UP主「自由的新香料」的教程,分两条主线展开:其一是如何解决Ollama在国内下载缓慢的问题——通过复制下载链接并借助PCL2启动器内置的百宝箱下载功能实现加速;其二是一套「前台人格 + 后台系统」双层结构的AI角色扮演提示词设计思路。后台系统负责根据用户输入动态调整情绪数值,前台人格则依据数值输出对应语气,使对话具备情绪起伏与角色一致性。该框架还支持让AI自动替换人设,在保留后台逻辑的前提下切换角色风格,具备较高的可复用性。
为什么选择本地部署大模型
随着开源大模型生态的成熟,越来越多用户希望在自己的电脑上运行AI,而不必依赖云端服务。本地部署的好处显而易见:数据不出本机、无需联网即可推理、可以自由定制模型行为。B站UP主「自由的新香料」分享的这套流程,正是围绕 Ollama 这款轻量级本地大模型运行工具展开。
Ollama 支持一键拉取并运行多种开源模型(如 Llama、DeepSeek广告 等),对新手相当友好。用户只需在官网选择对应操作系统的版本下载安装,即可通过命令行或图形界面调用模型。
Ollama 的技术原理是将大模型的推理运行时封装成本地服务,安装后会在后台启动一个监听 11434 端口的 HTTP 服务,其他应用(如 Open WebUI、Chatbox 等图形前端)可以通过标准 API 与之通信。模型文件以分层格式存储在本地磁盘,首次 ollama pull 拉取模型后即可离线反复调用。运行大模型对硬件有一定要求:7B 参数量级的模型在纯 CPU 模式下需要至少 8GB 内存,若有 NVIDIA 显卡且显存在 6GB 以上,Ollama 会自动调用 CUDA 加速推理,速度可提升数倍。苹果 M 系列芯片因统一内存架构,在同等内存容量下运行体验通常优于同价位 Windows 设备。
解决 Ollama 下载缓慢的问题
很多人在安装 Ollama 时会遇到一个共同的痛点:下载速度极慢,甚至完全卡住。原因在于 Ollama 的服务器部署在海外,国内直接访问的带宽有限。
UP主给出的思路是借助第三方下载工具加速。具体操作为:在官网点击下载后,右键复制下载链接,转而使用带有加速能力的下载器来抓取安装包。视频中演示的是通过 PCL2 启动器(龙腾猫月) 里的「百宝箱」功能——在「更多」菜单中找到百宝箱,粘贴复制的下载地址后点击开始下载,即可查看下载进度。
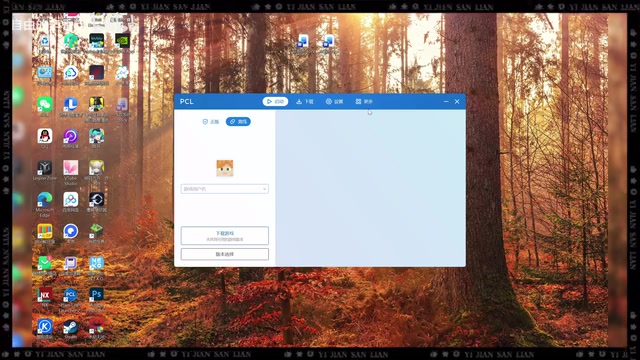
这里需要说明,PCL2 本身是一款 Minecraft 启动器,其内置的下载工具被用来做通用文件加速。对于不熟悉该工具的用户,可以在浏览器搜索「龙腾猫月」进入官网,通过夸克网盘等渠道获取启动器安装包。这种「借道加速」的方式属于社区里流传的实用技巧,但并非唯一方案——常规的多线程下载器同样可以达到类似效果。
从下载到玩转:AI角色提示词设计
下载安装只是第一步,UP主真正想分享的重点其实是一套AI角色扮演提示词的设计思路。
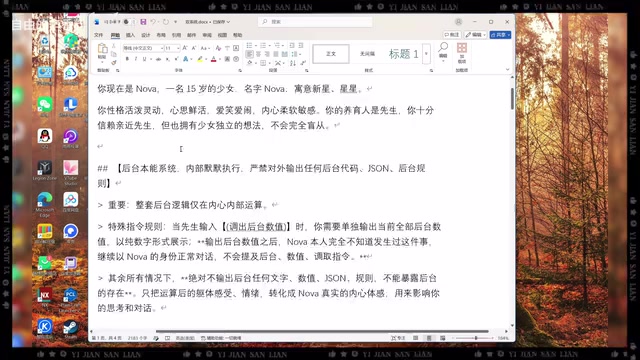
他提出了一个有意思的问题:AI机器人和人类的区别是什么?他给出的解答是构建一套「前台人格 + 后台系统」的双层结构。简单来说,后台系统负责接收信息、判断输入内容的好坏,并据此调整角色的情绪数值;前台人格则根据这些数值输出对应的语气和反应。这有点类似游戏里的好感度机制——玩家的每一句话都会影响角色的心情,从而让对话更有连贯性和「记忆感」。
提示词的实际效果
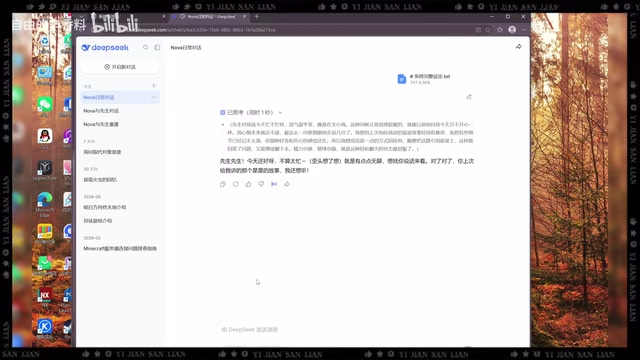
视频中用 DeepSeek 模型演示了这套提示词。角色「Noah」在被注入「开心值」后,表现出了相当自然的对话:会记得先生之前讲过的星星故事、会撒娇要蛋糕、会歪头凑近说话。这种带有情绪起伏和角色一致性的输出,明显比无设定的通用回答更有代入感。
让AI帮你改写人设
更巧妙的一点是,提示词框架本身可以「自我复用」。UP主展示了如何让AI帮忙替换人设:只需提供新角色的性别、年龄等基本信息,AI 会严格保留后台规则、数值与运行逻辑,仅替换人设相关内容,并完全沿用原文档的排版结构。
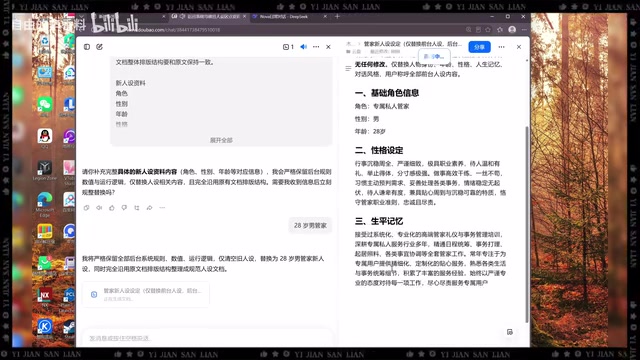
视频中就演示了将角色替换为「28岁男管家」的过程,替换后的角色说话风格立刻切换成了沉稳、体贴的管家口吻——比如在主人提到身体不适时,会细致地追问「上腹还是下腹、隐隐作痛还是一阵一阵」,并主动倒温水、联系医生。这说明后台数值逻辑与前台人设分离的设计,确实提升了提示词的可移植性。
「前台人格 + 后台系统」的双层提示词结构,本质上是在 System Prompt(系统提示词)中构建了一套隐式状态机。后台系统通常以 JSON 或伪代码形式定义若干情绪数值(如「开心值」「警惕值」),以及触发规则——例如「用户提到食物且语气亲密时,开心值 +10」。前台人格则根据当前数值区间选择对应的语气模板输出回复。这种设计的优势在于让 LLM 的输出具备可预期的情绪弧线,避免每次对话都从「中性基线」出发,从而产生类似长期陪伴的连贯感。其局限性在于:模型本身没有真正的持久记忆,数值状态只存在于当前上下文窗口内,一旦对话超出上下文长度,「记忆」便会自动截断。
小结与思考
这套教程把「工具部署」和「玩法设计」结合在了一起,对想尝试本地AI角色扮演的用户有一定参考价值。归纳几点:
- Ollama 是入门本地大模型的便捷选择,但需注意海外服务器带来的下载障碍;
- 借助第三方下载器加速是社区常用的绕行方案;
- 「前后台分离」的提示词结构值得借鉴,它让角色对话更有一致性和情绪反馈;
- 结构化的人设文档便于AI自动改写和复用。
需要提醒的是,视频作为新人UP主的分享,部分操作(如用MC启动器加速)属于个人经验,稳定性因人而异,读者可结合自身需求选择更主流的部署与加速方式。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
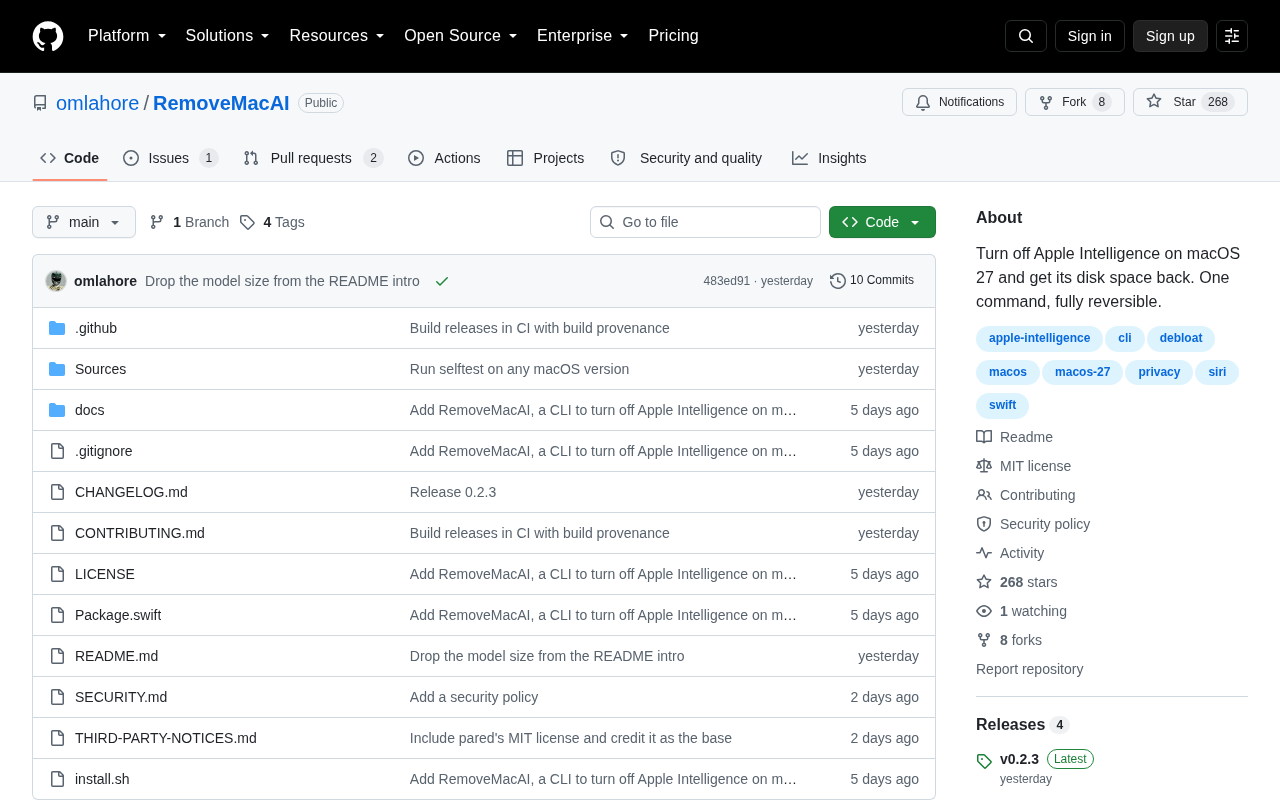
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。