Ollama本地决策模型来了:Nimble如何实现实时任务路由
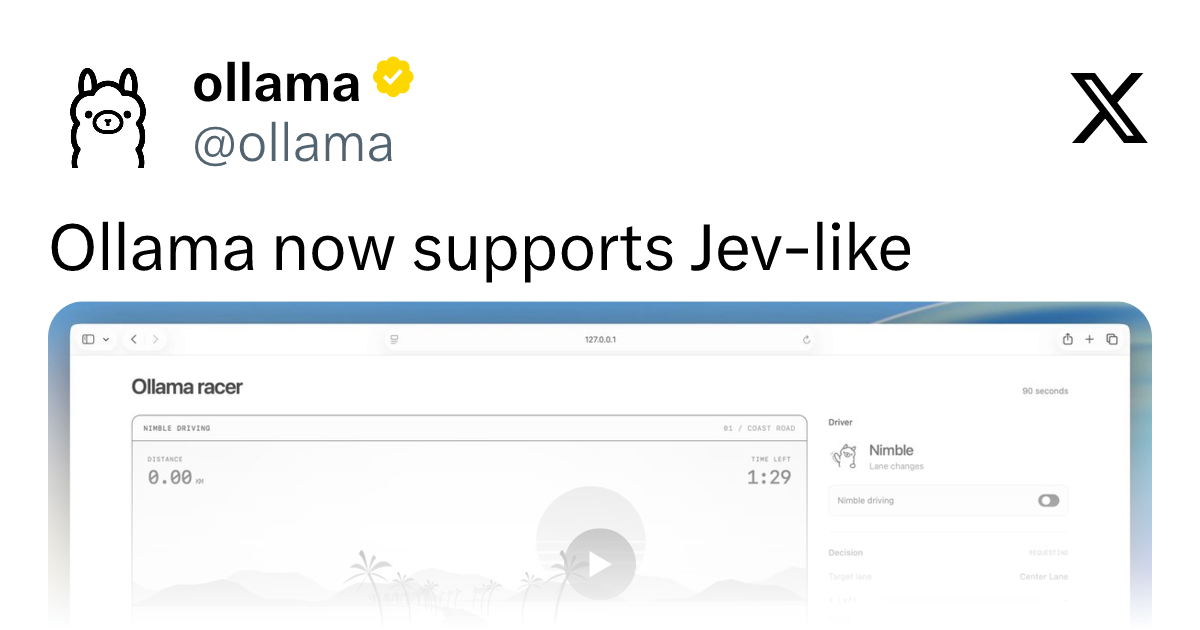
Ollama新增本地决策模型支持,Nimble配合/v1/systemone API实现毫秒级路由、分流与内容审核。
Ollama宣布支持本地运行的决策模型,主打快速判断而非长文本生成。代表性模型Nimble可一键拉取,适用于工单分流、模型路由和内容审核等对延迟敏感的场景。全新的/v1/systemone API取名呼应心理学「系统一」直觉思维,强调绕过长链推理直接输出结构化决策。官方以Nimble实时操控赛车游戏的demo验证其低延迟能力。这一更新体现了AI工程落地中模型分工专业化的趋势——用专门的小模型承担决策环节,既降低推理成本,又因全程本地运行而满足数据隐私与合规需求。目前具体参数规模与API完整规范尚待文档披露,生产环境接入前建议充分测试。
Ollama迎来本地决策模型支持
Ollama近期宣布支持类似Jev风格的决策模型(decision models),并且全部在本地运行。这意味着开发者无需依赖云端API,就能在自己的机器上部署专门用于「做决策」的轻量模型,为工单分流、模型路由、内容审核等场景提供低延迟、高隐私的解决方案。
与传统的大语言模型侧重生成长文本不同,决策模型的核心价值在于快速判断与分类。它接收输入后,输出的是一个结构化的「决策」——比如把工单归到哪个队列、把请求路由到哪个下游模型、或者判断某段内容是否违规。这类任务对响应速度要求极高,本地化部署恰好能把网络往返开销降到最低。
Nimble:面向决策任务的专用模型
在官方示例中,一个名为 Nimble 的决策模型被重点提及。用户只需一条命令即可拉取:
ollama pull nimble
从命名和定位来看,Nimble 强调的是「敏捷」——在毫秒级完成判断并返回结果。官方列举了三类典型应用场景:
- 工单分流(ticket triaging):自动判断用户提交的问题属于哪个类别,分配给对应团队或优先级,减轻人工客服初筛压力。
- 模型路由(model routing):在多模型架构中,根据请求的复杂度和类型,决定把任务交给哪个模型处理,从而兼顾成本与质量。
- 内容审核(content moderation):对文本内容做快速合规性判断,识别违规或敏感信息。
这些场景的共同点是:决策频繁、单次判断逻辑相对固定、且对延迟敏感。用一个专门优化的小模型在本地处理,比每次都调用通用大模型要高效得多。
新的 /v1/systemone API 与实时决策演示
此次更新还带来了一个新接口 /v1/systemone。从名称来看,它呼应了心理学中「系统一」(System 1)的概念——即人类直觉式、快速、自动化的思维模式,正好对应决策模型「不加长链推理、直接输出判断」的特性。
官方展示了一个颇具趣味性的演示:让 Nimble 通过 /v1/systemone API 实时玩「Ollama racer」赛车游戏,在游戏进程中持续做出操控决策。🏎️ 这个demo的意义不只是娱乐——它直观证明了决策模型在本地环境下具备足够低的延迟,能够支撑需要连续、实时判断的交互式任务。如果一个模型能实时应对赛车场景的瞬息变化,那么处理工单分流或内容审核这类非实时任务更是游刃有余。
「系统一」(System 1)这一概念来自心理学家丹尼尔·卡尼曼在《思考,快与慢》中提出的双过程理论。系统一代表快速、自动、几乎无需认知资源的直觉判断;系统二则代表缓慢、费力、需要深度推理的分析思维。与之对应,当前大语言模型的思维链(Chain-of-Thought)和慢思考推理(如 OpenAI o1 系列)可以类比为「系统二」——通过多步骤推理提升准确性,但代价是更高的延迟与算力消耗。将 /v1/systemone 命名对应系统一,意在传达这类 API 的设计哲学:跳过冗长推理链,直接输出判断结果。这种取舍在决策频繁、单次判断逻辑固定的场景下非常合理,但也意味着它不适合需要复杂推理的任务。
为什么本地决策模型值得关注
这一更新折射出AI工程落地的一个重要趋势:模型分工专业化。在实际生产系统里,并非所有任务都需要动用参数庞大的通用模型。把「路由」「分类」「审核」这类决策环节交给专门的小模型,既能降低推理成本,又能提升整体系统的响应速度。
本地部署进一步放大了这种优势。对于涉及敏感数据的企业(如客服工单、用户内容审核),数据不出本地既满足合规要求,又避免了云端调用的费用累积。Ollama一贯主打的「一条命令跑模型」体验,也把这类能力的使用门槛拉到了很低。
需要说明的是,当前信息主要来自官方的发布预告,关于Nimble的具体参数规模、准确率表现以及 /v1/systemone 的完整API规范,仍有待更详尽的文档披露。对于计划将其用于生产环境的团队,建议在正式接入前进行充分的场景测试。
模型路由(Model Routing)是多模型系统架构中的关键设计模式,其核心思路是用一个轻量的「路由器」模型作为前置判断层,根据请求的类型、复杂度或意图,将任务动态分发给最合适的下游模型。例如,简单的事实问答可路由至小型快速模型,复杂的代码生成或多步推理则转发给参数更大的模型。这种架构能在不牺牲复杂任务质量的前提下,显著降低整体推理成本——据部分工程实践报告,合理的路由策略可将 API 调用成本削减 30%–60%。Ollama 的本地决策模型恰好能承担这一路由层角色,且无需将请求先发送至云端做分类再返回,整个路由决策在本地毫秒内完成。
小结
Ollama对本地决策模型的支持,补齐了本地AI工具链中「快速判断」这一环。Nimble配合全新的 /v1/systemone API,把低延迟的决策能力带到了开发者的本地环境,赛车演示则生动地证明了其实时性潜力。对于构建多模型系统、需要智能路由或内容审核的开发者而言,这是一个值得尽早尝试的新选项。
相关推荐
人类能离太阳多近?帕克探测器穿越日冕的科学原理
人类能离太阳多近?NASA帕克太阳探测器曾飞至光球层上方380万英里,深入数百万度的日冕。本文解析为何探测器不会被汽化——温度与热量的区别、阳光强度及隔热罩设计的科学原理。
从空气中制造汽油:合成燃料为何尚未普及?
合成燃料能用空气中的二氧化碳、水和电力制造汽油、甲烷和火箭推进剂。本文解析萨巴蒂埃反应与费托合成的化学原理、热力学税、碳中和账本,以及合成燃料为何尚未普及、又将如何重塑能源地缘格局。
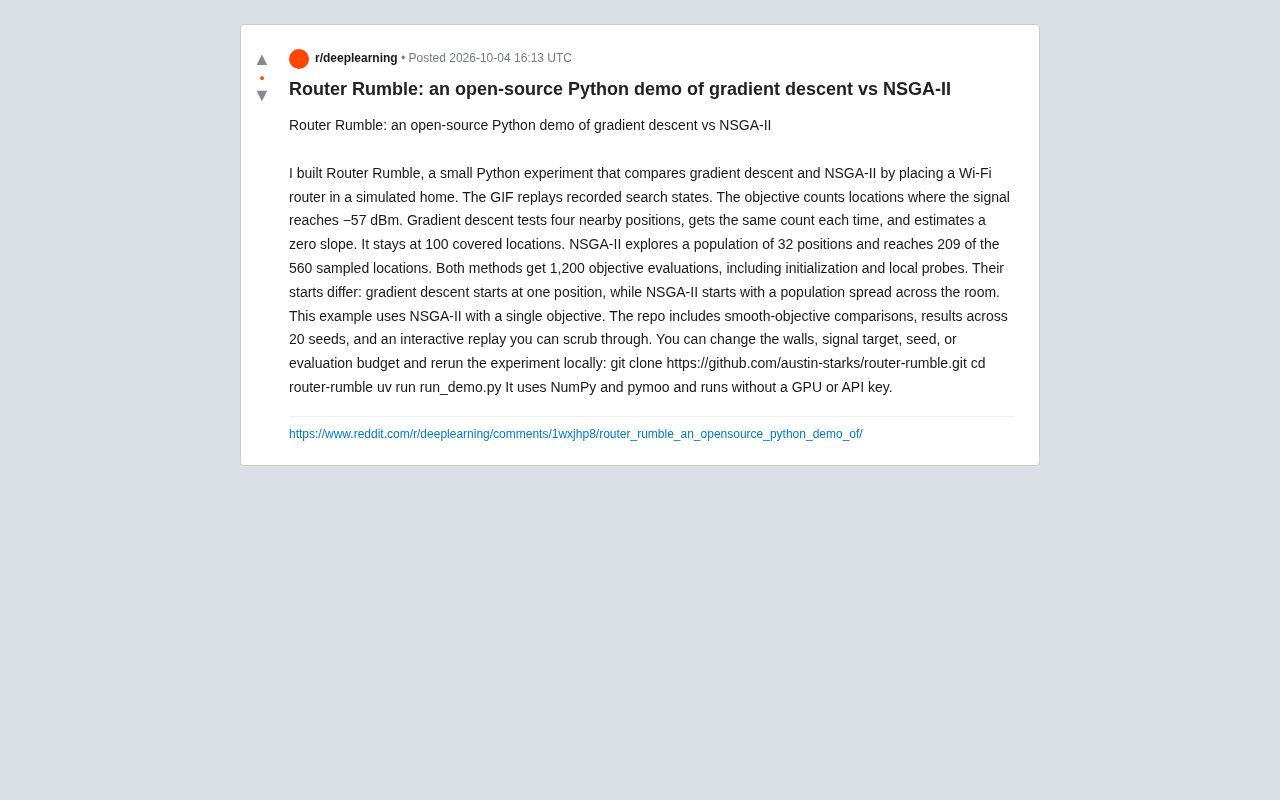
Router Rumble:用WiFi路由器演示梯度下降为何败给NSGA-II
Router Rumble 是一个开源 Python 项目,通过在模拟房间摆放 WiFi 路由器,直观对比梯度下降与 NSGA-II 进化算法在离散目标函数上的表现,揭示无梯度优化方法的优势。