Ollama发布v0.40.12-rc1,新增LFM3与d1模型支持
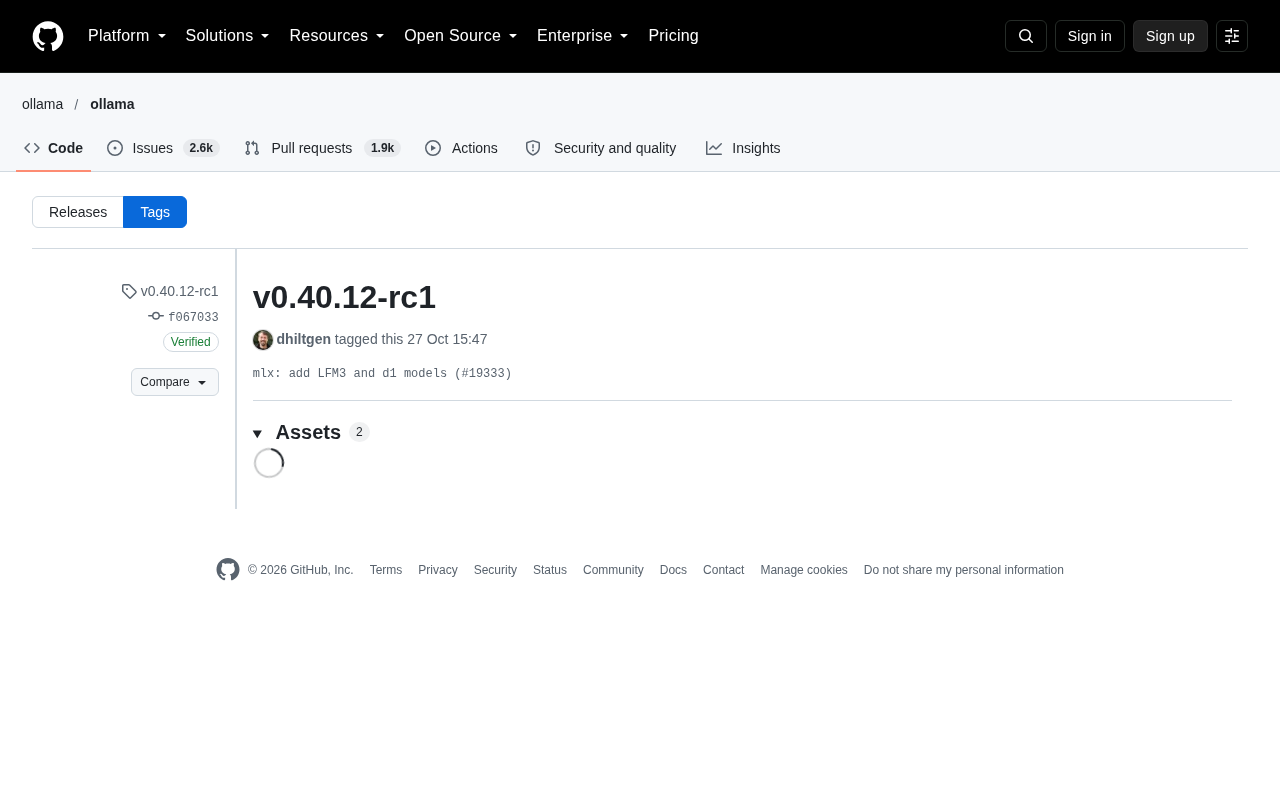
Ollama v0.40.12-rc1 为 MLX 后端新增 LFM3 与 d1 模型支持,强化 Apple Silicon 本地推理适配。
Ollama 发布 v0.40.12-rc1 候选版本,核心变更是通过 MLX 后端接入 LFM3 与 d1 两个新模型。MLX 是苹果为 Apple Silicon 设计的机器学习框架,强调统一内存架构下的高效推理,此次接入意味着这些模型在 Mac 设备上可获得更贴合硬件的运行路径。原始信息未披露两个模型的参数规模与性能数据,不宜做量化预判。发布由维护者签名验证,rc 流程有助于在正式版前收集后端加载与推理稳定性问题。对开发者而言,可提前在 Apple Silicon 环境验证新模型表现并上报反馈。
一次低调的候选版发布,却指向明确的方向
Ollama 发布了 v0.40.12-rc1 候选版本。从 GitHub 上的发布记录来看,这个版本号本身只是常规的迭代节奏,但提交信息里的一句话值得留意:mlx: add LFM3 and d1 models (#19333)。也就是说,这一版的核心变更是围绕 MLX 后端接入两个新模型——LFM3 与 d1。
候选版(rc1)通常意味着功能已基本冻结,进入测试与验证阶段。对于关心本地推理工具链的开发者而言,这条信息的价值不在于版本号的跳动,而在于 Ollama 对 MLX 这条技术路线的持续投入。
为什么 MLX 后端的模型扩充值得关注
MLX 是苹果为 Apple Silicon 芯片设计的机器学习框架,强调统一内存架构下的高效推理。Ollama 将新模型接入 MLX 后端,直接的含义是:这些模型能够在搭载 Apple Silicon 的设备上获得更贴合硬件的运行路径,而不是依赖通用的推理实现。
对 Mac 用户来说,这类改动往往是体感差异最明显的部分——模型能否顺利加载、内存占用是否可控、交互延迟是否可接受,都与后端适配程度相关。此次提交把 LFM3 和 d1 纳入 MLX 支持范围,说明 Ollama 正在把"可运行模型清单"和"硬件后端"做更细粒度的对齐,而不是简单地按模型名统一处理。
需要说明的是,当前原始发布信息中并未披露这两个模型的具体参数规模、架构细节或性能数据,因此不宜对它们的推理表现做量化预判。可以确定的是,它们进入了 Ollama 的 MLX 支持矩阵。
MLX 的统一内存架构是其区别于传统 GPU 推理栈的关键设计。在 Apple Silicon 上,CPU 与 GPU 共享同一块物理内存,MLX 利用这一特性避免了推理过程中显式的数据拷贝,从而降低延迟与内存峰值。不过,这也意味着模型加载器需要针对 MLX 的张量布局和量化方案做专门适配,通用后端(如基于 CPU 的 llama.cpp 路径)无法直接复用。Ollama 为 MLX 单独维护模型接入逻辑,正是为了让权重映射、KV 缓存分配等环节贴合统一内存模型,而非套用为独立显存设计的通用实现。
发布流程本身的信号
这次 tag 由 GitHub 账号 dhiltgen 于 27 Oct 15:47 打上,提交带有 GitHub 验证签名(GPG key ID: B5690EEEBB952194)。对开源项目而言,签名验证和候选版流程是供应链可信度的一部分:它表明发布动作来自项目维护者,且经过了可追溯的签名环节。
从工程视角看,rc 版本的存在也暗示变更集不算小。模型接入涉及加载逻辑、张量映射、可能的量化格式适配,这些都需要一轮实际使用来暴露问题。把 LFM3 和 d1 一起放进候选版,而非拆成多个小版本,可能意味着两者共享了部分接入工作。
候选版(release candidate)在语义化版本流程中通常表示功能已冻结、仅剩缺陷修复,但它的真实作用是把变更集交给愿意承担不稳定风险的早期用户。对于模型接入这类改动,单元测试难以覆盖真实硬件上的加载失败、精度偏差或内存溢出,必须依靠实际运行来暴露。rc 阶段收集到的问题若涉及后端适配,修复成本远低于正式版发布后的热修复——这正是把 LFM3 与 d1 一并放入 rc1 而非拆分小版本的工程动机之一。
对开发者的实际影响
如果你在本地用 Ollama 跑模型,这个 rc 版本的现实意义是:可以提前验证新模型在你机器上的表现,尤其是 Apple Silicon 环境下的加载与推理稳定性。候选版的定位就是收集反馈,遇到后端相关的问题,此时上报比等正式版更有价值。
对更广泛的生态而言,Ollama 持续扩充 MLX 模型支持,会强化"Mac 作为本地推理平台"的可用性。模型越多样,开发者做本地原型、隐私敏感场景验证、离线实验的空间就越大。这类看似琐碎的模型接入提交,累积起来才是本地 AI 工具链真正的竞争力。
至于 LFM3 与 d1 各自适合什么任务、能力边界在哪里,还需要等模型卡或后续文档补充。在信息有限的前提下,把它当作一次后端能力扩展来理解,比过度解读更稳妥。
相关推荐
Metapunk三大新技能:构建AI软件开发闭环
Metapunk新版本新增Implement Spec、PR和Retro三大技能,补齐AI软件开发闭环。本文解析各技能功能与工作流,帮助提升AI Agent开发效率与代码质量。
6个黑暗中的恐怖故事:TED-Ed用动画讲透人性寓言
TED-Ed 精选六则恐怖故事合集,涵盖《猴爪》、日本阿岩传说、死神教父、贝奥武夫、爱伦·坡《红死魔的面具》与无耳芳一。本文解析这些动画短片如何用跨文化寓言讲述欲望、背叛与死亡的代价,以及它们为何适合作为课堂讨论素材。
Python调用Ollama轻量模型实战指南
从安装Ollama、拉取0.8B轻量模型到用Python跑通调用的完整实操指南,含服务启动、模型名匹配、首次加载延迟等易踩坑细节,单次调用实测0.23秒。