Ollama决策模型实测:本地推理速度远超Claude

Ollama 支持本地决策模型,分类评分速度超云端 Claude 两倍,还能做图像分类。
文章介绍了 Ollama 新上线的决策模型支持,开发者可在消费级硬件上运行 0.8B 参数小模型完成分类、评分和视觉判断。实测中,TEF 模型邮件分类耗时 1.273 秒,Claude 为 2.568 秒;评分任务本地 1.09 秒、云端约 2.58 秒,预热后本地速度优势超过两倍。多模态方面,通过 base64 编码图片让本地模型判断缩略图的人脸、标题党和主题分类,结果基本合理但个别判定存疑。作者指出本地模型首次运行有启动成本,适合大批量重复调用,质量在复杂场景下可能仍逊于 Claude,但速度与成本优势明确。
Ollama 最近上线了 "决策模型"(decision models)支持,让开发者可以直接在消费级硬件上运行小参数模型,完成分类、评分、视觉判断等轻量推理任务。B站 UP 主在实测中发现,在固定输出结构的场景下,本地模型的响应速度不仅比云端 Claude 更快,甚至能在一台配备 GB10 的 Dell Pro Max 上完成多模态图像分类。
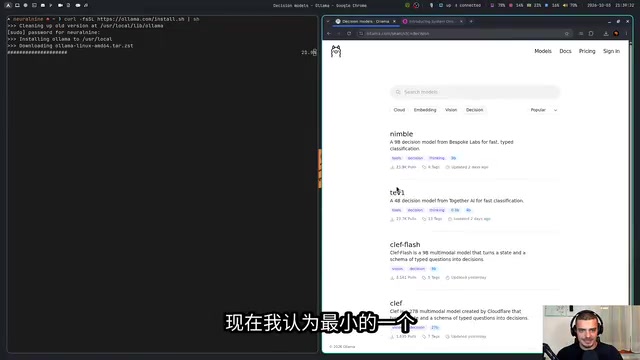
小模型跑在本地,速度优势明显
UP 主用 Ollama 拉取了 0.8B 参数的 TEF 模型(需明确指定 4-bit 量化选项),并在一台 Linux 机器上做了三组对比测试。第一组是邮件分类——将邮件划分为赞助垃圾邮件、支持粉丝邮件、服务工作机会三类。TEF 模型在预热后总耗时 1.273 秒,而同一任务用 Claude 通过官方 SDK 调用耗时 2.568 秒,"比两倍多"。
第二组是评分任务:判断某编程 YouTube 赞助咨询的"有希望"程度(弱/一般/强/优秀)。TEF 耗时 1.09 秒,Claude 依然是 2.58 秒左右。注:这些示例问题由 Claude 自己生成,UP 主只是把它拿来做分类。
另一款模型 Nimble 表现居中:预热后 1.7 秒,评分任务 1.336 秒。UP 主特别强调,Claude 不需要预热,而本地小模型首次运行有启动成本,"但如果你大规模地这样做,它会有影响"。
量化(Quantization) 是本地推理中的关键概念。它把模型权重从高精度浮点(如 FP16)压缩到低精度整数(如 4-bit、8-bit),从而大幅降低显存占用和计算量,让 0.8B 这类小模型能在消费级硬件上跑起来。代价是精度损失,可能影响输出的稳定性与准确率。文中提到的 4-bit 量化选项需要在 Ollama 拉取模型时显式指定,否则默认配置可能不同。对于决策模型这类只需输出结构化标签的任务,4-bit 量化通常足够,但在评分细粒度或边界样本上更容易出现偏差。
预热(Warm-up) 指模型首次加载到内存/显存并完成初始化的过程。本地小模型冷启动需要把权重从磁盘读入显存,耗时可达数秒;预热后权重常驻,后续调用接近即时。云端 API 则把这一成本转嫁给了服务方,因此对比时需区分冷启动与稳态耗时,否则会高估本地优势。
多模态能力:本地也能做图像分类
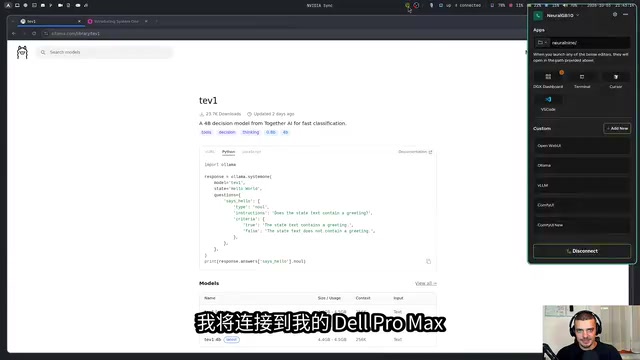
真正让人意外的是视觉任务。UP 主用一台搭载 GB10 的 Dell Pro Max 连接 Ollama 服务,通过 httpx 发送 base64 编码的图片,让模型判断 YouTube 缩略图的三个属性:是否有人脸、是否是标题党、主题属于编程/AI/游戏/Vlog 还是其他。
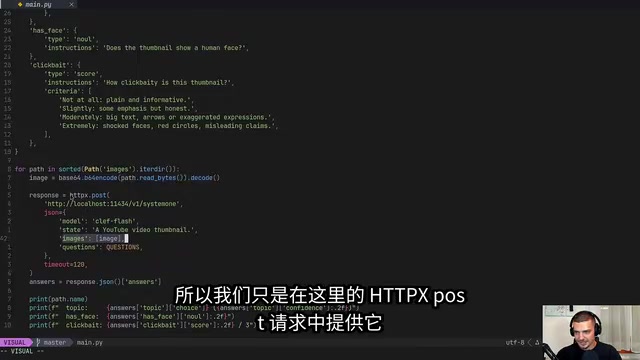
从结果来看,除了 UP 主本人出镜的那张缩略图(模型判定"有人脸"概率为 0)之外,其余所有缩略图都被高置信度识别出人脸。主题分类上,大多数编程/AI 内容被正确归入 AI 或编程类,个别如 GCP 和 Boycott 的判定被 UP 主认为"可以商榷"。标题党判断也基本合理,比如"抵制非 Linux 应用"和"Opus 火箭"那两张被标为最标题党。
UP 主坦言:"这比 Claude 更强大",但补充说硬件越快效果越好。
base64 编码传图 是把二进制图片转为 ASCII 字符串后随 HTTP 请求体发送的常见做法,优点是无需额外文件上传接口、便于与 JSON 请求体统一封装,缺点是体积膨胀约 33%,大图会显著增加传输与解析开销。实际部署中常配合图片缩放与压缩,以平衡识别精度和延迟。
多模态小模型的视觉能力 通常来自视觉编码器加语言解码器的组合:编码器把图片转为特征向量,再与文本提示拼接后交给模型判别。0.8B 级别模型在粗粒度属性(是否有人脸、是否标题党)上表现尚可,但在细粒度主题分类上容易出错。文中「本人出镜却判定无人脸概率为 0」的个例,说明小模型对特定人脸或训练分布外样本存在盲区,落地时应针对关键类别做验证集评估。
决策模型到底是什么
决策模型是 Claude 引入的一套系统性模型,专门用于解决不需要复杂推理的问题——观察某个东西并判断它是或不是,即二元分类(是/否),或者评分(有多好、有多像骗局、有多危险)。Ollama 现在把这类能力开放给了开源模型,且因为本地运行,欧洲用户不再需要忍受来自美国的 API 延迟。
决策模型与生成式大模型的区别 在于任务形态:生成式模型输出开放式文本,决策模型输出封闭集合中的标签或分数,例如「是否」「弱/一般/强/优秀」。这种约束让模型无需生成长篇推理链,只需在给定类别上做判别,推理深度低、延迟小。工程上通常通过固定输出结构(如 JSON schema 或枚举约束)来实现,使结果可直接被程序解析。
需要区分的是,决策模型并非独立架构,而是针对分类/评分任务调优或提示约束后的模型用法。它的可靠性高度依赖类别定义是否清晰、样本是否落在训练分布内。对于边界模糊的样本(如文中 GCP、Boycott 缩略图的主题归类),判别结果容易产生争议,因此在大批量落地时通常需要置信度阈值和人工抽检。
质量与速度的权衡
UP 主对模型质量的评价相当克制:"我没有特别强烈的意见,我没有深入使用过这些模型。也许在更复杂的场景下 Claude 更强大,这一点我不确定。" 这提醒我们,决策模型擅长的是结构化输出、低推理深度的任务,而非通用对话或复杂分析。
对于需要大批量分类、评分、图像过滤的工程场景,本地小模型的速度和成本优势已经足够有说服力。Ollama 以如此便捷的方式支持决策模型,确实值得开发者上手一试。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。