Ollama入门:本地部署开源大模型的核心工具解析
Ollama 是一款开源工具,让开发者能低门槛地将开源大模型部署到本地,免去 API 付费并保障数据隐私。
Ollama 是一款开源免费的大模型管理平台,核心价值在于大幅降低将开源大语言模型(如 DeepSeek、LLaVA 等)部署到本地的技术门槛。它封装了 GPU/CPU 环境配置的复杂性,支持 macOS、Windows、Linux 和 Docker 跨平台运行,并同时提供命令行(CLI)和 Web UI 两种管理方式。通过 Ollama 在本地运行模型,开发者可以彻底绕开在线 API 的 token 计费,同时借助其提供的 API 接口,用 Python、Java 等主流语言将模型集成进自己的应用。最典型的落地场景是构建私有知识库问答系统——模型和数据均在本地运行,既控制成本,又保障企业数据不外流。
为什么需要本地部署大模型
大多数人接触大语言模型,都是从在线服务开始的——ChatGPT、DeepSeek、文心一言、通义千问,登录到固定网址,与模型对话,模型基于已有知识给出回复。这种方式对纯聊天场景足够友好,通常也无需额外付费。
但问题出现在个性化开发环节。当你需要用 API 方式调用这些模型时,情况就变了。以 ChatGPT、DeepSeek 为例,API 调用需要申请独立的 Key,而这个 Key 会根据请求返回的 token 大小进行计费。DeepSeek 相对便宜(早期注册甚至赠送使用额度,现在已取消),但只要是付费服务,长期高频调用的成本就无法忽视。
于是一个自然的想法浮现:能不能把开源模型部署到本地,绕开申请 Key 和付费的环节?DeepSeek 已经开源(ChatGPT 并未开源),除此之外还有大量各类开源模型,包括图像领域较强的 LLaVA 等。要把这些开源模型跑在本机上,就需要一款专门的管理工具——这正是 Ollama 的价值所在。
Token 是大语言模型计费和处理文本的基本单位。模型并不直接处理字符或单词,而是将文本切分为更小的片段(token),中文通常每个汉字对应 1-2 个 token,英文则大致每 4 个字符对应 1 个 token。以 API 方式调用时,输入的提示词(prompt)和模型返回的回复都会被计入 token 用量。对于需要传入大量上下文(如长文档、知识库片段)的应用场景,单次请求的 token 消耗可能非常可观,这也是在线 API 长期运营成本居高不下的根本原因。
Ollama 到底是什么
简单理解,Ollama 是一个管理各类大模型的平台工具。它的核心作用是让开发者能够便捷地把开源模型部署到本地,并进行统一管理。
通过 Ollama,你可以下载、管理、删除模型,也可以基于现有模型做个性化创建。它提供两种交互方式:一种是命令行(CLI)方式,通过交互式命令操作;另一种是 Web UI 界面方式。两种方式各有适用场景,命令行适合快速操作和脚本化调用,Web UI 则更直观。
值得强调的是它的跨平台能力。Ollama 支持 macOS、Windows、Linux 以及 Docker 环境部署。个人尝试用 Windows 或 Mac 系统安装即可;如果是企业场景,则更适合基于 Linux 或 Docker 部署。安装好 Ollama 后,就可以直接下载和管理模型了。
降低部署门槛的资源调度机制
Ollama 真正解决的痛点,是大模型部署的复杂性。
在没有这类工具之前,自己部署各类开源模型是件麻烦事。你需要在本地搞定 GPU 相关环境——而这不仅取决于你的电脑是否支持 GPU,即便支持,还得配置一套复杂的环境才能正常使用。这道门槛把很多想尝试本地模型的开发者挡在了外面。
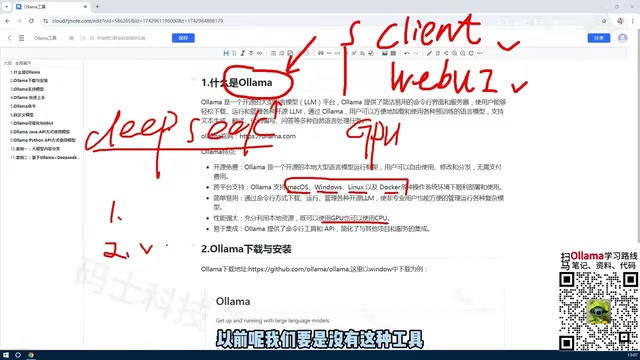
Ollama 把这些环节都简化了。它能充分利用机器上的资源,既可以使用 GPU,也可以使用 CPU。这意味着即便你的机器没有强悍的显卡,也能通过 CPU 运行模型。当然,模型越大,对机器配置的要求越高——比如部署最新的 DeepSeek 大模型可能需要几百 GB 的存储,把模型从线上下载到本地后运行,机器资源占用会随模型规模显著增加。
GPU(图形处理器)之所以在大模型推理中被优先使用,是因为模型运行本质上是大量矩阵乘法运算,而 GPU 拥有数千个并行计算核心,处理这类任务的效率远高于 CPU。传统的手动部署方案通常需要安装 CUDA(NVIDIA 的 GPU 并行计算框架)、配置驱动版本、处理各类 Python 依赖冲突,任何一个环节出错都可能导致模型无法启动。Ollama 在底层封装了这些复杂的环境配置,并能自动检测机器上的可用硬件资源,在 GPU 不可用时自动回退到 CPU 模式,使开发者可以跳过繁琐的环境搭建直接使用模型。
Ollama 的核心特点
梳理下来,Ollama 有几个关键特点:
开源免费
工具本身完全免费开源。搭配开源模型本地运行,调用过程不产生任何费用——这对需要高频 API 调用的个性化开发场景意义重大。
跨平台与易用性
如前所述,它支持主流操作系统和容器环境。同时提供 CLI 和 Web UI 两种管理方式,上手成本低。
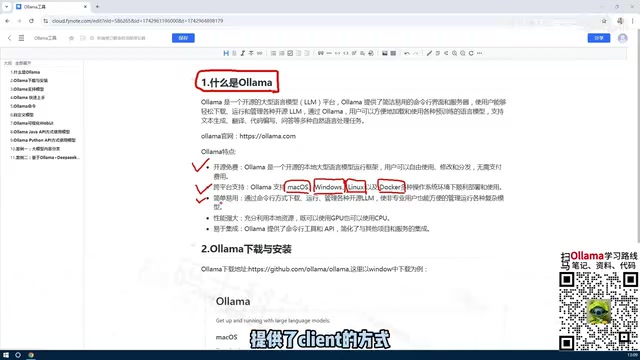
性能与扩展性
性能层面,Ollama 能灵活调度 GPU 和 CPU 资源。扩展性层面,它提供 API 接口,支持用 Python、Java 等多种语言访问模型,方便集成到各类应用中。
典型应用场景:私有知识库问答
Ollama 最被看重的一点,是把开源模型部署到本机后,可以通过 API 方式与模型交互。
一个非常常见的落地场景是私有领域问答机器人:基于现有开源模型,灌入公司或企业内部的私有知识库,构建面向特定领域的智能问答系统。由于模型运行在本地,数据不必上传到第三方服务,既控制了成本,也保障了数据隐私。对企业而言,这是 Ollama 相比在线 API 服务的核心优势。
这类私有知识库问答系统通常基于 RAG(检索增强生成,Retrieval-Augmented Generation)架构实现。其核心思路是:将企业内部文档、手册、FAQ 等资料切分并向量化存储到本地数据库中;当用户提问时,先从知识库中检索出最相关的片段,再将这些片段连同问题一起作为上下文传给本地运行的大模型,由模型生成最终回答。由于整个流程——模型推理和知识库数据——都在本地闭环运行,敏感的企业数据不会流出内网,这对金融、医疗、法律等对数据合规性要求严格的行业尤为重要。
小结
Ollama 本质上是一款大模型管理工具,它让开发者能够便捷地将开源模型部署到本机,使用时不再付费。它的三大亮点值得记住:开源免费;提供 API 与 CLI 两种方式管理和使用模型;扩展性强,支持灵活调度 CPU 或 GPU 资源。理解了 Ollama 的定位和价值,后续的安装、下载、命令操作等实战环节就有了清晰的目标。
相关推荐
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。
全盲创业者靠Claude做出无障碍产品,卖出1700美元
一位全盲创业者用 Claude 为盲人客户打造无障碍产品并卖出 1700 美元。他的经历揭示了 Vibe Coding 的真相:AI 能写代码,但真正的好体验离不开领域知识,也展现了 AI 赋能残障人群自主构建工具的独特价值。
Datamimic:给AI编程助手一个可控的测试数据世界
Datamimic 是一款开源工具,主张不要让AI编程助手自行编造测试数据。本文解析AI生成测试数据的可靠性隐患,以及可控测试数据世界对开发质量的价值。