Ollama深度拆解:14人团队如何靠分发做成AI界Docker
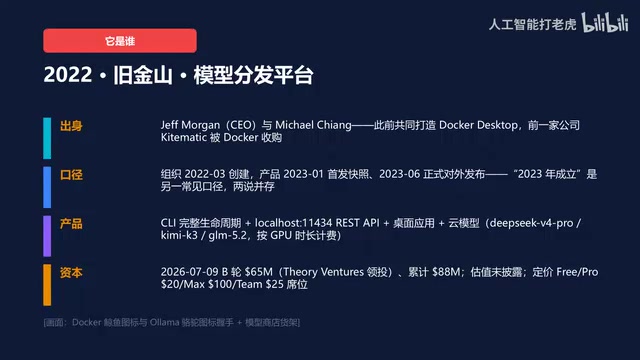
Ollama靠一条命令填平本地运维鸿沟,护城河在生态存量而非技术原创。
Ollama由两位Docker Desktop前创始人打造,将容器化思维移植到模型分发,用一条`ollama run`命令封装了量化选型、驱动配置、显存切层等全部运维脏活。其架构核心是"主进程管调度、推理交给子进程",推理引擎完全依附llama.cpp和MLX,不含任何自研推理代码。真正的护城河不在技术专利,而在890万月活开发者、4万多个社区集成构成的分发入口网络效应。主要短板包括:KV量化只有三档全局选项、落后学术前沿两代;MTP提速数据仅在Apple Silicon上验证;以及14人团队同时维护四条战线的工程带宽风险。分发入口短期难以撼动,但精度层面的开源组合可能在3到6个月内完成超越。
一条 ollama run 命令,找模型、拉模型、跑模型一步到位。量化档位、驱动配置、显存切层这些运维脏活,它全部包办。就是这么一个项目,靠 14 个人的团队服务着 890 万月度开发者和 85% 的财富 500 强企业。
听起来像神话,但把它拆开看,你会发现 Ollama 真正的价值不在推理引擎——它一行推理代码都没有原创——而在于它把「能下载」和「跑得起来」之间那道运维鸿沟填平了。这篇文章基于 B 站 UP 主的深度拆解,逐层还原 Ollama 的技术底牌、护城河与真实短板。
一条命令背后的运维地狱
开源权重模型满天飞,为什么大多数人还是在本地跑不起来?答案藏在「能下载」和「跑得起来」之间的整个运维地狱里。
GGUF 该选哪个量化档位?驱动和 CUDA 版本怎么配?显存不够的时候怎么切层?这些碎片化的脏活,把绝大多数非推理专家挡在了本地推理的门外。
Ollama 的创始人 Jeff Morgan 和 Michael Chang 曾共同打造 Docker Desktop,前一家创业公司 Kitematic 被 Docker 收购,容器化的心智模型就是这么一路带过来的。他们把 Docker 式的容器化思维整体迁移到模型分发上——一条命令,把找模型、拉模型、跑模型全部葬进去。
左边是自己动手的世界:量化档自己查、驱动自己踩坑、显存切层自己调。右边是 Ollama 的答案:一条命令搞定,量化版本和尺寸档位全部由托管方备好。对集成方来说,本地 11434 端口的 REST API 加上 OpenAI 和 Anthropic 双兼容层,让现有工具零改造接入。
四个数字与两种口径
先看几个反差极大的数字,也顺带把口径的水分挤一挤。
- GitHub 星数:17.9 万颗,AI 生态顶流。但 TechCrunch 的口径是 17.6 万,两个数字并存,看的时候先打个折。
- 用户规模:890 万月度开发者,4 万多个社区集成,85% 的财富 500 强覆盖。
- 团队与融资:全团队仅 14 人,累计融资 8800 万美元,B 轮 6500 万由 Sierra Ventures 领投。
- 提速数据:MTP 推测解码在编码基准上把每秒 Token 数从 50.2 提到 95,接近翻倍——但这是 Apple Silicon 上的官方口径,NVIDIA 场景没有同级公开数据。
星数、用户、团队、提速四条线全拉满,但每一条都需要标注前提。14 个人服务近千万开发者,这是杠杆奇迹,也是最大的隐患。
技术底牌:主进程调度,推理外包
Ollama 的架构核心是「主进程管调度,推理交给子进程」。
请求进来,先进调度器排队,默认并行数由参数控制,多模态强制为一。每一层放 GPU 还是 CPU,靠显存预测决定——取「预测空闲」和「GPU 报告空闲」的较小值。源码注释里写明了原因:CUDA 的显存上报有延迟。显存不够就走补货逻辑,必要时驱逐旧模型重新加载。
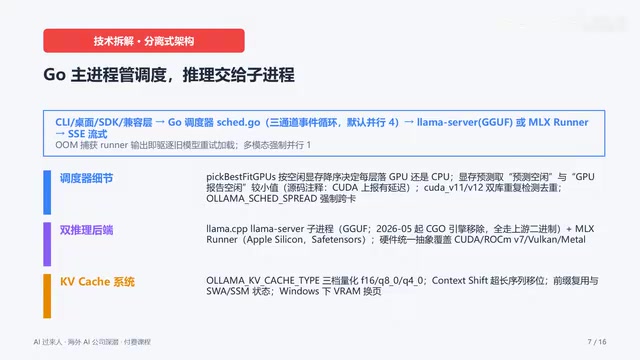
推理走双后端:GGUF 交给 llama.cpp 的 llama-server 进程,Apple Silicon 另有 MLX Runner。你可能没注意到,从 2026 年 5 月起,Ollama 连自己的 CGO 引擎都移除了,GGUF 全部走上游二进制。KV Cache 支持三档量化:F16、Q8_0、Q4_0,硬件抽象层覆盖 CUDA、ROCm、Vulkan、Metal 四条线。
分发机制是纯 Docker 式的:内容寻址 Block 加 Manifest 描述模型层组成,Modelfile 模板定义基础模型、参数、模板和适配器。有两处质量兜底细节特别见功力——标准量化工具会丢弃的多模态和位置嵌入张量,Ollama 从原始高精度文件里拷回来;DeepSeek广告 的 MLA 张量就算整体压到 Q4,也强制保留高精度。
GGUF 与 llama.cpp 的关系值得单独说明。GGUF(GPT-Generated Unified Format)是 llama.cpp 项目定义的模型文件格式,设计目标是把模型权重、量化参数和元数据打包进单一文件,方便跨平台加载。量化是指把模型权重从 32 位或 16 位浮点数压缩到更低精度(如 8 位整数、4 位整数),以降低显存占用和加快计算速度,代价是轻微的精度损失。llama.cpp 是一个纯 C/C++ 实现的推理引擎,最初专为在消费级 CPU 上跑 LLaMA 系列模型而生,后来扩展支持 GPU 加速和大量模型架构。Ollama 本身不包含任何自研推理代码,它的角色是把 llama.cpp 的 llama-server 二进制作为子进程启动,自己只负责调度、显存预测和 API 层的封装。这也是文章所说「体验上限由上游决定」的直接原因——Ollama 的推理性能天花板就是 llama.cpp 当前版本的天花板。
护城河四张牌:只有生态无法复制
把 Ollama 的护城河拆成四张牌,前三张都只是中等,唯有最后一张几乎无法复制。
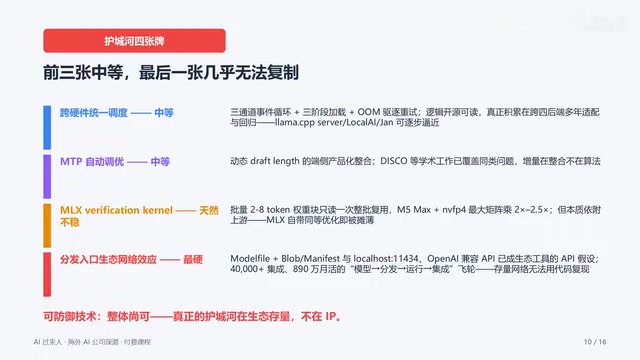
第一张,跨硬件统一调度:三通道事件循环加三阶段驱逐,逻辑开源可读。真正攒下来的是跨四个硬件后端多年的适配和回归测试,但 llama.cpp server、LocalAI 都能逐步逼近。
第二张,MTP 自动调优:增量在端侧产品化整合,Disco 等学术工作已经覆盖同类问题。
第三张,MLX 验证内核:批量场景权重快,最大矩阵能提速 2 到 2.5 倍,但本质依附上游,MLX 自带同等优化就会被摊薄。
第四张,分发入口的生态网络效应:这是最硬的一张。本地 API 端口和 OpenAI 兼容层已经成了生态工具的 API 假设,4 万多个集成、890 万月活构成的存量网络,无法用代码复现。
结论很清晰:可防御的技术整体尚可,但真正的护城河在生态存量,不在知识产权。
MTP(Multi-Token Prediction,多 Token 预测) 是一种推测解码的变体技术。传统自回归语言模型每次只预测下一个 Token,MTP 则让模型在一次前向传播中同时预测多个未来 Token,再用主模型做验证,接受正确的部分、丢弃错误的部分。由于验证比生成便宜得多,整体吞吐量可以大幅提升。文章提到 Ollama 的 MTP 推测解码在 Apple Silicon 编码基准上把每秒 Token 数从 50.2 提到 95,接近翻倍。但这里有两个前提需要注意:第一,MTP 的加速效果高度依赖输出内容的「可预测性」,代码补全类任务(重复模式多)往往比开放式对话获益更大;第二,Ollama 实现的 MTP 是「自动调优」形式,即无需用户手动配置草稿模型,但核心算法思路在学术界早有覆盖,差异化主要体现在端侧产品化整合的便利性,而非算法本身的独创性。
四个真实短板:别只看发布会
泼一盆冷水,Ollama 有四个不容忽视的短板。
推理层深度依附上游:引擎全是 llama.cpp 和 MLX 的,2026 年 5 月起连 CGO 引擎都移除了。体验上限直接由上游决定,同生态竞争者用同一上游,差异化被削弱。
没有精度研究:KV Cache 全局只有三档,不暴露逐层混合精度。KIVI 的 2 比特、KVQuant 的千万级上下文都跑在前面,量化和推测解码的前沿都不在它手里,Q4_0 已经落后学术前沿两代。
性能证据偏科:MTP 近九成提速只在 Apple Silicon(M 系列加 Gemma)上测过,NVIDIA 和 CUDA 场景没有同级公开数据。
安全敞口:苏黎世的「Mind the Gap」论文证明,GGUF 量化映射的空洞可以注入隐藏恶意行为。分发面越大,攻击面越大。
KIVI 与 KVQuant 是文章提到的两个学术量化方案,理解它们有助于判断 Ollama 的精度差距到底有多大。KV Cache 是 Transformer 推理时缓存注意力计算中间结果的机制,随上下文长度线性增长,是长文本推理的显存瓶颈所在。KIVI(2023)提出对 KV Cache 做逐通道的 2 比特量化,同时保留少量「异常值」通道用全精度存储,实测在多个模型上几乎不损失准确率。KVQuant(2024)进一步把支持的上下文窗口推到千万 Token 量级,并引入逐层非均匀量化策略。相比之下,Ollama 的 KV Cache 量化只提供 F16、Q8_0、Q4_0 三档全局选项,无法针对不同层、不同通道做差异化处理。这意味着在长上下文场景下,Ollama 要么用更多显存维持精度,要么用粗粒度量化换空间但损失更多质量,两头都输给了学术前沿的细粒度方案。
关键取舍与最终判断
Ollama 把全部复杂度藏进一条命令,同时也藏掉了量化深度。它换来的是零配置体验和最大分发面——890 万月活、85% 财富 500 强、本地 API 加双兼容层让生态工具零改造接入,「数据永不被训练」的隐私承诺贯穿本地与云。
代价是:量化只有 GGUF 固定档位加 KV 全局三档,推理内核完全不自研,全面依附上游,多模态模型暂时不支持并行。
最锋利的矛盾在于,分发网络本身就是产品,但它夹在上游和集成方之间——上游可以自带优化,集成方可以直接内嵌 llama.cpp,两头都可能绕开它。
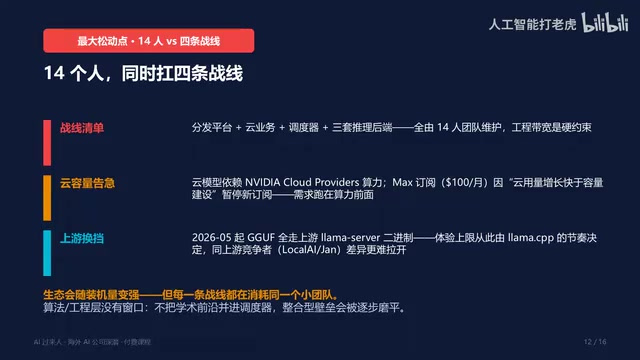
更大的松动点是那 14 个人:分发平台、云业务、调度器、三套推理后端,四条战线全由这个小团队维护。云业务这边,Max 订阅甚至因为需求跑在算力前面而一度暂停新订阅。
窗口是分层的:分发入口 12 个月以上难以撼动,但 KV 量化精度落后,开源组合 3 到 6 个月就可能超越。留一个思考题——如果 llama.cpp 官方明天就发布自己的模型库和一键 CLI,你会迁移吗?当模型供给爆发之后,谁掌握分发,谁就掌握开源 AI 的入口。
相关推荐
人类能离太阳多近?帕克探测器穿越日冕的科学原理
人类能离太阳多近?NASA帕克太阳探测器曾飞至光球层上方380万英里,深入数百万度的日冕。本文解析为何探测器不会被汽化——温度与热量的区别、阳光强度及隔热罩设计的科学原理。
从空气中制造汽油:合成燃料为何尚未普及?
合成燃料能用空气中的二氧化碳、水和电力制造汽油、甲烷和火箭推进剂。本文解析萨巴蒂埃反应与费托合成的化学原理、热力学税、碳中和账本,以及合成燃料为何尚未普及、又将如何重塑能源地缘格局。
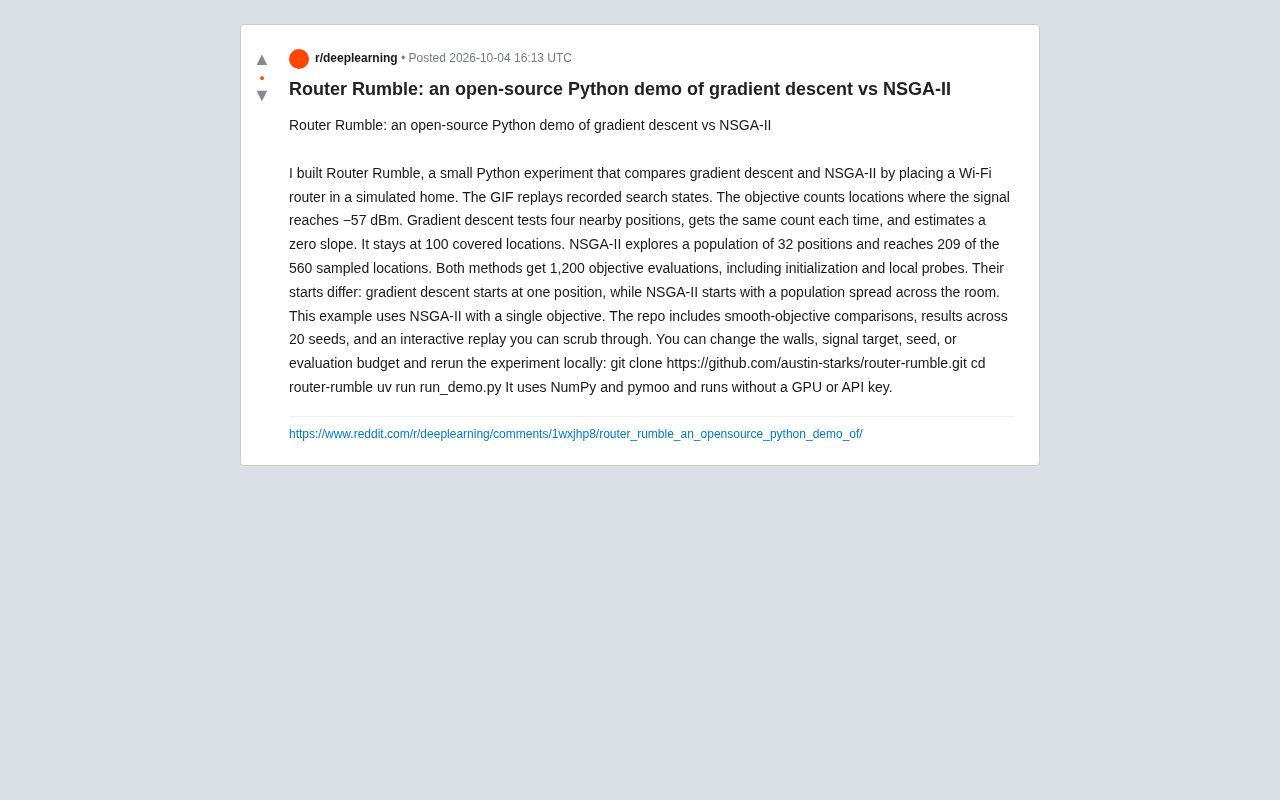
Router Rumble:用WiFi路由器演示梯度下降为何败给NSGA-II
Router Rumble 是一个开源 Python 项目,通过在模拟房间摆放 WiFi 路由器,直观对比梯度下降与 NSGA-II 进化算法在离散目标函数上的表现,揭示无梯度优化方法的优势。