Omni CTO实战:Claude Code如何重塑数据分析Agent

Omni用18个月将Claude打造成数据分析Agent,提炼出一套可落地的Agent工程演进路径。
在Code with Claude大会上,AI数据分析平台Omni的CTO复盘了公司如何用Claude从零构建数据分析Agent「Blobby」的18个月历程。核心经验围绕五个层次展开:通过语义层将业务上下文本地化编码、构建agentic loop并打磨错误恢复机制、通过trace分析解决agent「大脑分裂」等结构性问题、押注Claude最擅长的SQL生成能力(尤其是CTE风格),以及用eval系统保障可预测性。值得一提的是,团队作为Claude Code的重度用户,反过来深刻理解了一个好的agent harness应有的设计样貌,形成了工程经验的正向闭环。最直观的结果体现在那条陡然上扬的代码提交曲线上。
在Code with Claude大会上,AI数据分析平台Omni的CTO分享了一段颇具代入感的经历:作为一家拥有数百客户、25人工程团队的成长期公司的技术负责人,他本以为自己迟早要彻底告别写代码。但Claude Code的出现改变了这一切——「这是落地过程中一个非常棒的意外收获,让我到现在还能时不时写点代码。」
这场分享不只是对工具的赞美,更完整复盘了Omni如何用Claude从零打造数据分析Agent「Blobby」,以及18个月里踩过的坑和学到的工程经验。
从试水到爆发:代码提交曲线的拐点
Omni的CTO展示了一张主分支代码提交量随时间变化的图,曲线斜率在某个时点陡然上扬。这个拐点并非偶然。
2025年初,他对团队说了一句朴素但关键的话:「我不知道什么时候、也不知道会怎样,但我知道我们的工作正在改变,那就开始试吧。」团队做了不少尝试,有起有落,直到Claude Code配合更强的模型发布,资深工程师才开始确信——「这次是真的,是真能稳定帮上忙。」
从那之后便一发不可收拾。工程师在一月假期归来后几乎都已上手,提交曲线的斜率直接反映了这种生产力跃升。这种速度与Omni的核心价值观高度契合:一个叫「SHIP IT」,一个叫「透明」。他们每周五全员会议会花超过50分钟做demo演示,并由CEO剪辑后发布到YouTube公开分享。
Blobby是什么:语义层如何让AI读懂你的业务
Omni的核心产品能力,是让用户「和数据对话」。用户提出一个问题,Claude将其翻译成一个语义查询(Semantic Query),再转换为SQL,在数据仓库中运行后返回结果。
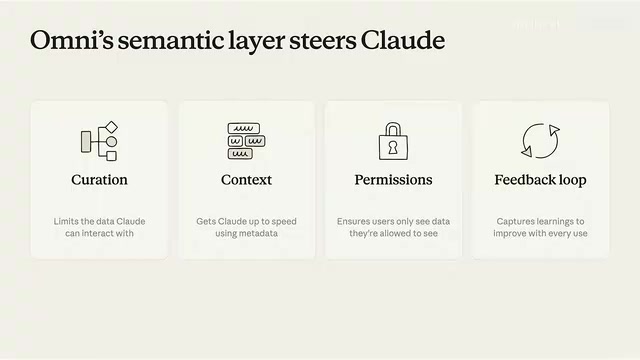
这里的关键在于语义层(Semantic Layer)——一个坐落在数据仓库之上的「翻译层」。CTO强调了一个容易被忽视的难点:Claude回答通用业务问题的能力很强,但要回答「你自己业务」的问题,就必须把业务定义编码进去。
他举了一个精妙的例子:即便是「last quarter(上个季度)」这样简单的词,在不同部门含义都不同。Omni内部,产品和工程部门按自然年季度计算,销售团队则按财年季度计算。这些微妙差异都必须被编码进实体上下文、认知层乃至数据定义中,才能得到正确答案。
语义层主要做三件事:整理成千上万的数据集(真实企业可能有上百张收入表、上百张商机表)、本地化地提供上下文、以及权限管理。CTO特别点出一条经验,这也与Claude Code的使用哲学呼应:「context很好,但如果context能本地化、放在它所指代的定义旁边,效果会更好。」这正如大家在用Claude Code时依赖的配置文件——上下文越贴近它适用的代码,结果越好。
语义层(Semantic Layer) 是现代数据栈中的一个抽象层,介于原始数据仓库(如Snowflake、BigQuery)和最终用户之间。它的核心职责是将物理数据表的列名、关联关系、计算逻辑和业务规则翻译成人类可理解的业务概念。例如,数据库中的arr_delta字段在语义层中可以被定义为「年度经常性收入增量」,附带计算公式、所属部门、适用的时间粒度等元数据。对于AI系统而言,语义层的价值尤为关键:大模型本身缺乏对特定企业业务逻辑的先验知识,语义层相当于给模型提供了一份「领域词典」,让它在生成查询前就能理解「活跃用户」「净收入」这类术语在该公司具体指什么。业界常见的语义层工具包括dbt Semantic Layer、LookML(Looker)、Cube.js等,Omni自身也是这一赛道的参与者。
三次关键进化:从一问一答到真正的Agent
Blobby并非一开始就如此成熟。CTO梳理了它18个月的成长路径。
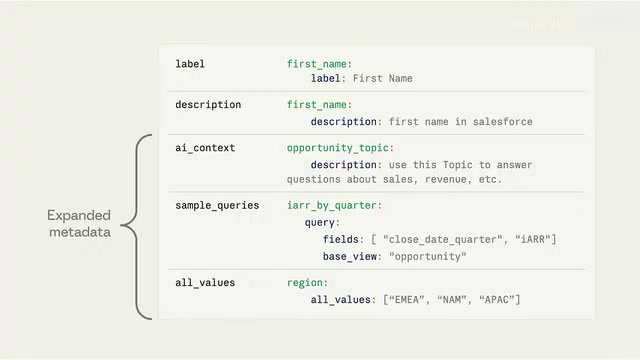
第一阶段:补齐元数据。 最初版本是单问单答。团队很快意识到需要更多metadata,于是引入了三类关键信息:专为大模型设计的AI context(告诉它如何使用某个字段)、sample queries(典型用例的示例查询),以及values(字段的值样例,比如region字段的缩写含义,让模型能推断「US代表美国」)。
第二阶段:加上Agentic Loop。 这是一次重大工程投入,团队自建了agentic harness。CTO分享了最重要的一条心得:agentic loop非常擅长从错误中恢复。因此他们做了两件事——告诉Blobby如何从错误中恢复并给它预算去尝试,以及投入精力打磨优秀的错误信息(清晰描述发生了什么、可能如何修复)。仅这一点就让更难的eval表现大幅提升。随着对话复杂度上升,模型也从Hiku切换到了Sonnet,token消耗随之上涨,但这是设计使然。
Agentic Loop(智能体循环) 是指让大模型能够在单次交互中自主规划、调用工具、观察结果并迭代修正的执行框架,区别于一次性输入-输出的单轮对话模式。其基本结构是:模型接收任务 → 决定调用哪个工具 → 执行工具获得观察结果 → 将结果反馈给模型 → 模型决定是否继续或返回最终答案,如此循环。Agentic Harness 则是围绕这一循环搭建的工程脚手架,负责管理工具注册、上下文窗口、错误捕获、重试逻辑、token预算控制等基础设施。Omni选择自建harness而非使用现成框架,使他们能精细控制每一层的行为——包括文中提到的针对Blobby业务场景优化错误信息格式,这在使用高度封装的框架时往往难以实现。
Blobotomies:从trace里动的「大脑手术」
当CEO——团队口中「最吵最挑剔的用户」——坚持要求把不稳定的回答修好时,团队投入大量精力去读取和分析trace(执行轨迹)。他们把由此引发的一系列重大重构戏称为「blobotomies」。
一个典型案例是**「大脑分裂」问题**。Blobby最初设计了一个外层agent负责生成任务列表、一个subagent专门生成query。设计看似合理,但trace显示:外层agent并不知道哪些问题能用单条query回答,于是把一个需要多条query的复合问题丢给subagent,导致混乱。
解决方案被工程师称为「整合大脑」——把工具直接提升到外层agent harness里,避免子系统与外层系统之间出现认知割裂。这一改动显著改善了复杂eval的表现。CTO的核心启示是:要非常小心地处理不同层级agent之间的信息与知识分配。
押注SQL:让Claude发挥最擅长的能力
另一次重大转变源于一个观察:直接用Claude生成SQL,往往能回答Blobby当时搞不定的难题。
Omni早年其实内置过一个完整的SQL解析引擎,但因为无法稳定处理各种奇怪的SQL输入而被束之高阁多年。团队做了一个判断:如果Claude能生成表达力强的SQL,而解析器只需处理大致符合通用形式的查询,机会就来了。他们还押注Anthropic会持续让Claude在SQL上表现出色。
工程师Steven翻出旧解析代码,把查询生成接口从严格的私有JSON格式切换为SQL解析模式。效果立竿见影:原本需要三四次尝试或别扭串联才能回答的问题,现在一次查询就能搞定。CTO还注意到一个有趣细节——Claude特别偏爱用CTE(Common Table Expressions)写SQL,而他们的解析器恰好非常擅长处理CTE,形成了意外的完美契合。
CTE(Common Table Expressions,公共表表达式) 是SQL中以WITH关键字开头的一种查询结构,允许在主查询执行前先定义一个或多个命名的临时结果集。相比将逻辑全部嵌套在单条复杂SQL中,CTE让查询结构更接近自然语言的逐步推理——先定义「活跃用户」,再定义「付费活跃用户」,最后计算比率。这种结构对大模型友好有其内在原因:训练数据中大量人类编写的「可读性好的SQL」本身就倾向于使用CTE分解复杂逻辑,因此Claude在生成SQL时复现了这一风格。而Omni解析器对CTE的优化支持,本质上是针对结构清晰、层次分明的查询模式所做的工程投入——两者的设计偏好在此形成了意外共鸣,也印证了「押注模型擅长的输出风格」这一策略选择的合理性。
做自己工具的用户:Claude Code反哺产品设计
现在的Blobby拥有完整的agentic系统:外层循环负责checkpoint和故障恢复,内层循环则有一套快速增长的工具集——生成仪表盘、生成可视化、数据建模、验证工具等。
CTO特别推崇eval系统,而且理由与众不同:他最看重的是eval能提供原始trace数据的可观测性,让他能直接追问「这个为什么不行」,再翻看数据定位问题。
更深一层的收获在于:作为Claude Code的重度用户,Omni工程师反过来理解了一个好的agent harness应该长什么样。CTO举例,当团队要设计探索Semantic Model的新方式时,他们会先看Claude Code是怎么做的——毕竟「Semantic Model其实跟代码库没差多少」。这种「做自己工具的用户」的能力,让工程师能深度代入问题,看到解决问题的最新技术样貌。
写在最后
Omni的分享给出了一条清晰的Agent工程演进路径:补齐本地化上下文 → 构建agentic loop并优化错误恢复 → 通过trace分析做结构性重构 → 押注模型最擅长的能力(SQL)→ 用eval保障可预测性。对于任何正在构建AI Agent的团队,这套从真实生产环境提炼的经验,比抽象的方法论更具参考价值。而那条陡然上扬的代码提交曲线,或许正是AI辅助开发最直观的注脚。
相关推荐

用Claude Code发现系外行星候选:AI如何做真科研
一位研究者使用Claude Code分析NASA TESS望远镜数据,发现一颗116光年外的系外行星候选体。本文解析其如何通过多智能体交叉审计、隐藏数据验证和预注册预测,让AI辅助科研真正可证伪。

基于LangGraph.js的自托管GitLab AI审查Agent实战
一位开发者基于LangGraph.js构建自托管GitLab AI审查Agent,已审查1000+合并请求,三分之二评论被采纳。本文解析其中间件纠错、Critic筛查、Qwen自托管模型及项目记忆机制等生产级实践经验。

类Hugging Face的开源模式库:可解释MLOps新思路
一位开发者提出构建类似Hugging Face的开源「模式数据库」,将黑箱模型转化为可管理的模式集合,为MLOps和可解释AI提供新思路。本文解析该构想的价值与挑战。