OmniCapBench:音频-视觉字幕评估的深度结构化框架

OmniCapBench 用原子化评估单元重构音频-视觉字幕评测,精准诊断MLLM的长时程推理短板。
OmniCapBench 提出了一种深度结构化的音频-视觉字幕评估框架,将传统的自由文本评分重构为实体引用、视觉镜头和音频事件三组原子化、可验证的评估单元,并采用确定性约束检查与局部LLM语义比较相结合的混合评分策略,兼顾覆盖度与定位精度。该基准包含786个密集标注视频,能够诊断时序定位失败、身份漂移、跨模态错位和幻觉描述四类典型错误。对前沿MLLM的评估显示,模型在局部感知任务上表现较强,但长时程音频-视觉推理明显薄弱,身份漂移与跨模态错位是主要瓶颈,为全模态模型的改进指明了方向。
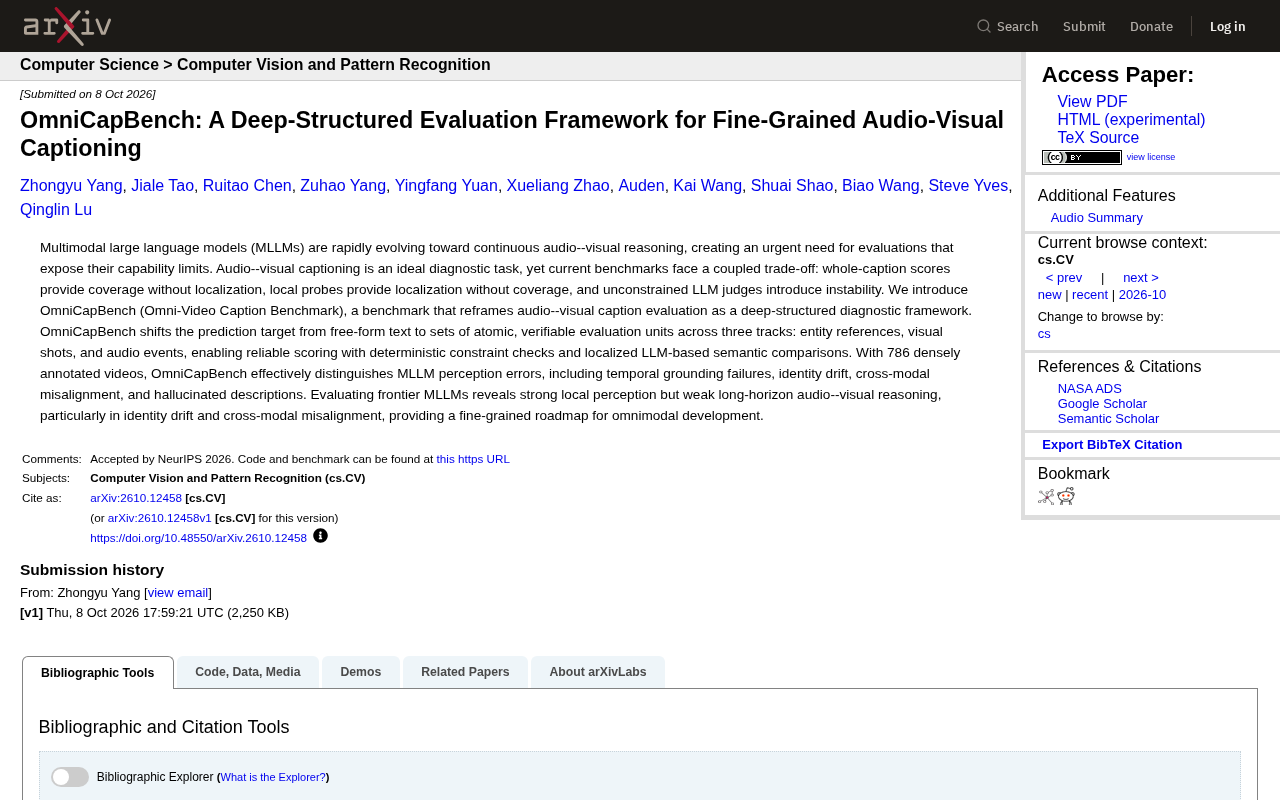
多模态大语言模型(MLLMs)正快速向连续音频-视觉推理演进,如何准确评估其能力边界成为亟待解决的问题。音频-视觉字幕生成作为一项理想的诊断任务,现有基准却面临一个耦合的权衡困境:整体字幕评分覆盖全面但缺乏定位能力,局部探测定位精确但覆盖不足,而无约束的LLM评判则引入不稳定性。OmniCapBench 的提出,正是为了打破这一僵局。
核心思路:从自由文本到原子化评估单元
OmniCapBench(Omni-Video Caption Benchmark)将音频-视觉字幕评估重新定义为一个深度结构化的诊断框架。与传统的自由文本预测不同,该基准将预测目标转变为三组原子化、可验证的评估单元:实体引用、视觉镜头和音频事件。
这一设计的关键在于,每个评估单元都可以通过确定性约束检查进行可靠评分,同时结合局部化的LLM语义比较,既保证了覆盖度,又实现了精确定位。相比以往依赖整体评分或模糊LLM判断的方案,这种结构化方法显著提升了评估的稳定性和可解释性。
多模态大语言模型(MLLMs) 指能够同时处理文本、图像、音频、视频等多种模态输入并生成文本输出的大规模模型,代表性工作包括 GPT-4o、Gemini、Qwen-VL 等。与传统单模态模型不同,MLLM 需要在统一表征空间中对齐不同模态的语义,因此其能力边界不仅取决于单一模态的感知精度,更取决于跨模态的融合与推理质量。
音频-视觉字幕生成(Audio-Visual Captioning) 要求模型观看一段视频并同时听其音频,然后生成描述视频内容的自然语言字幕。该任务天然涉及视觉对象识别、音频事件检测、时序定位以及跨模态关联等多个子能力,因此被认为是诊断 MLLM 综合感知能力的理想探针。
确定性约束检查 指不依赖模型判断、而由规则或程序化匹配完成的评分方式。例如,检查字幕中是否出现了某个已标注的实体名称、某事件的时间戳是否落在标注区间内。与之相对的 LLM 语义比较 则允许一定程度的表述灵活性,由语言模型判断生成文本与参考标注在语义上是否等价。OmniCapBench 将两者混合使用,兼顾评分的客观性与语义的宽容度。
数据集与诊断能力
OmniCapBench 包含786个密集标注的视频,规模虽不算庞大,但标注密度和结构化程度使其能够有效区分MLLM的多种感知错误类型。具体而言,该基准可以诊断以下四类典型失败模式:
- 时序定位失败:模型无法准确关联事件发生的时间点
- 身份漂移:在长视频中,模型逐渐混淆不同实体或说话人
- 跨模态错位:音频与视觉信息之间的对应关系出现偏差
- 幻觉描述:模型生成视频中并不存在的内容
这种细粒度的错误分类能力,使研究者不再只能获得一个笼统的"好或差"的分数,而是能够定位模型具体在哪个环节出了问题。
身份漂移(Identity Drift) 是长视频理解中的典型退化现象:模型在视频开头能正确识别并追踪某个实体(人物、物体或说话人),但随着时间推移,由于上下文窗口有限、注意力衰减或跨帧关联能力不足,模型会逐渐将该实体与另一个实体混淆,或在后续描述中给出错误的指代。这种错误往往不会表现为明显的幻觉,而是隐蔽的、渐进的一致性丧失,因此在传统整体评分中容易被平均掉。
跨模态错位(Cross-Modal Misalignment) 指模型将音频信息错误地绑定到视觉信息上。例如,画面中 A 在说话,而音频中发声的是 B,模型却描述为 A 在说话;又如将背景音乐误判为画面中某物体发出的声音。这类错误直接暴露了模型在视听对齐机制上的缺陷,是评价全模态模型的核心指标之一。
前沿模型的表现揭示关键短板
对当前前沿MLLM的评估结果呈现出一个清晰的模式:模型在局部感知任务上表现较强,但在长时程音频-视觉推理方面明显薄弱。
身份漂移和跨模态错位是最突出的两个薄弱环节。这意味着,当视频长度增加、涉及多实体交互时,模型维持一致的实体追踪和跨模态对齐的能力会显著下降。这一发现为全模态(omnimodal)模型的发展提供了明确的方向指引——未来的改进不应仅聚焦于单帧感知精度的提升,更需要加强长时程的时序推理和跨模态一致性维护能力。
全模态(Omnimodal)模型 指能够在同一架构中统一处理文本、图像、音频、视频乃至其他感知信号,并支持跨模态任意组合输入输出的模型。与仅支持图文的多模态模型相比,全模态模型需要解决更复杂的模态间时序对齐和统一表征问题。当前主流全模态模型多采用“视觉编码器 + 音频编码器 + 大语言模型主干”的拼接式架构,各模态编码器独立预训练后在语言模型层融合。这种架构在局部感知任务上表现良好,但在需要跨模态长时程推理时,由于缺少显式的时序对齐监督,容易在身份追踪和音视绑定上出现退化,这正是 OmniCapBench 诊断结果所揭示的核心瓶颈。
对评估方法论的启示
OmniCapBench 的价值不仅在于其诊断结果,更在于其评估范式的转变。传统的整体评分虽然方便,但无法告诉开发者模型究竟哪里出了问题;纯粹的局部探测虽然精确,却难以反映模型的综合能力。
将评估目标拆解为原子化单元,并用确定性检查加局部LLM语义比较的混合策略进行评分,这一思路或许可以推广到更广泛的多模态评估场景中。对于需要精细诊断模型能力的任务而言,深度结构化的评估框架比单一维度的分数更具实际指导意义。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。