OntoDoc:多智能体框架自动生成本体资源描述

OntoDoc 是多智能体框架,可为任意 IRI 自动生成证据驱动的本体自然语言描述。
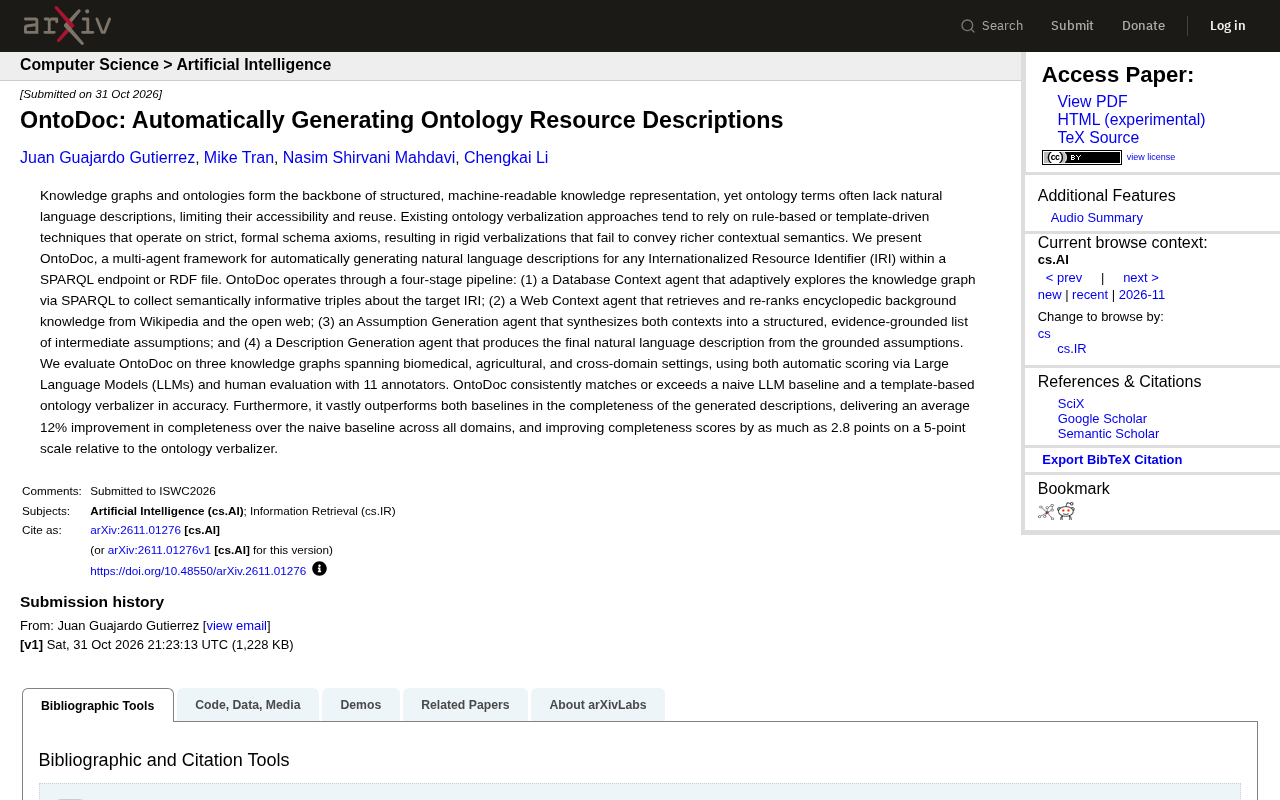
OntoDoc 是一个多智能体框架,旨在为知识图谱中的任意国际化资源标识符(IRI)自动生成自然语言描述,以解决本体术语缺乏可读文档的问题。针对传统规则或模板方法灵活性差、无法利用外部知识的局限,OntoDoc 设计了四阶段流水线:数据库上下文智能体通过 SPARQL 自适应探索知识图谱收集三元组,网络上下文智能体从维基百科和开放网络检索百科知识并重排序,假设生成智能体综合两种上下文合成有证据支撑的中间假设,描述生成智能体基于假设产出最终描述。在生物医学、农业和跨领域知识图谱上的评估表明,OntoDoc 在准确性上达到或超过朴素 LLM 基线和模板语言化器,完整性平均比朴素基线提升 12%,相对模板方法最多提升 2.8 分(5 分制)。该方法将本体描述生成从规则驱动推向证据驱动,有望降低人工文档成本并促进本体复用。
OntoDoc:多智能体框架自动生成本体资源描述
知识图谱和本体是结构化、机器可读知识表示的基础,但本体中的术语往往缺乏自然语言描述,这限制了它们的可访问性和复用性。现有的本体语言化方法多依赖基于规则或模板的技术,只能处理严格的形式化模式公理,生成的描述较为僵硬,难以传达更丰富的上下文语义。为此,研究者提出了 OntoDoc——一个多智能体框架,能够为 SPARQL 端点或 RDF 文件中的任意国际化资源标识符(IRI)自动生成自然语言描述。
现有方法的局限与 OntoDoc 的突破
传统的本体语言化(ontology verbalization)通常采用规则或模板驱动的方式,直接基于形式化公理生成文本。这种方法虽然可控,但灵活性差,无法利用本体之外的知识来丰富描述。OntoDoc 则通过引入多智能体协作,将知识图谱内部的结构化信息与外部开放网络中的百科知识相结合,从而生成更全面、更具语义深度的自然语言描述。
本体语言化(ontology verbalization)是自然语言生成的一个子任务,目标是将本体中的形式化公理(如类包含、属性约束、实例断言)转换为可读的自然语言文本。早期系统多采用基于模板的方法,例如将 SubClassOf(A, B) 直接映射为“A 是 B 的子类”。这类方法可控性强、输出确定,但严重依赖人工编写的模板库,难以覆盖本体中复杂或非常规的公理模式,也无法引入外部知识来补充语境。另一类基于规则的方法则通过语法规则组合短语,但同样受限于规则覆盖范围。这些局限促使研究者探索数据驱动或混合式方法,利用大规模语言模型和外部知识源来生成更灵活、更丰富的描述。
四阶段流水线:从探索到生成
OntoDoc 的工作流程分为四个阶段,每个阶段由一个专门的智能体负责:
1. 数据库上下文智能体
该智能体通过 SPARQL 自适应地探索知识图谱,收集与目标 IRI 语义相关的三元组。它不局限于预定义的查询模板,而是根据图谱结构动态调整查询策略,以获取尽可能丰富的上下文信息。
SPARQL 是 W3C 推荐的 RDF 查询语言,支持在知识图谱上执行模式匹配和路径查询。在 OntoDoc 中,数据库上下文智能体并非执行固定的查询模板,而是根据目标 IRI 的类型(类、属性或实例)动态构造 SPARQL 查询,例如检索该 IRI 的标签、注释、定义域/值域、上下位关系以及关联实例等。这种自适应探索策略能够在不预先知道图谱模式的情况下,尽可能全面地收集与目标 IRI 语义相关的三元组,为后续的假设生成提供结构化证据。
2. 网络上下文智能体
该智能体从维基百科和开放网络中检索百科背景知识,并对结果进行重排序,以补充知识图谱中可能缺失的常识或领域背景。
国际化资源标识符(IRI)是 RDF 中用于唯一标识资源的标准方式,可视为 URI 的扩展,支持 Unicode 字符。一个 IRI 通常包含命名空间和本地名,例如 http://example.org/ontology#Heart。在实际知识图谱中,许多 IRI 仅包含缩写或编码,缺乏人类可读的标签和注释。OntoDoc 的网络上下文智能体正是针对这一痛点,利用 IRI 的本地名或图谱中提取的标签作为查询词,从维基百科和开放网络中检索百科背景知识,并对检索结果进行重排序,以补充知识图谱中缺失的常识或领域背景,从而帮助生成更完整的自然语言描述。
3. 假设生成智能体
该智能体将上述两种上下文综合起来,合成一个结构化的、有证据支撑的中间假设列表。这些假设作为后续描述生成的依据,确保描述内容有据可查。
4. 描述生成智能体
该智能体基于 grounded 假设生成最终的自然语言描述。由于假设已经过证据校验,生成的描述在准确性和完整性上都有保障。
实验评估:跨领域验证与人工评分
研究者在三个知识图谱上评估了 OntoDoc,分别涵盖生物医学、农业和跨领域场景。评估采用了两种方式:基于大语言模型(LLM)的自动评分和 11 位标注者的人工评估。
结果显示,OntoDoc 在准确性上始终达到或超过朴素的 LLM 基线(naive LLM baseline)和基于模板的本体语言化器(template-based ontology verbalizer)。在完整性方面,OntoDoc 大幅领先于两个基线:在所有领域中,其完整性平均比朴素基线提升 12%;相对于本体语言化器,在 5 分制量表上完整性得分最多提升 2.8 分。
意义与展望
OntoDoc 的意义在于将本体描述生成从“规则驱动”推向“证据驱动”,通过多智能体协作整合内外部知识,显著提升了描述的完整性和上下文丰富度。对于知识图谱的构建者、维护者以及依赖本体进行下游应用(如问答系统、语义搜索)的开发者而言,这种自动化描述生成能力有望降低人工编写文档的成本,并促进本体的复用。
不过,该方法目前仍依赖于外部网络知识源的质量,且评估规模有限。未来如何保证生成描述的可靠性、处理多语言场景,以及将框架扩展到更复杂的本体结构,是值得关注的方向。
相关推荐

AI编程工具成新攻击面:伪造Claude扩展窃取开发者信息
伪造Claude代码扩展现身Cursor市场,11小时内影响多达5000名开发者,窃取主机信息并植入SSH后门。了解攻击手法、自查步骤与AI编程工具的安全防御策略。
ChatGPT 12月起改算Token:聊天与Codex共用额度,谁最受影响?
ChatGPT 12月起改用Token计费,聊天与Codex共用额度。简单问题可用Instant免额度,重度Codex用户影响最大。本文解析新规则、额度查询与Credits购买方式。

ChatGPT与Codex合并额度:谁先用完?
OpenAI将于12月合并ChatGPT与Codex的付费额度,统一按token计量。本文解析合并细节、token计量的模糊性、OpenAI的财务动机,以及用户应对策略。