OPD容忍多大的训练-推理不匹配?实证预算与FP8加速方案

OPD对训练-推理不匹配容忍度高,可预算化利用FP8与异步rollout加速。
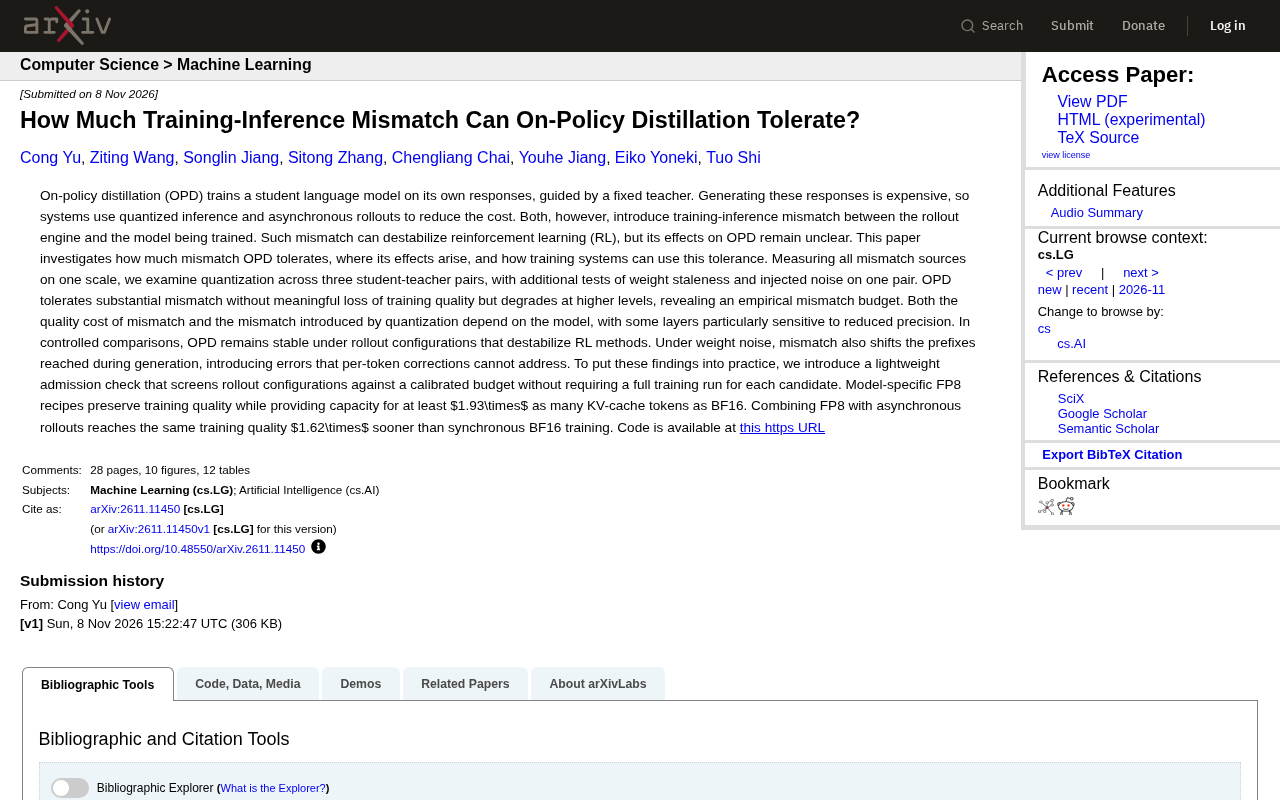
该研究系统测量了on-policy distillation(OPD)中训练与推理不匹配的影响,将量化、权重陈旧和噪声等偏差统一量化比较。核心发现是OPD存在经验性的“mismatch预算”,在此范围内不损失训练质量,超过则性能下降。不匹配的代价因模型和层而异,部分层对精度敏感;使RL失稳的配置在OPD下仍稳定。权重噪声会改变生成前缀,造成逐token校正无法修复的错误。作者提出轻量准入检查筛选配置,并给出模型特异性FP8配方:KV-cache容量至少提升1.93倍,结合异步rollout比同步BF16训练快1.62倍达到相同质量。
在强化学习(RL)和大模型训练中,训练与推理之间的不一致(mismatch)常被视为稳定性的隐患——量化推理、异步rollout等工程手段虽然降低了成本,却让rollout引擎与训练模型之间产生偏差。然而,在on-policy distillation (OPD) 场景下,这种不匹配的影响一直缺乏系统研究。最近一篇论文对此展开了深入测量,并给出了可落地的工程建议:OPD对mismatch的容忍度远高于预期,甚至能在不损失训练质量的前提下,利用FP8量化与异步rollout实现显著的加速。
一、测量方法:把不匹配放到同一把尺子上
研究团队将不同来源的mismatch统一量化为一个尺度,以便横向比较。他们用三组学生-教师模型对考察了量化带来的影响,并在其中一组上额外测试了权重陈旧(weight staleness)和注入噪声的影响。这种设计使得不同不匹配源的效应可以直接对比,而非各自孤立评估。
核心发现是:OPD能够容忍相当程度的不匹配而不出现明显的训练质量损失,但当不匹配超过某个水平后性能开始下降,从而呈现出一个经验性的“mismatch预算”。这意味着工程上不必追求绝对的训练-推理一致性,只要将偏差控制在预算内即可。
On-policy distillation (OPD) 是一种知识蒸馏范式,其核心在于学生模型在训练过程中生成的轨迹(rollout)由教师模型实时打分,而非使用固定的离线数据集。这与传统离线蒸馏不同:后者通常让学生模仿教师在一个静态数据集上的输出,而 OPD 要求学生始终在自己的策略分布上采样,因此对训练与推理引擎之间的任何偏差都更为敏感。也正因如此,rollout 引擎与训练模型之间的不匹配在 OPD 中既无法回避,又可能被放大,这正是该研究选择 OPD 作为切入点的重要原因。
权重陈旧(weight staleness) 指异步 rollout 中,生成轨迹所使用的模型参数落后于当前训练步的模型参数。在同步训练中,rollout 与训练严格交替,参数始终一致;而异步系统为了提高吞吐,允许 rollout 引擎在后台用旧参数生成样本,待其返回时训练模型已经更新了若干步。陈旧度通常用参数版本差或时间延迟来衡量。它带来的偏差不同于量化误差:量化影响的是单次前向计算的数值精度,而权重陈旧改变的是生成策略本身,可能使采样分布偏离当前策略,进而影响 OPD 中教师打分的有效性。
二、模型特异性:质量代价与量化偏差因模型而异
论文指出,不匹配带来的质量代价以及量化引入的偏差都依赖于具体模型。某些层对精度降低尤其敏感——这提示在实际部署中,需要对不同层采取差异化的量化策略,而不是一刀切地使用低精度。对于追求效率的训练系统,识别出这些敏感层是平衡速度与质量的关键。
与RL的对比:OPD更稳
在受控比较中,那些会使RL方法失稳的rollout配置,在OPD下仍然保持稳定。这一差异可能源于OPD与RL在训练信号和更新方式上的本质不同。对于同时使用两类方法的团队,这意味着不必将RL的稳定性经验直接套用到OPD上,OPD可能允许更激进的推理优化。
FP8 量化 是一种 8 位浮点数值格式,相比 BF16 可将显存占用和带宽需求减半,从而在推理时支持更大的 KV-cache 或更高的并发。FP8 通常分为 E4M3(4 位指数、3 位尾数)和 E5M2(5 位指数、2 位尾数)两种变体,前者精度更高、动态范围较小,后者动态范围更大但精度较低。在 LLM 推理中,FP8 常用于权重和激活值量化,而 KV-cache 的 FP8 量化能直接提升可缓存的 token 数量。不同层对 FP8 的敏感度差异显著,例如注意力输出投影和某些归一化层往往更易受量化噪声影响,这也是论文强调“模型特异性配方”而非统一量化的原因。
三、权重噪声的隐患:前缀偏移问题
权重噪声带来的不匹配不仅影响逐token的预测,还会改变生成过程中到达的前缀。这种错误无法通过逐token的校正来弥补,因为生成路径本身已经偏离。这一发现揭示了mismatch的深层影响:它不只是局部噪声,还可能改变整个生成轨迹。对于依赖精确前缀匹配的下游任务,需要额外关注。
前缀偏移(prefix shift) 指的是生成过程中由于早期 token 的偏差,导致后续所有 token 的条件分布建立在错误的前缀之上。在自回归生成中,每个 token 的预测都依赖于此前已生成的全部 token;一旦某个早期 token 因权重噪声或量化误差被错误采样,后续生成就会沿着一条不同的轨迹展开。这种误差无法通过逐 token 的 logit 校正来修复,因为校正只能针对当前步,而错误已经改变了上下文。对于 OPD,这意味着教师对错误前缀下的学生输出打分,可能给出与真实策略分布不匹配的监督信号,从而影响蒸馏效果。
四、落地工具:轻量准入检查与FP8配方
为了让发现能用于实践,作者引入了一个轻量的准入检查(admission check)。该检查利用校准好的预算来筛选rollout配置,而无需为每个候选配置运行完整训练。这大大降低了调参和系统配置的试错成本。
在具体优化上,模型特异性的FP8配方在保持训练质量的同时,提供了至少1.93倍于BF16的KV-cache token容量。将FP8与异步rollout结合,达到相同训练质量所需的时间比同步BF16训练快1.62倍。这些数据表明,合理利用mismatch容忍度可以换来可观的系统效率提升。
代码已开源于 https://github.com/benyucong/train-inference-mismatch-opd 。
五、实践启示
这项研究传递出一个明确信号:在OPD中,训练-推理不匹配并非必须消除的敌人,而是一个可以被测量、预算和利用的资源。工程团队可以借助准入检查快速评估配置,采用模型特异的FP8配方,并在预算内大胆使用异步rollout。未来,随着更多模型和任务的验证,这种“容忍并利用”的思路或许会成为高效训练系统的标配。
相关推荐
Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
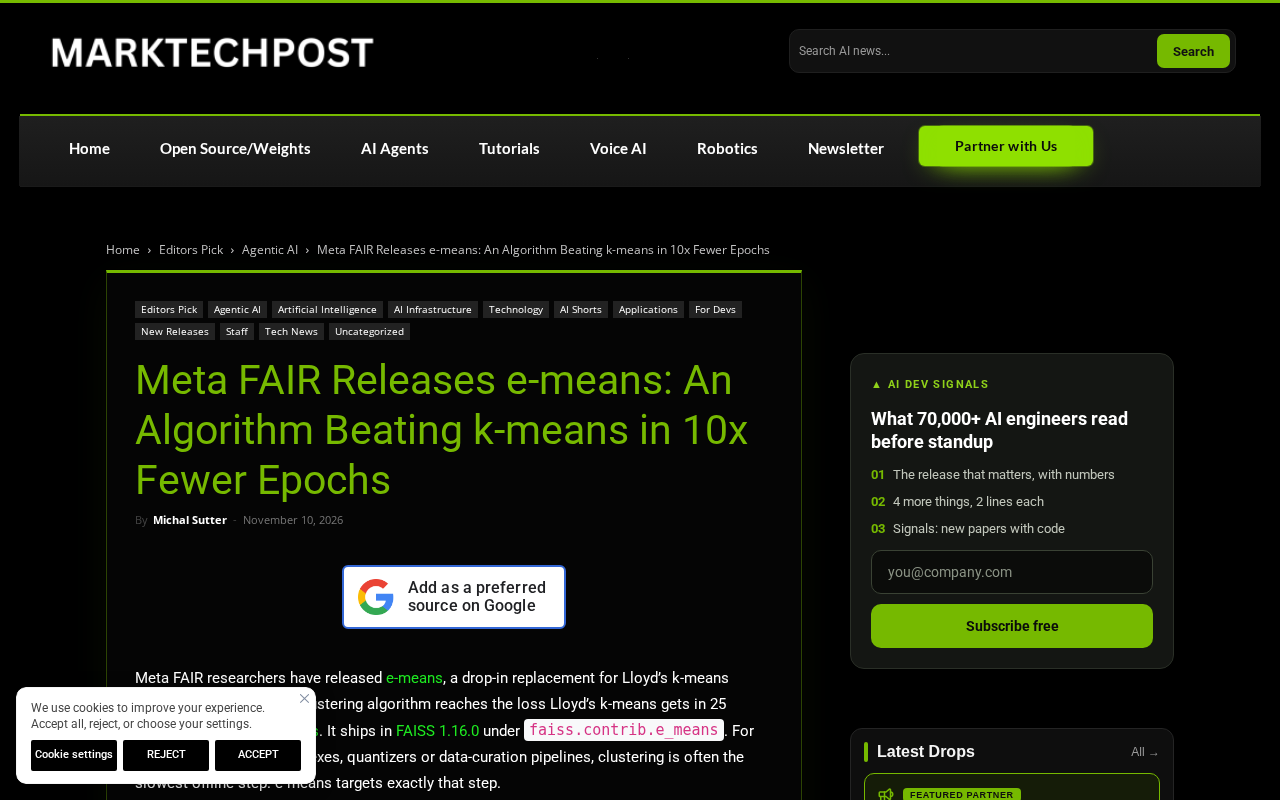
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。
AI写代码好用,但为何代码库越来越脆弱?
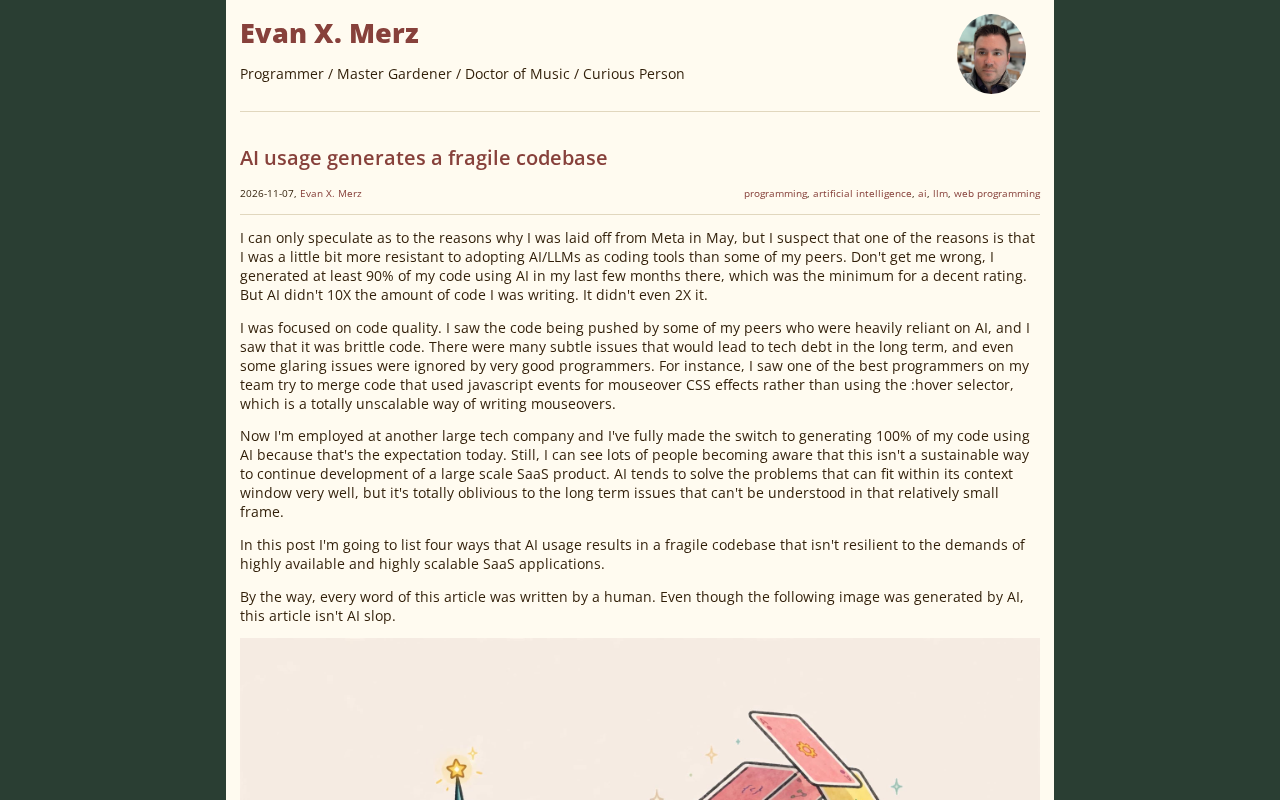
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。