Open WebUI 实战:从零构建自定义编程 Agent

Open WebUI 编程 Agent 全搭建流程,以及一个关键实验结论:Agent 成败的关键是基座模型能力而非框架配置。
本文以 Open WebUI v0.9.6 为基础,完整演示了如何搭建一个可真实改动代码库的 Python 编程 Agent,涵盖基座模型选择、结构化系统提示词设计、记忆功能激活、能力配置,以及 open-terminal 容器的构建与 docker-compose 接入。文章的核心价值在于一组对比实验:使用 gpt-5.4-nano 时,Agent 拥有完整工具链却反复无法真正执行命令,只能"描述"操作;换用 gpt-5.5 后,同一套框架下 Agent 一次性完成了项目创建、服务启动和 curl 测试全流程。这一对比直接印证了文章的核心论点:Agent 执行力的关键不在于框架有多完善,而在于底层模型是否具备可靠的工具调用与指令遵循能力,在模型选型上不应为省成本而牺牲执行可靠性。
Open WebUI 已经从最初的 Ollama 聊天界面,演变为一个可对接任意 OpenAI API 端点的完整 Agent 平台。它的能力矩阵覆盖了 RAG 知识库检索、图像与文本上下文、持久化记忆,以及新加入的 Terminal 功能——后者能连接 Docker 容器执行任意代码。这套组合拳让 Open WebUI 真正具备了端到端的 Agent 能力。
本文基于 Open WebUI v0.9.6 版本,完整拆解如何搭建一个能够实际改动代码库的 Python 编程 Agent,并通过两次对比实验,揭示一个被很多人忽视的关键事实:Agent 的执行力,很大程度上取决于底层模型本身的能力。
Agent 的需求定义与模型选择
搭建 Agent 的第一步不是写配置,而是明确需求边界。本次的编程 Agent 目标很克制:
- 基座模型:一个具备编码能力的较新模型
- 自定义提示词:扮演一名工作方法严谨、结构化的资深 Python 全栈工程师
- 工具:不接入特殊工具
- 知识库:无需本地专有知识
- 记忆:会话应持久化,例如记住技术栈选型
在 Open WebUI 的 GUI 中,自定义模型通过 Workspace → Models 创建。基座模型方面,作者选择了成本相对保守的 gpt-5.4-nano——这一选择看似节省,却在后续实验中成为影响结果的关键变量。
提示词设计上,作者借助另一个 LLM 生成了一段颇具风格的系统提示,将资深工程师的特质拆解为四个维度:系统思考者的清晰、机械师的纪律、档案管理员的记忆、以及实证主义者的严谨。提示词明确要求模型写出符合习惯、强类型、可维护的 Python 代码,优先选择务实方案而非时髦的复杂设计,并在设计复杂方案前先声明假设。这种结构化提示比泛泛的"你是一名资深工程师"要有效得多。
记忆与能力配置
Open WebUI 默认关闭记忆功能,需要用户手动开启:点击用户头像 → Settings → Personalization,翻转开关即可。开启后,每次交互都可能存储遇到的持久化事实,并支持列出和编辑记忆条目。
能力(Capabilities)定义了允许的工具调用,启用后会扩展系统提示或附加对话元数据。Open WebUI 的 Docker 镜像已内置大部分工具所需的库,容器可直接运行代码解释、访问任务、笔记和记忆。但 Web 搜索和 Terminal 访问仍需额外配置,其中 Terminal 的配置最为复杂。
Open WebUI 的"记忆"功能在实现上属于**长期外部记忆(External Long-term Memory)**模式,区别于模型权重内置的参数记忆。每次对话结束后,系统会提取被认为值得保留的事实(例如用户偏好的技术栈、项目约定等)并写入持久化存储;下次新建会话时,这些记忆片段会被注入系统提示,从而让模型"知道"跨会话上下文。这种机制的局限在于:记忆质量依赖于模型对"哪些信息值得记录"的判断,弱模型可能存储无关信息或遗漏关键细节;记忆条目数量增长后也会占用宝贵的上下文窗口。对编程 Agent 而言,记忆的典型用途包括锁定框架选型(如"始终用 FastAPI 而非 Flask")、编码风格约定,以及跨会话的项目状态摘要。
Open WebUI Terminal:让 Agent 真正能执行代码
open-terminal 项目 提供了一个暴露 REST API 的 Python 包,用于文件系统交互和命令执行,充当 Agent 的"终端",提供原始文件系统访问能力。
该项目提供四种镜像变体,覆盖不同场景:
latest:4GB 重型镜像,包含完整的 C++、Python、Node.js 和数据科学库栈,默认用户可用sudo安装额外软件包slim:生产镜像,仅额外附带gitalpine:基于 Alpine 的精简版,体积压缩到 230MBopenshift:受安全上下文约束(SCC)的镜像,进一步最小化访问权限
构建自定义镜像
由于作者已经通过 docker-compose.yml 运行 Open WebUI,自然选择扩展一个 open-terminal 服务,并定制镜像以包含所需的库。
从仓库下载 Dockerfile.slim:
git clone --depth=1 https://github.com/open-webui/open-terminal.git
作为 Python 工程师场景,pip 是必需的,需在 Dockerfile 的自定义包区段补上:
RUN apt-get update && apt-get install -y --no-install-recommends \
        python3-pip \
        tini \
        ...
构建并打上自定义标签:
docker build -f Dockerfile.slim -t open-terminal-custom-python:20260628 .
接入 Docker Compose 与 Open WebUI
在 compose 文件中新增 terminal 服务,挂载卷、配置环境变量文件 open-terminal.env 并填入自生成的 OPEN_TERMINAL_API_KEY。启动后,容器日志会打印 ASCII 艺术字 Logo,并提示服务运行在 http://0.0.0.0:8000。日志同时会警告 CORS 被设置为 *(允许所有来源),生产环境应当限制。
最后在 Open WebUI 中建立连接:点击用户头像 → Admin Panel → Integrations → 在 Open Terminal 旁点击 +,填入 Docker 内部地址 http://open-webui-terminal:8000 及 API Key,测试连接后保存。连接成功时,terminal 容器日志会出现 GET /api/config HTTP/1.1 200 OK。
从安全角度理解 open-terminal 的工作原理有助于评估引入它的风险。open-terminal 本质上是一个在隔离容器内运行的命令执行代理:LLM 通过 Open WebUI 生成 shell 命令,Open WebUI 将其以 HTTP 请求形式发送给 open-terminal 容器的 REST API,容器在自身文件系统中执行后返回 stdout/stderr。这种设计的关键安全边界在于 Docker 容器的隔离层——LLM 执行的命令被约束在容器内部,无法直接访问宿主机文件系统,除非显式挂载了宿主机目录。正因如此,挂载卷时需格外谨慎:如果将宿主机代码目录挂载进容器,Agent 将获得真正意义上修改宿主机文件的能力,这既是"让 Agent 改动代码库"的前提,也是潜在的风险来源。生产环境中,建议配合只读挂载、网络隔离和严格的 CORS 策略来收紧攻击面。
两次实验:模型能力决定 Agent 成败
这篇文章最有价值的部分,是作者用同一套配置、不同基座模型做的对比实验。结论颇具启发性。
第一次运行:gpt-5.4-nano 的挣扎
首轮测试要求 Agent 创建一个使用 Poetry 管理依赖的 Python REST API 项目。然而问题立刻出现——模型并没有真正执行命令,而是"描述"了应该创建哪些文件。当被追问命令是否实际执行时,模型坦承:
"No—我只是在描述要创建什么,但并没有真正在你的文件系统里运行终端或生成仓库。"
作者由此发现一个容易被忽视的细节:终端默认未启用,需要在聊天窗口点击一个小云朵图标手动开启。即便开启后,模型仍反复表示无法读取命令的 stdout/stderr,让用户"把输出粘贴过来"它才能诊断。要让它真正对启动的应用执行一次 curl 请求,花费了多次尝试。
这种卡顿引出一个关键问题:这究竟是 Open WebUI 工具栈的限制,还是模型本身的能力问题?
这种"描述而非执行"的行为模式在 Agent 领域有一个专有名词:工具调用幻觉(Tool Call Hallucination)。它指模型在应当发起实际工具调用时,转而生成描述性文本——输出看起来像在"执行",实则只是在语言层面模拟操作结果。较小的模型(尤其是参数量或训练数据受限的版本)在工具调用方面往往表现不稳定:它们可能无法可靠识别"当前上下文要求我调用终端工具"的触发时机,或者将工具调用格式化错误导致框架无法解析。这也是为什么 Agent 框架的能力上限,最终由模型遵循工具调用规范(如 OpenAI Function Calling 格式)的能力所决定——框架本身无法弥补模型在指令遵循层面的不足。
第二次运行:gpt-5.5 的一气呵成
第二轮作者只改了三处:基座模型升级到 gpt-5.5,并关闭了 Web 搜索能力与图像生成工具,排除干扰。
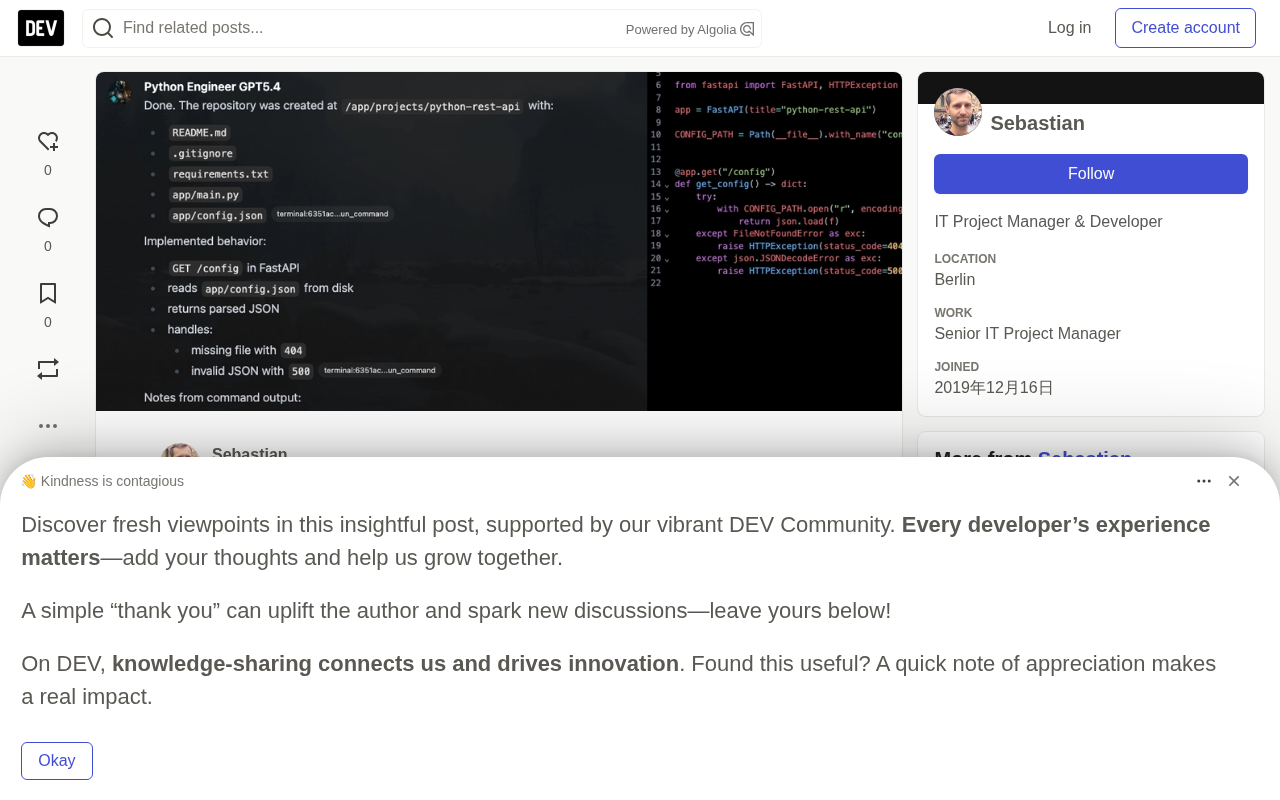
结果判若两人。一条提示词就让模型完成了整套流程:创建仓库、生成 README、.gitignore、requirements.txt、app/main.py 和 app/config.json,用 FastAPI 实现读取配置文件的 GET /config 路由,并处理了文件缺失(404)和 JSON 非法(500)的边界情况。模型还如实报告了环境中 pip 不可用(No module named pip)但 compileall 编译成功的真实命令输出。
随后一条"启动服务并 curl 测试"的指令同样顺利执行,返回了完整的 HTTP 200 响应、JSON 配置内容,以及 /config/ 带尾斜杠时的 307 重定向——所有命令输出都被忠实捕获和展示。
两次实验的对比极其鲜明:相同的 Agent 框架、相同的工具配置,仅仅因为基座模型从 nano 升级到标准版,Agent 就从"反复推诿、无法执行"变成了"一次性准确完成"。
结论:Agent 框架之外,模型才是地基
本文完整演示了在 Open WebUI 中搭建编程 Agent 的全流程:从选定基座模型、注入结构化提示词、激活记忆,到定义能力与工具,再到构建自定义 Terminal 容器并接入 compose 栈。
但最深刻的启示藏在两次实验的落差里。一个能力不足的小模型(gpt-5.4-nano)即便拥有完整的工具链,也会在"是否真的执行了命令"这种基础问题上反复失灵;而一个足够强的模型(gpt-5.5)在相同框架下能一次性完成文件创建、服务启动和端点测试。
这印证了一句话:能力强的 Agent,需要能力强的模型配上能力强的执行框架,二者缺一不可。 对于想自建私有 Agent 的开发者来说,Open WebUI 提供了成熟而灵活的编排能力,但在模型选型上千万不要为了省成本而牺牲执行可靠性。
相关推荐
EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马EduRAG智慧问答系统实战课程解析:涵盖LangChain、Milvus向量数据库、混合检索与重排序,解决IT领域事实性幻觉,附就业行情与学习路径。
Mia Goth怒斥Instagram放任AI假图:认证账号也难逃AI伪造
Mia Goth发现一张AI生成的假图通过Instagram蓝V认证账号广泛传播,她公开质疑平台为何未能拦截。此事暴露了社交平台认证体系在应对AI伪造内容时的结构性漏洞。
Google 让 Vibe-Coded 应用一键上架 Play Store
Google 在美国推出新功能,允许开发者将 AI Studio 中 vibe-code 的个人应用直接通过 Play Store 发布,无需连接电脑侧载安装。本文分析这一功能对个人开发者的影响、AI 编程工具竞争格局的变化,以及审核机制等潜在问题。