OpenAI Agents SDK 实战:Runner、工具与首个AI Agent

OpenAI Agents SDK实战教程:从API Key配置到Runner执行、工具系统与成本管控的完整入门。
本文系统讲解了OpenAI官方Agents SDK的入门使用路径。SDK本身provider-agnostic,支持100多种LLM,同时提供Python和JavaScript版本。文章依次介绍了API Key的获取(需单独在platform购买credit,普通ChatGPT账号不可用)与安全配置(.env + .gitignore)、虚拟环境安装、一行代码创建Agent、Runner的三种执行方式(run_sync同步阻塞、run+await异步并发、run_stream流式输出),以及RunResult对象在token成本追踪和架构可视化上的关键作用。工具部分区分了Hosted Tool(Web Search、Code Interpreter等)与自定义function_tool,并通过TODO任务助手实战,串联添加/列出任务、本地持久化task.json的完整流程。核心结论是:这套SDK的真正价值在于把企业级Agent的观测、编排、成本与治理能力内建到框架中。
从多个Agent框架到OpenAI Agents SDK
在过去几周的学习中,我们先后用核心Python、本地LLM(Llama + Ollama)以及Google的SDK构建过AI Agent。这一次轮到OpenAI官方的Agents SDK——它被设计为一套相对轻量但功能完整的框架,目标直指企业级Agent应用。
据该教程介绍,OpenAI Agents SDK有几个值得关注的特点。它主要基于OpenAI的completion方法,但并不把自己绑定在OpenAI身上:支持超过100种不同的LLM模型,并且在设计上是provider-agnostic的,Claude、Gemini、Grok等第三方API都可以接入。它还内置了相当强大的多Agent编排架构,这也是后续进阶内容的基础。
SDK同时提供Python和JavaScript两个版本。教程明确建议,学习时优先参考官方文档和官方GitHub仓库,而不是第三方教程——因为官方来源更加可靠,本系列讲解的绝大多数概念也都来自官方文档。
准备API Key:ChatGPT账号不够用
要使用Agents SDK,必须先拿到OpenAI的API Key。这里有一个容易被忽略的坑:普通的ChatGPT账号是无法直接获取API Key的。需要单独进入OpenAI的API平台(platform界面)登录,并购买至少5美元的credit,才能开始调用和实验。教程作者认为5美元对于实验用途来说已经相当充裕。
在平台的左侧菜单中可以找到API Keys面板,这里会列出所有已创建的Key。创建新Key时有几个关键选项:
- Key名称:建议起一个语义清晰的名称(例如learning key),方便日后识别和清理
- Project:可以归入自定义项目,也可以放在默认项目中
- 过期时间(Expiration):这是必填项,可选1天、7天、30天或自定义,也可以选never。教程作者强烈建议不要选never,而是设置一个合理的过期时间,避免Key遗失后被滥用
- 权限限制:可以按需关闭tracing、voice等功能,也可以设为只读
创建完成后,Key只显示一次,必须立刻复制并妥善保存,之后将无法再次查看。
安装与环境配置
环境隔离是第一步。教程演示了用python -m venv openai_env创建虚拟环境,然后激活并执行:
pip install openai-agents
这条命令会安装Agents SDK所需的全部依赖。教程中还额外安装了viz包用于可视化(非必需)。
用.env管理密钥
一个关键的工程习惯:绝不要把API Key写进代码或提交到GitHub。标准做法是使用.env文件,变量名必须严格写为OPENAI_API_KEY——如果名字不对,SDK将无法识别。同时必须确保.gitignore正确配置,防止密钥被推送出去。
所有代码都通过load environment的方式读取密钥,代码中不出现任何明文Key。
一行代码创建第一个Agent
创建Agent的代码极其简洁:
from agents import Agent, Runner
agent = Agent(
    name="teacher",
    instructions="You are an experienced Python teacher",
    model="gpt-4o-mini"
)
这就是创建一个Agent的全部——只需要指定名字、角色指令和模型。教程选用了gpt-4o-mini,理由是它对实验场景足够便宜,同时能力也不弱。
选择模型时,官方文档提供了清晰的对比表,包括context window、输入/输出token价格、支持的数据类型等。教程特别提醒:输出能力并非所有模型都相同,比如gpt-4o-mini支持文本和图像输入,但输出只支持文本。如果项目需要生成图像、视频或音频,就必须选择其他模型。
用Runner执行Agent
创建好Agent后,通过Runner.run来执行:
result = await Runner.run(agent, "async在Python中如何工作?")
print(result.final_output)
SDK会连接OpenAI服务器并返回结果,通过result.final_output即可拿到最终答案。
Runner的三种执行方式
理解Runner的执行模式,是使用这个SDK的关键。教程用同步调用做了对比分析。
同步调用:run_sync
同步调用意味着发一个请求后,必须等待Agent返回结果,期间其他所有操作都被阻塞。如果有多个Agent在运行,第一个Agent没完成之前,其余Agent只能等待。
调用方式是用Runner.run_sync,它会立即返回响应。需要注意的是,同步调用无法在Jupyter Notebook中运行,因为Notebook缺少必要的事件循环。它必须在终端里用普通Python文件执行。教程演示了在终端运行python sync_call.py并成功获得输出的过程。
异步调用:run + await
异步调用使用Runner.run,但必须配合await关键字。如果只写Runner.run(...)而不加await,得到的只是一个coroutine对象——一个没有被执行的协程。加上await后,协程才会被真正执行。
异步调用的优势在于不阻塞其他任务。底层有事件循环(event loop)机制,多个Agent可以并行工作,哪个Agent有空闲的带宽或内存就执行哪个,彼此之间无需排队等待。
流式异步:run_stream
流式模式让响应像打字一样逐字输出:
async for event in Runner.run_stream(agent, question):
    # 处理text delta并即时打印
LLM每识别出一小段内容,就立即推送到缓冲区并打印到终端,而不是等整段响应生成完再一次性显示。这就是我们在ChatGPT里看到的逐字生成效果的实现原理。
事件循环(event loop)是异步编程的运行时引擎。在Python中,asyncio 库提供了一套事件循环机制:它维护一个任务队列,不断检查哪些协程已经就绪、哪些还在等待I/O。当一个协程发起网络请求时,它会把控制权交还给事件循环,让循环去执行其他就绪的任务;等请求返回后,再恢复该协程。这正是异步Agent能够并发工作的底层原理。
而同步调用之所以无法在Jupyter Notebook中运行,原因在于Notebook自身已经运行着事件循环(用于处理交互式cell执行),如果再调用 run_sync,就会试图在已有循环中嵌套启动新循环,Python会直接抛出“This event loop is already running”的错误。解决方法要么是在普通.py文件中运行,要么在Notebook中改用 await Runner.run(...)。理解这一点,是排查Agent执行环境问题的第一步。
RunResult对象:调试与成本控制的核心
当构建企业级应用时,必须深入了解RunResult对象。它包含了这次运行的全部细节:原始输入、最终输出、最后响应的Agent、使用了哪些工具、连接的Agent数量、以及最重要的——token消耗统计。
为什么token统计如此关键?教程给出了一个直白的判断:许多AI创业公司失败,正是因为没能追踪LLM调用的开销。有人在几小时内不知不觉支付了数千美元,却没有找出token消耗的漏洞所在。这就像管道漏水——不解决泄漏点,就永远填不满水池。
通过可视化工具可以生成Agent的架构图:
在示例中,因为只调用了单个teacher Agent、没有使用工具,架构图非常简单:会话开始 → teacher执行API调用 → 结束。但当涉及多Agent协作和工具调用时,这张图会清晰呈现整个系统架构,帮助新加入的开发者快速理解系统运作方式。
工具系统:Hosted Tool与自定义工具
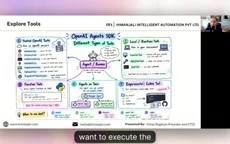
没有工具的Agent能力有限。LLM本身只像大脑,只能基于训练时的记忆回答问题,而外部工具才是扩展能力的关键。教程将工具分为几大类。
Hosted Tool(托管工具)
这些工具由OpenAI服务器提供,内置在SDK中,直接调用即可,无需编写实现代码。包括:
- Web Search:联网检索并附带来源引用
- File Search:文件检索
- Code Interpreter:代码执行
- Hosted MCP:模型上下文协议
- Image Generation:图像生成
- Tool Search与Programmatic Tool
教程用Web Search做了实测:gpt-4o-mini的训练数据截止于2024年7月,对当前最新的新闻完全不了解。当询问印度UPI支付网关MDR收费的最新动态时,模型无法依靠自身知识回答,必须依赖Web Search联网。运行后,Agent不仅给出了答案,还逐一标注了来源(Business Standard、NDTV等)。
Model Context Protocol(MCP)是Anthropic在2024年底提出并迅速被业界采纳的开放协议,目标是标准化LLM与外部工具、数据源之间的通信方式。可以用“AI领域的USB-C接口”来理解它:过去每接一个工具就要写一套定制胶水代码,而MCP定义了一套统一的服务端/客户端契约,任何遵循该协议的工具服务器都可以被任何支持MCP的Agent直接调用。
Hosted MCP意味着由OpenAI托管这些MCP服务器,开发者只需在SDK中声明要连接哪个MCP Server,无需自己部署和维护。它带来的好处是:既能复用社区大量现成的MCP Server(如文件系统、数据库、GitHub等),又能享受托管方提供的稳定性和安全隔离。对于企业级Agent来说,MCP正在成为工具生态的事实标准,理解它对后续构建复杂多Agent系统至关重要。
本地/运行时工具
这类工具让Agent获得操作系统级别的能力,可以创建、删除文件,运行shell命令,甚至操作应用程序。教程类比了Claude的computer use能力——当Agent需要与本地系统交互时,这类工具提供支持。
自定义函数工具
我们希望自己写Python函数并让Agent调用,只需一个装饰器:
from agents import function_tool

@function_tool
def my_tool():
    """工具的功能描述"""
    ...
不加装饰器时,my_tool只是一个普通Python函数。加上@function_tool后,它就变成了Agent可用的工具,SDK会从中提取名称、描述和JSON schema,帮助Agent理解工具的用途和调用方式。
JSON Schema是描述JSON数据结构的规范,也是function calling机制的核心桥梁。当用 @function_tool 装饰一个Python函数时,SDK会通过内省(introspection)自动读取函数的参数名、类型注解以及docstring,然后生成一份符合JSON Schema的“工具说明书”,随请求一起发给LLM。
LLM本身并不执行任何代码,它只是根据这份schema判断:用户的请求是否需要调用某个工具、应该传入哪些参数。模型返回一个结构化的调用意图后,SDK在本地真实执行你的Python函数,再把结果回传给模型生成最终回答。这就是“函数工具”的完整闭环。因此,写好函数的docstring和类型注解极其重要——它们是模型判断何时调用、如何调用的唯一线索;描述模糊会导致模型漏调或错调工具,这是自定义工具最常见的调试痛点。
实战:TODO任务助手Agent
教程最后用TODO助手把前面所有概念串起来。代码复用了此前用本地Llama版本写过的任务管理逻辑,只是这一次改造成OpenAI Agents SDK的函数工具:
- add_task:添加任务,包含title、priority(默认medium)和可选的detail参数
- list_task:列出所有当前任务
Agent的角色被定义为“专业的日程助理”,帮助职场人士整理日常任务,要求回复简短清晰、不附加多余建议。
实测效果:对Agent说“我需要给客户写一封信”,它自动识别出这是一个待办事项,并在本地生成task.json文件,记录下任务、优先级和完成状态。之后再询问“列出我的所有任务”,Agent能准确读取并返回之前记录的内容。
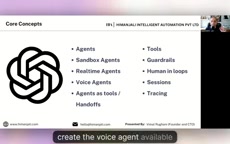
课程预告的后续内容包括:Session(会话记忆)、Tracing(集中式可观测性与调试)、以及多Agent系统——目标是构建一个社交媒体内容管理器,甚至接入Hindi语言转换Agent。
核心要点回顾
这套SDK真正的价值不在于“能跑起来”,而在于它把企业级Agent需要的观测、编排、成本和治理问题都放进了框架内。对于想从玩具Demo迈向生产系统的开发者来说,RunResult的成本可见性、Tracing的集中调试、以及Guardrail的边界控制,才是需要重点掌握的部分。
相关推荐

Agent Harness 已死?Cursor 早期工程师拆解 AI 编程代理真实架构
Cursor 早期工程师 Jediah 拆解 agent harness 的真实架构:为何「harness 已死」只对了一半,数据飞轮如何让 harness 自我淘汰,以及 Grokbot、软件工厂和原语设计如何打开 agent 的新前沿。

Python访问者模式与更优替代方案详解
深入解析Python访问者模式及四种替代方案:方法模式、模式匹配、字典映射与functools.singledispatch单分派。从节点与操作的双轴矩阵出发,帮你根据变化频率选择最合适的解耦设计。

357天深度体验:Omarchy为何让我告别发行版跳槽
连续使用 Omarchy 357 天的深度体验:59 秒安装、开箱即用的音频与 GPU 支持、Quattro 版本 QuickShell 重写带来的配置迁移阵痛,以及它为何值得 Arch 用户尝试。