OpenAI Agents SDK速成:Python智能体工作流实战
OpenAI Agents SDK 速成:从基础、工具、记忆到多智能体与语音的编排原语全解析。
本文基于一档 YouTube 技术速成课程,系统梳理 OpenAI Agents SDK 的核心用法。文章从最小 Hello World 示例入手,介绍 Agent 与 Runner 两个核心类及模型配置;随后讲解工具调用的三条路径(自定义函数、预置工具、MCP 服务器);接着对比会话记忆的三种方案(SQLiteSession、Conversation ID、previous_response_id 链式拼接)及其取舍;再覆盖运行时上下文注入、Pydantic 结构化输出、needs_approval 人机协同与护栏机制;最后深入多智能体编排的交接与工具化两种模式、生命周期钩子与可观测性、流式输出与语音实时对话。结论指出,SDK 的价值在于提供可组合的编排原语,适合已在 OpenAI 生态内的团队。
OpenAI 的 Agents SDK 并非普通 API 封装,而是一套专为智能体编排设计的框架,地位类似 LangChain 或 LangGraph,但深度绑定 OpenAI 生态。本文基于一档 YouTube 技术频道的完整速成课程,梳理从基础提示到语音交互的核心用法,并穿插实操要点与设计权衡。
基础:从 Hello World 到模型配置
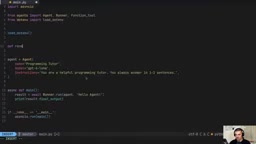
安装包名为 openai-agents,导入时却写作 agents。核心两个类:Agent 定义智能体(模型、名称、指令),Runner 负责异步执行。最小示例如下:
import asyncio
from agents import Agent, Runner

agent = Agent(
    name="编程导师",
    model="gpt-4o-mini",
    instructions="你是一名编程导师,回答不超过两句话。"
)

async def main():
    result = await Runner.run(agent, "你好,智能体!")
    print(result.final_output)

asyncio.run(main())
Runner.run 返回的结果对象包含 final_output、new_items、last_response_id 等字段,后续会话管理都依赖这些字段。模型配置可通过 ModelSettings 调整推理力度、冗余度、最大 token 数等,例如设置 reasoning=Reasoning(effort="low") 或 max_tokens=500。频道作者还演示了 RunConfig 可为单次运行覆盖模型,借助 enable_verbose_stdout_logging 可验证实际调用的模型是否生效。
工具调用:三种接入方式
智能体的核心能力是使用工具。视频展示了三条路径:
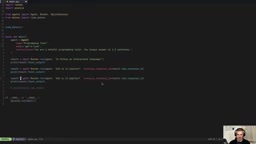
自定义函数工具:用 @function_tool 装饰器标记普通 Python 函数,将函数对象放入 tools 列表。例如一个返回随机编程语言的函数,被调用时结果对象的 new_items 中会出现 tool_call_item。
预置工具:直接使用 WebSearchTool 等内置工具,无需自行实现搜索逻辑。
MCP 服务器:通过 MCPServerStdio 连接标准输入输出的 MCP 服务。视频用 @modelcontextprotocol/server-filesystem 演示了让智能体读取当前目录 Python 文件的能力——不接 MCP 时智能体会明确表示无法访问磁盘。
需要区分“工具被调用”和“工具存在于工具列表”:只有结果对象中出现 response_function_tool_call 才证明工具真正执行。
MCP(Model Context Protocol) 是由 Anthropic 提出并开源的协议,旨在为 LLM 应用提供一种标准化的方式连接外部数据源与工具。它采用客户端-服务器架构:MCP 服务器暴露资源(resources)、工具(tools)和提示(prompts),客户端(如 Agents SDK)通过 stdio 或 HTTP 等传输层与之通信。文中 MCPServerStdio 即通过标准输入输出与本地 MCP 服务器进程通信,@modelcontextprotocol/server-filesystem 是官方提供的文件系统服务器实现。MCP 的价值在于解耦工具实现与智能体框架,同一 MCP 服务器可被不同框架复用。
会话记忆的三种方案
默认每次 Runner.run 都是独立请求,追问会丢失上下文。视频给出三种解法,各有取舍:
- SQLiteSession:本地持久化,
session=SQLiteSession("conversation-id")传入运行参数。数据由自己管理,不依赖 OpenAI 服务端。 - Conversation ID:调用
AsyncOpenAI().conversations.create()创建服务端会话,之后传入conversation_id。上下文由 OpenAI 托管。 - previous_response_id 链式拼接:将上一次结果的
last_response_id作为下一次的previous_response_id。适合分支对话——可多次基于同一个历史节点展开不同追问,实现对话分叉。
previous_response_id 是 OpenAI Responses API 的一项机制:每次 API 调用返回一个唯一响应 ID,下一次请求可通过该 ID 引用之前的响应,服务端自动将历史上下文纳入本次推理,无需客户端重传完整对话。这带来两个好处:一是减少请求体体积与 token 消耗,二是天然支持对话分叉——多个后续请求可引用同一个历史响应 ID,形成树状对话结构。但需注意,该机制依赖 OpenAI 服务端存储,上下文保留期限受平台策略约束,且无法跨供应商迁移。
运行时上下文与结构化输出
有时工具需要知道“当前用户是谁”。做法是定义 @dataclass 的 UserInfo(含 UID 字段),工具函数第一个参数接收 RunContextWrapper[UserInfo],从中取出 wrapper.context.uid。运行时通过 context=UserInfo(uid=...) 传入。这样同一个智能体可服务多个用户,权限边界由外部注入。
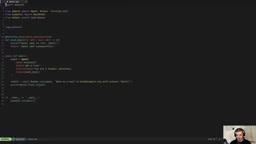
结构化输出则利用 Pydantic 的 BaseModel 定义目标结构(如 CalendarEvent 含标题、日期、参与者列表),在 Agent 中设置 output_type=CalendarEvent。返回的 final_output 即为该类型的实例,可直接访问字段并送入下游确定性逻辑。
人机协同与安全护栏
敏感操作(如发邮件)可加 needs_approval=True。运行后结果对象出现 interruptions,需遍历中断项并向用户展示参数,收集 y/n 后调用 state.approve(interruption) 或 state.reject(interruption),再将 state 重新送入 Runner.run 继续执行。拒绝时智能体会如实反馈“操作未获批准”。
护栏(Guardrail)是另一层防护。视频定义了一个 ProgrammingCheck 结构化输出(布尔字段 is_programming)的护栏智能体,配合 @input_guardrail 装饰器与 GuardrailFunctionOutput,当输入与编程无关时触发 InputGuardrailTripwireTriggered 异常。主流程用 try/except 捕获并做提示、标记用户等处置。
Tripwire(绊线)机制 是 Agents SDK 护栏设计的核心:当护栏判定输入或输出违反策略时,会抛出 InputGuardrailTripwireTriggered 或 OutputGuardrailTripwireTriggered 异常,立即中止智能体运行,而非仅返回警告。这种"快速失败"设计确保不合规请求不会进入主流程。护栏本身通常是一个轻量智能体,用结构化输出(如布尔字段)做二元判定,因此会增加一次额外的 LLM 调用开销。实践中可将护栏模型设为更小更快的型号(如 gpt-4o-mini)以平衡成本与安全。
多智能体编排:交接与工具化
多专家架构是 Agents SDK 的亮点。视频构建了编程助手、日期时间专家、搜索专家三个子智能体,再由一个 triage 智能体通过 handoffs=[...] 接收任务并路由。结果对象的 last_agent 字段可验证最终应答者。
另一种模式是“智能体即工具”:通过 agent.as_tool(tool_name=..., tool_description=...) 将子智能体包装成工具。与交接的区别在于——交接是控制权转移,工具化是主智能体保留控制权并调用子智能体。视频用日期和时间两个工具演示了单次请求触发多次工具调用的场景,这得益于智能体内置的循环机制。
交接(handoff)与工具化(as_tool) 的差异体现在控制流上。交接时,triage 智能体将整个对话控制权移交给子智能体,子智能体直接面向用户生成最终回复,last_agent 字段记录实际应答者;此后对话历史由新智能体延续。工具化时,主智能体保留控制权,将子智能体视为一个可调用的函数,子智能体的输出作为工具结果返回主智能体,由主智能体决定如何整合与回复。交接适合"分诊-专家"场景,工具化适合"主控-辅助"场景,后者还支持一次请求内多次调用不同子智能体。
生命周期钩子与可观测性
继承 RunHooks 可覆写 on_agent_start、on_agent_end、on_llm_start、on_llm_end、on_tool_start、on_tool_end 等异步方法,在关键节点插入日志、校验或指标上报。视频中 on_llm_end 还打印了 token 消耗,便于成本监控。
可观测性方面,所有调用默认记录在 OpenAI 平台的 Logs 面板,Agents SDK 标签页可查看工具调用链。若一次运行包含多次 Runner.run,它们会显示为独立工作流;用 with trace("工作流名称"): 包裹即可归组。
流式、语音与实时对话
流式输出使用 Runner.run_streamed,异步迭代 stream.stream_events(),过滤 raw_response_event 中类型为 ResponseTextDeltaEvent 的增量文本,配合 print(..., end="", flush=True) 实现逐字打印。
语音交互有两条路线。其一是 VoicePipeline 配合 SingleAgentVoiceWorkflow,录制约五秒音频后送入管道,智能体语音回复,需要额外安装 sounddevice 和 numpy。其二是 RealtimeAgent + RealtimeRunner,支持实时双向对话甚至打断智能体说话,更接近生产级语音助手体验。
关键结论
Agents SDK 的价值不在于封装 API,而在于提供了一组可组合的编排原语:会话、上下文、护栏、交接、钩子、流式与语音。视频作者强调,构建和部署智能体是当下最重要的技能之一。对于已在 OpenAI 生态内的团队,这套 SDK 能显著降低多智能体应用的工程复杂度;若需跨模型供应商,LangGraph 等方案仍值得对比评估。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
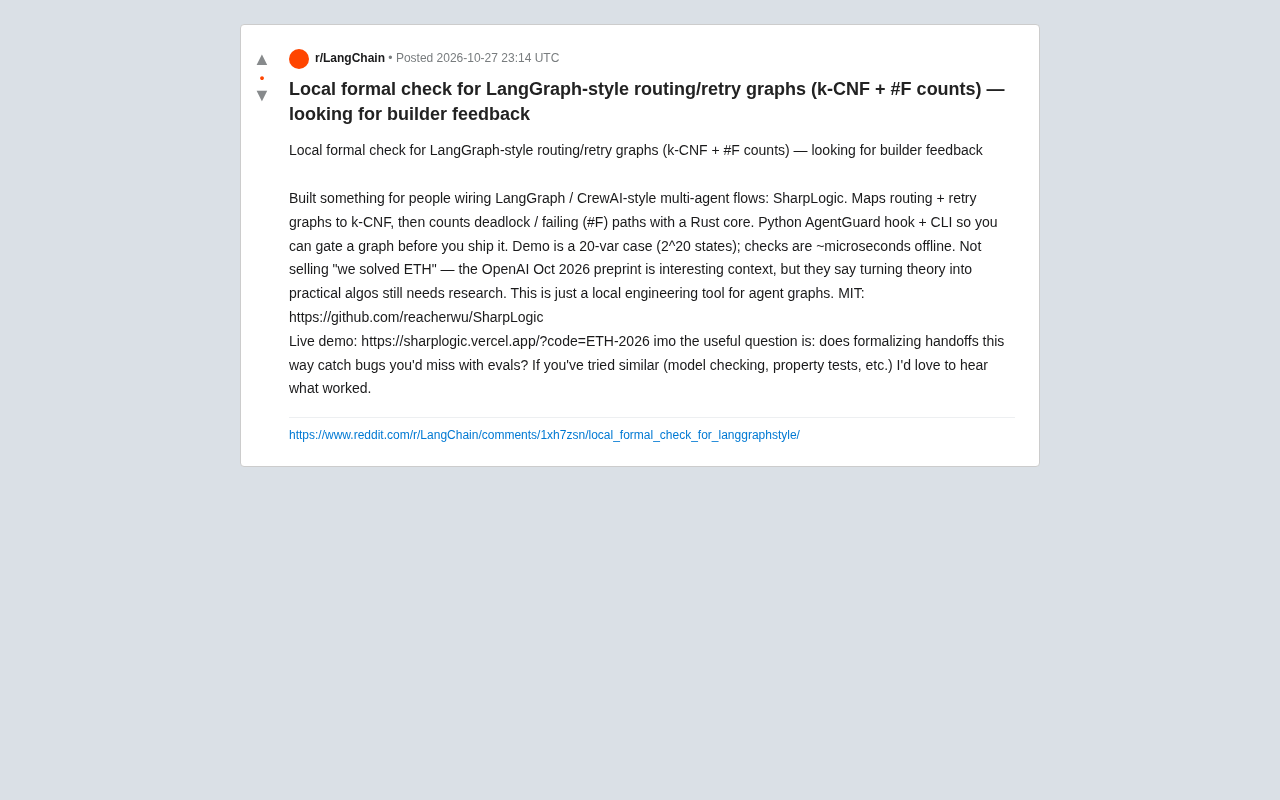
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
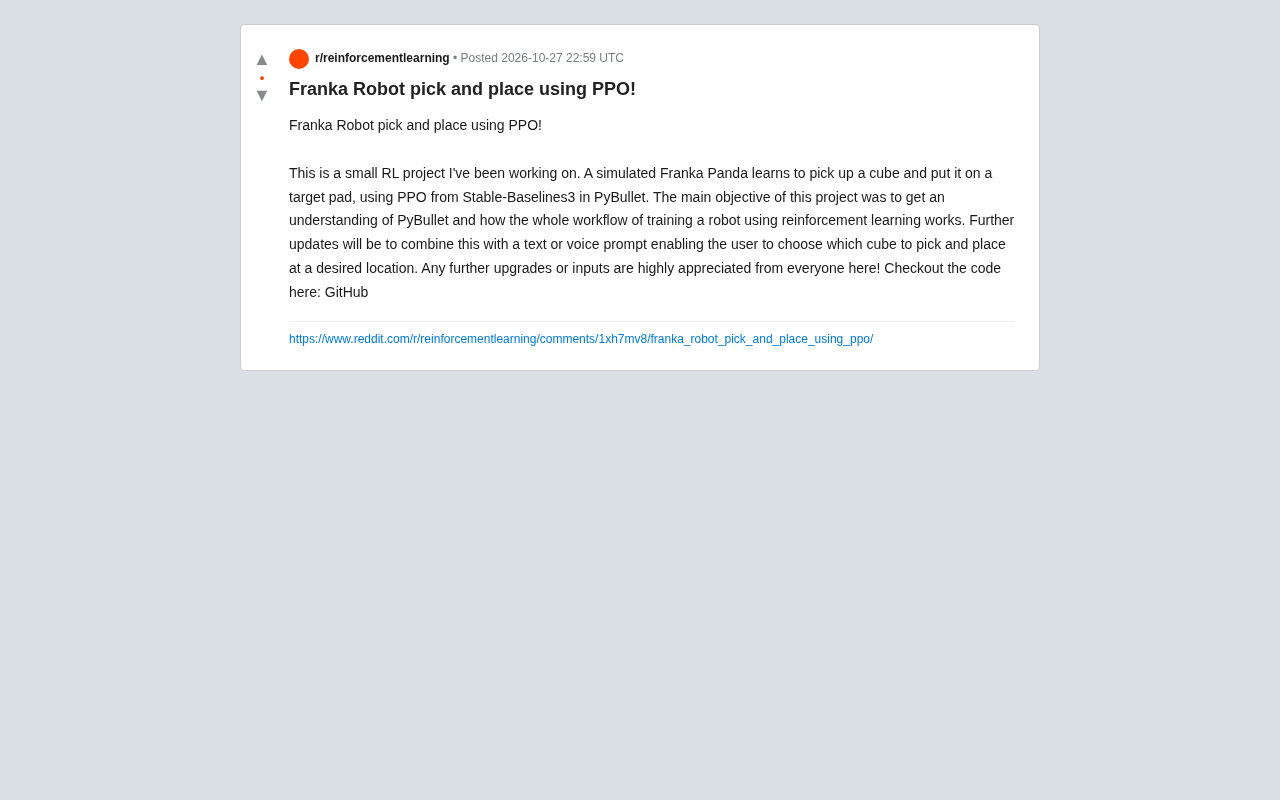
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。