OpenAI Agents SDK隐藏200个工具,Token消耗降低9倍

OpenAI Agents SDK 用 defer_loading 隐藏工具定义,配合 Tool Search 与命名空间分组,将输入 Token 从数万压至 943。
文章指出,AI Agent 挂载大量工具时,每次请求都会把全部工具的 JSON Schema 塞进模型上下文,造成严重的 Token 浪费。OpenAI Agents SDK 提供 Tool Search Tool 与 Tool Namespace 两套机制应对:通过 defer_loading=True 让工具默认对模型不可见,仅在需要时由搜索工具检索;再把 200 个工具按每 20 个一组划为 10 个命名空间,将检索范围从 200 缩小到 20。实测中,同一查询在 Plain Agent 下消耗极高,而启用 Tool Search 后首次 LLM 调用输入 Token 仅 943 个,节省约 5-9 倍,且功能不受影响。收益还包括延迟下降与多 Agent 场景的可扩展性提升。
问题:工具过多导致Token成本失控
在构建AI智能体时,一个常被忽视的成本陷阱是工具定义本身消耗的Token。当你的Agent挂载了200个工具,每次请求都会把所有工具的描述信息(JSON Schema)塞进模型的输入中——哪怕这次任务只需要其中一个工具。
据YouTube技术频道(Yash的OpenAI Agents系列)演示,这个问题的本质是:模型在收到用户请求前,已经被迫"阅读"了几百个工具的完整说明。对于拥有多Agent、多工具的大型系统,这部分开销会迅速累积成可观的账单。
JSON Schema 与 Token 消耗:在 OpenAI Function Calling 规范中,每个工具都以一段结构化的 JSON Schema 描述,包含工具名称、功能说明、参数名、参数类型、是否必填、枚举值范围等元数据。一个中等复杂度的工具(如带 5-8 个参数、含嵌套对象)其 Schema 通常就有 150-400 个 Token。200 个此类工具的完整定义平均约 3 万-8 万 Token,这部分内容会在每一轮对话请求中被完整重传——因为大模型本身是无状态的,不保留上一轮上下文,所有历史与工具定义都必须由客户端重新拼接后发送。这意味着工具定义的开销不是一次性成本,而是随请求次数线性累积,在多轮 Agent 循环中尤其明显。
解决方案:Tool Search + 命名空间分组
OpenAI Agents SDK 提供了两个关键机制来解决这个问题:Tool Search Tool(工具搜索器)和 Tool Namespace(工具命名空间)。
核心思路很直接——默认隐藏所有工具,只在模型真正需要时,由一个专门的搜索工具去"找出"正确的那个。据该视频分析,即使隐藏了200个工具,模型只需额外调用一次搜索就能定位目标,而非每次都支付全部工具的Token费用。
实现机制:defer_loading 参数
具体实现依赖 defer_loading 这个关键参数。据该频道在代码演示中说明,当 defer_loading=True 时,工具会对模型完全不可见;只有当 Tool Search Tool 根据任务描述找到它时,其信息才会进入模型上下文。
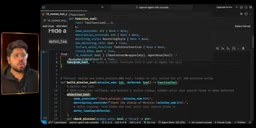
演示中的做法是:构建一个工具工厂函数,在其中通过 name_override 自定义工具名称(如 check_mission_005),并传入 defer_loading 参数来控制可见性。所有需要隐藏的工具都设置 defer_loading=True,最后再单独添加一个 tool_search_tool 负责检索。
Function Calling 与工具路由的常识背景:传统做法是把所有可用工具一次性交给模型,由模型根据用户意图自行选择调用哪一个。这种“全量暴露”策略的优点是逻辑简单、无需额外检索步骤,缺点就是模型每次都要“读完”所有工具。Tool Search 机制本质上把这一步拆成了两级:第一级由 search tool 根据任务语义在工具库中检索候选,第二级再把命中的少量工具注入上下文供模型正式调用。从信息检索的角度看,这相当于把“暴力全量扫描”换成了“先粗召回、再精排”,用一次额外的路由调用来换取上下文的极大压缩。需要权衡的是,如果检索召回不准,模型可能拿不到正确的工具,因此工具名称和命名空间描述的语义清晰度会直接影响最终效果。
命名空间分组:降低搜索范围
200个工具即使被隐藏,如果搜索空间太大,检索效率也会下降。该视频介绍了通过命名空间分组来进一步优化。
具体做法是把200个工具按每20个一组,划分为10个命名空间(namespace),每个命名空间有独立的名称和描述。当模型需要查找工具时,先在10个命名空间中定位相关类别,再在20个工具中做精确匹配——搜索范围从200个缩减到20个。
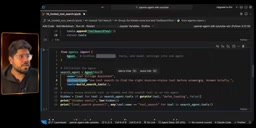
据视频演示,实现方式是用循环生成10个 ToolNamespace,每个命名空间内包含20个 build_mission_tool 实例,最终与 tool_search_tool 一起返回给Agent。
Token 预算与上下文窗口的关系:大模型的上下文窗口是有限的(例如 128K Token),而工具定义、系统提示、历史对话、检索到的文档、用户输入都要共享这一空间。工具定义膨胀不仅推高账单,还会挤占本可用于业务内容的窗口容量,甚至触发截断导致关键信息丢失。命名空间分组除了加速检索,还有一层隐含价值:它让工具库的组织结构对模型“可见”,模型可以先根据命名空间描述理解系统的能力边界,再决定是否需要深入。对于动辄上百个工具的企业级 Agent,这种层级化的元数据描述本身就是一种低成本的“能力索引”。
实测:Token从数万降至943
视频中的对比实验很有说服力。两组配置使用相同的查询"what is the status of mission 005":
- Plain Agent:200个工具全部可见,不分组、不使用Tool Search。由于工具定义全部携带在上下文中,输入Token消耗极高。
- Tool Search Agent:200个工具全部隐藏,仅暴露Tool Search Tool,配合命名空间分组。
测试结果显示,启用Tool Search后,首次LLM调用的输入Token仅为943个。据该视频作者测算,这比未优化版本便宜约5-9倍。
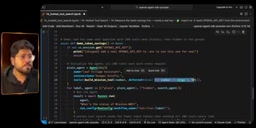
两次LLM调用(一次决定调用哪个工具、一次生成最终回答)的Token总和,相比Plain Agent方案实现了大幅节省。视频演示中,Agent正确返回了"mission 005, danger level 3, standard clear procedure"的结果,功能没有因隐藏工具而受损。
收益与适用场景
这套方案的收益不止于省钱。据视频分析,Token减少带来三个连锁效应:
- 成本降低:输入Token直接减少,账单随之下降。
- 延迟改善:更短的输入意味着更快的推理速度,响应时间缩短。
- 可扩展性:当Agent数量(N)和工具数量(N)同时增长时,Tool Search能让系统保持在可控的成本范围内。
适用场景包括:拥有大量工具的企业级Agent、多Agent协作系统、以及任何工具数量超过20个且需要控制Token预算的项目。需要注意的是,Tool Search并非零成本——它引入了一次额外的搜索调用,但当工具数量足够多时,这个开销远小于每次都传输全部工具定义的成本。
总结
OpenAI Agents SDK 的 Tool Search 功能通过 defer_loading 隐藏工具定义、ToolNamespace 分组缩小搜索范围,在保留完整工具调用能力的前提下,将输入Token压缩近一个数量级。对于工具规模膨胀的Agent系统来说,这是一个值得纳入架构设计的实用优化手段。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。