OpenAI Codex全面上云:手机开任务电脑接着干,Agents API开放公测

OpenAI将Codex完全迁移上云并开放Agents API公测,推动AI编程从本地辅助走向云端自治。
OpenAI此次更新围绕「云端自治」展开:Codex完全迁移至云端,任务可跨设备异步持续运行,不再依赖本地会话;新增Codex Security Cloud模块,持续扫描漏洞并自动准备可验证的修复方案;驱动自家产品的Agents API正式开放公测,集成托管记忆、多智能体控制和电脑操作等能力,开发者可直接调用构建自有智能体应用。企业侧则提供AWS原生运行集成,以及主打零数据保留的OpenAI Private Intelligence私有化方案,覆盖金融、医疗等高合规要求场景。性能层面,Response API一年调用量增长100倍,首Token速度提升45%,工具调用效率提升逾30%。
OpenAI对开发者工具做了一次重要升级:Codex完全搬上云端,智能体可以脱离本地设备持续运行;同时面向开发者开放了Agents API公测,并带来私有化部署、安全扫描等一系列能力。这组更新的核心,是让AI编程从「本地辅助」走向「云端自治」。
Codex上云:合上笔记本,任务照样跑
过去使用Codex这类编程助手,任务通常绑定在本地会话里——关掉终端或合上笔记本,上下文就断了。这次最直观的变化是,Codex现在完全运行在云上。你可以在手机上新建一个任务,回到浏览器或桌面端时,智能体会从上次中断的地方继续执行,线程不会丢失。
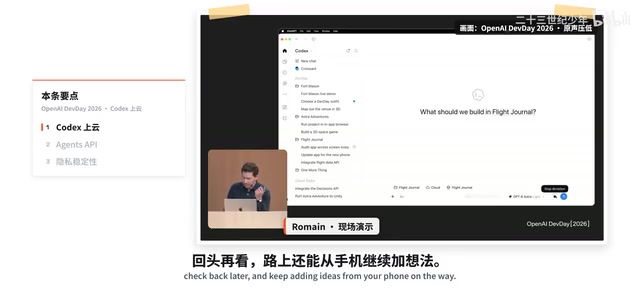
演示里给出的典型场景很说明问题:新建任务时选择「云端」,下达一条「把整个后端用Rust重写」的指令。这种活儿往往要跑很长时间,交给云端后,开发者可以关掉电脑去忙别的,甚至在路上通过手机继续补充需求和想法,智能体会一直干下去。
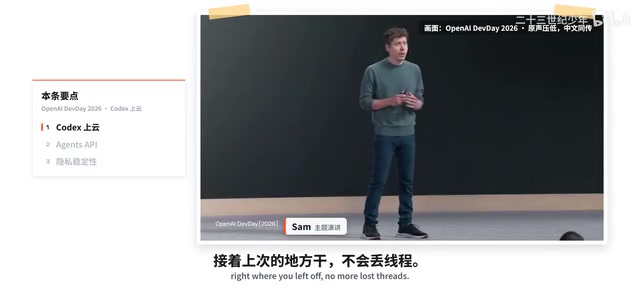
这背后其实是开发工作流的一次形态转变:从「人盯着AI写代码」变成「人下达目标、异步审阅结果」。对于长耗时的重构、迁移类任务,这种异步模式能显著减少人工等待的时间成本。
Codex Security Cloud:持续找漏洞,备好修复等审阅
云端还新增了一个安全模块——Codex Security Cloud。它会持续扫描代码库查找安全漏洞,并且不只是报告问题,而是直接准备好「验证过的修复方案」,等开发者来审核确认。
配套的还有自动化的定时扫描能力,核心界面据称当天即可使用。把安全审计从一次性人工动作变成常驻后台的持续过程,这对大型代码库的安全维护很有价值。相比传统的「扫描报错—人工定位—手动修复」链条,预先给出可验证的修复补丁,能把安全响应的门槛降低不少。
Agents API开放公测:把Codex的底层能力交给开发者
这次更新里分量最重的,是Agents API开放公测。驱动Codex以及Dots等产品的这套底层技术,现在直接开放给开发者构建自己的智能体应用。
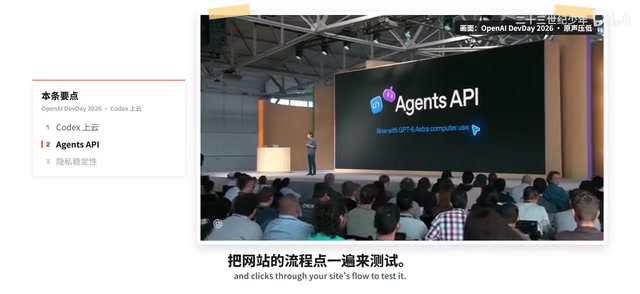
据演示介绍,这套API打包了几项关键能力:托管记忆(Hosted Memory),让智能体具备持续的上下文记忆;多智能体控制,支持编排多个智能体协作;以及新增的**电脑操作(Computer Use)**能力。
电脑操作是其中很有想象空间的一项。演示举例,可以让智能体打开浏览器,把一个网站的业务流程完整点一遍,用于端到端测试。这意味着智能体不再局限于生成文本或代码,而是能直接操作图形界面完成真实任务,覆盖自动化测试、流程操作等场景。
**托管记忆(Hosted Memory)**值得单独解释一下。传统API调用是无状态的——每次请求都是独立的,服务器不保留任何上下文。开发者如果想让智能体「记住」之前的对话或操作历史,必须自己管理上下文窗口,把历史信息打包进每次请求,既消耗Token又容易超出长度上限。托管记忆把这层状态管理交给平台来做,智能体可以跨会话、跨任务保留关键信息,而不必在每次调用时重新传入完整历史。这对需要长期运行、累积知识的智能体应用(比如持续跟踪一个项目进度的助手)来说,是从「每次从零开始」到「有连续记忆」的根本性转变。
企业级部署:AWS原生运行与私有化智能
面向企业客户,OpenAI给出了两条落地路径。
其一是与AWS的深度集成——OpenAI的智能体可以直接运行在亚马逊云上,紧挨着企业已有的应用和数据。对于大量基础设施建在AWS上的企业,这省去了数据跨云搬运的成本和合规顾虑。
其二是OpenAI Private Intelligence开放预览,主打零数据保留加上私有安全处理,内容完全不存储在OpenAI的服务器上。这是针对金融、医疗等对数据隐私要求极高行业的明确回应,也是企业采纳大模型时最在意的一道门槛。
**零数据保留(Zero Data Retention)**是企业合规场景的关键概念。通常情况下,调用大模型API时,服务提供商可能会短暂存储请求和响应内容,用于安全审计、滥用检测或模型改进。对于金融报表、病历、法律文书等敏感数据,这种存储哪怕是临时的,也可能触发GDPR、HIPAA或国内数据安全法等监管要求,或者违反企业内部的数据治理政策。零数据保留承诺请求内容在处理完成后立即丢弃,不落盘、不用于训练,从合规角度为高敏感行业提供了可落地的采购依据。Private Intelligence方案将这一承诺与私有化安全处理结合,意味着数据不仅不被留存,整个处理过程也在隔离环境中完成,进一步堵住了数据泄露的潜在路径。
性能数据:Response API一年增长100倍
除了功能层面的扩展,OpenAI也给出了一组稳定性与性能数据。Response API过去一年调用量增长了100倍,可以侧面反映开发者生态的采纳速度。
性能上,首个Token返回速度加快了45%,工具调用速度提升超过30%。对于智能体应用来说,首Token延迟和工具调用效率直接影响交互体验和任务执行时长,这两项提升对实际落地的价值不容小觑。
小结
把这些更新串起来看,OpenAI的方向相当清晰:让智能体脱离单一设备、跨端持续运行,并把驱动自家产品的底层能力通过Agents API下放给开发者。云端自治、持续安全扫描、电脑操作、私有化部署,每一项都在为「AI智能体真正进入生产环境」铺路。对开发者而言,异步的、可审阅的、能操作真实环境的智能体工作流,可能会成为接下来一段时间的主流形态。
相关推荐

从工作流到评估驱动:AI时代解决任务的范式转变
AI解题范式正从设计确定性工作流转向「定义评估+爬山优化」。本文解析评估驱动如何重塑任务解决方式、数据供应商的新角色、人类从执行者到方向制定者的转变,以及Agent应用界面的演化趋势。

收据伪造检测模型接近随机?文档图像取证的实战困境与破局思路
一个收据伪造检测项目的 ROC-AUC 始终接近随机水平,本文剖析文档图像取证中的小样本困境,并给出从二分类转向异常检测、自监督预训练、数值一致性校验等可验证的破局方向。

特斯拉Powerwall+电动车:停电时的双重备用供电方案
特斯拉Powerwall家庭储能系统结合电动车双向充电,可在停电时提供多重备用供电。本文解析Powerwall续航能力、车辆作为备用电池以及超充补能的闭环方案与现实边界。