OpenAI Connectors故障频发:第三方集成为何总出问题?

OpenAI报告Connectors高错误率,暴露AI平台第三方集成层的结构性脆弱与披露不足。
OpenAI状态页于UTC 10月22日03:50报告Connectors出现高错误率并正在调查,但未披露受影响的具体连接器与根因。文章指出,Connectors作为连接Google Drive、Slack、GitHub等第三方应用的集成框架,其请求链路跨越推理层、连接器网关、OAuth授权层与第三方API,任一环节的限流、超时或令牌失效都会表现为用户侧错误。在Agent式工作流中,这类错误会被重试机制放大,带来额外token成本与结果偏差。文章还指出OpenAI状态页历史披露颗粒度不足,企业运维难以判断影响范围,并建议团队配置降级策略、应用侧错误监控与OAuth令牌轮换。
事件回顾:Connectors错误率突增
据OpenAI官方状态页消息(UTC时间10月22日03:50),平台正在调查影响Connectors功能的高错误率问题。状态页更新的原文为:“We are investigating elevated errors affecting connectors. We will provide an update as soon as possible.”(我们正在调查影响连接器的高错误率问题,并将尽快提供更新。)
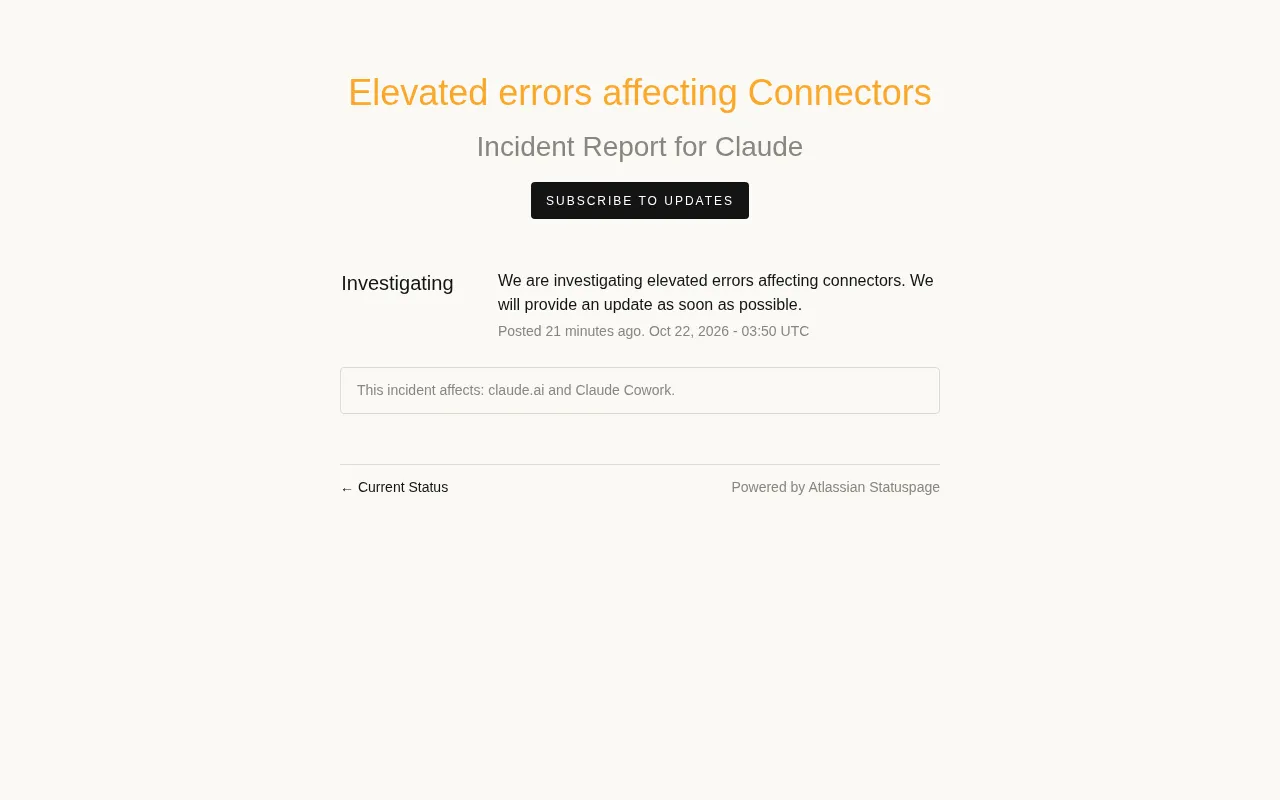
这条简短的公告印证了一个反复出现的现象:Connectors作为OpenAI生态中连接第三方应用(如Google Drive、Slack、GitHub等)的桥梁,其稳定性问题并非孤例。从状态页的措辞“elevated errors”(错误率升高)来看,问题并非完全宕机,而是部分请求失败率显著上升——这类故障对依赖自动化工作流的团队往往更具隐蔽性。
Connectors究竟连接了什么?
Connectors是OpenAI为ChatGPT等产品提供的集成框架,允许模型访问外部数据源和工具。企业用户通过它把内部文档库、代码仓库、项目管理工具接入对话界面,实现“在聊天中直接读取和操作业务数据”。
这种架构的复杂度决定了其脆弱性:一次请求需要跨越OpenAI的推理层、连接器网关、OAuth授权层,以及第三方服务的API。任何一个环节的限流、超时或令牌失效,都会表现为用户侧的“连接器不可用”。状态页只笼统标注“connectors”,恰恰说明故障定位需要跨系统排查。
OAuth 2.0 授权框架是理解 Connectors 脆弱性的关键背景。OAuth 是一种开放标准的授权协议,允许第三方应用在不暴露用户密码的前提下,获得对用户资源的有限访问权限。在 Connectors 场景中,当企业用户将 Google Drive、Slack 或 GitHub 接入 ChatGPT 时,实际上经历的是 OAuth 的"授权码"流程:OpenAI 作为客户端向第三方服务请求授权,第三方返回访问令牌(access token)与刷新令牌(refresh token)。访问令牌通常有效期较短(数十分钟到数小时),过期后需用刷新令牌换取新令牌。一旦刷新机制失效、令牌被用户手动撤销,或第三方服务调整了授权范围要求,连接器就会立即报错。这也是为什么文中把"OAuth 授权轮换"列为常见故障诱因——许多看似服务端的问题,根源在于令牌生命周期的管理。
**SLA(服务等级协议)**同样值得说明。SLA 是服务提供商对可用性、响应时间等指标的正式承诺,例如"月度可用性 99.9%"意味着每月允许约 43 分钟不可用。Connectors 本身并不直接承诺端到端 SLA,而是继承其依赖的第三方服务的 SLA。当某个第三方 API 自身跌破承诺水平,或调整速率限制(rate limit)策略时,OpenAI 侧只能被动适配。这解释了一个结构性事实:连接器的理论可用性上限,等于链路上所有依赖方可用性的乘积,依赖越多,整体可靠性越低。
第三方集成的稳定性困局
依赖链上的单点风险
Connectors的稳定性天然受制于第三方API的SLA。当Google Drive或Slack调整速率限制策略时,OpenAI一侧的适配层必须同步更新。此次错误率升高发生在UTC凌晨时段,可能与第三方服务的维护窗口或区域性网络波动有关——但官方尚未披露根因。
错误传播的放大效应
在Agent式工作流中,连接器错误会被放大。例如一个自动整理会议纪要的流程,若读取日历的连接器间歇性失败,模型可能重复重试并消耗额外token,导致用户感知到的不仅是功能不可用,还有成本异常。这类复合故障在状态页上只显示为一行“elevated errors”,信息颗粒度明显不足。
Agent 式工作流与普通对话的关键差异在于其自主性与多步执行特性。在 Agent 模式中,模型被赋予目标后,会自主规划步骤、调用工具、观察结果并决定下一步,形成一个"思考—行动—观察"的循环。这意味着一次任务可能触发数十次工具调用。当某个连接器间歇性失败时,Agent 通常不会静默放弃,而是按照预设的重试逻辑再次调用——每次重试都是一次新的模型推理,都消耗 token 并产生延迟。更麻烦的是,失败信息可能被模型误读为"数据不存在"而非"请求失败",从而基于不完整信息继续推进,产生错误结论。因此,Agent 场景下的连接器稳定性不仅关乎可用性,还直接关联成本控制与结果正确性,这也是企业需要应用侧独立监控失败率、而非仅依赖官方状态页的根本原因。
历史模式的重复
OpenAI状态页过去多次出现Connectors相关事件,模式高度相似:先是“Investigating”,数小时后更新为“Identified”或“Resolved”,期间不公布受影响的具体连接器列表。对于企业运维团队而言,这种模糊性意味着无法快速判断自身工作流是否在影响范围内,只能被动等待。
对开发者和企业的实际影响
依赖Connectors构建内部工具的团队,应把这类事件纳入架构设计考量:
- 降级策略:为关键连接器配置备用数据源或缓存层,避免单点故障直接阻断业务流程。
- 错误监控:在应用侧记录连接器调用失败率,与官方状态页交叉比对,而非完全依赖官方通知。
- 授权轮换:OAuth令牌过期是连接器错误的常见诱因,定期轮换并监控令牌健康度可减少非服务端故障。
对个人用户而言,遇到连接器报错时,优先检查第三方服务的授权状态和官方状态页,再决定是否重建连接——盲目删除重连可能触发额外的授权流程问题。
结语:状态页之外的透明度需求
此次事件本身信息有限,但它暴露的结构性问题值得关注:当AI平台把能力边界扩展到第三方生态时,故障的归因和沟通成本同步上升。一行“elevated errors”对普通用户足够,对企业运维远远不够。Connectors的可靠性,最终取决于OpenAI能否在状态页之外提供更细粒度的故障披露,以及开发者是否愿意为集成层设计足够的冗余。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。