OpenAI Decisions API 实测:比 Jev 更强还是更贵?

OpenAI Decisions API 是专为低延迟结构化判断设计的决策接口,核心优势是支持图像输入,但纯文本场景下性价比不及 Jev 和本地 Ollama。
OpenAI 正式开放的 Decisions API 并非通用聊天接口,而是专为输出空间固定的简单判断设计,支持 Predicate(是非)、Choice(分类)、Score(打分)三种问题类型,典型延迟 100—200 毫秒。实测对比显示,纯文本任务中本地 Ollama 模型最快(约 1.1 秒)且完全免费,Jev 次之(约 2.9 秒,$0.04/百万 token),OpenAI Decisions API 居中(约 2.5 秒,$0.10/百万 token)。Decisions API 的核心差异化优势在于支持图像多模态输入,而 Jev 不具备这一能力。对于已深度绑定 OpenAI 生态或有图像决策需求的团队,该 API 提供了标准化的低延迟入口;但若任务局限于文本且成本敏感,开源方案或 Jev 仍更具性价比。
OpenAI 在 Dev Days 上宣布的 Decisions API 现已对所有持有 API Key 的开发者公开。这是 OpenAI 对标 Jev(文中发音常被识别为 "Jeff")的决策模型方案——专门为输出空间固定的简单问题提供快速、低延迟的答案。本文基于一位 YouTube 技术博主的实测,从用法、速度、成本与质量四个维度,把 Decisions API 和开源 Ollama 模型以及 Jev 做了横向对比。
什么是 Decisions API:为简单问题而生
Decisions API 并不是用来和模型「聊天」的,它的设计目标是对定义明确的简单问题给出极快的回答。典型延迟在 100—200 毫秒之间,适合接近实时的决策场景,比如「根据这张图应该走哪条车道」这类不需要复杂推理的判断。
这类决策模型支持三种问题类型:
- Predicate(谓词):即是非题(在 Jev 中称为 null),例如「这个请求安全吗?」「这条消息是正面的吗?」
- Choice(选择):分类问题,例如「这是账单问题、技术问题还是物流问题?」
- Score(打分):评分问题,例如「这条消息有多正面?」「这个请求有多危险?」
换句话说,当你需要在固定的输出集合里快速选一个答案时,这类模型才是最佳工具,而不是让它去做长篇推理。
决策模型(Decision Model)与通用大语言模型的核心区别在于输出空间的约束方式。通用 LLM 的输出是开放式的自然语言,每次推理都需要完整地生成 token 序列;而决策模型将答案限定在一个预先定义的有限集合内(是/否、几个固定类别、某个分数区间),推理路径更短,因此能实现毫秒级延迟。这种架构思路并非 OpenAI 首创——传统机器学习中的分类器(Classifier)和意图识别模型(Intent Detection Model)长期承担类似职责,只是它们需要大量标注数据训练,而基于大模型的决策 API 可以通过自然语言描述选项来实现零样本(zero-shot)分类,大幅降低了接入门槛。置信度(confidence)字段是这类接口的重要设计,它让开发者能够为不确定的情况设置回退逻辑,而不是盲目信任模型输出。
Playground 快速上手
文档页面提供了 Playground 链接,可以直接在网页上测试三种模式。博主用「这张图是不是热狗」的经典梗做了演示:以 Choice 模式建模时只有 hot dog / not hot dog 两个选项,当图片实际是一本书或巧克力棒时,模型会正确返回 not hot dog;同样的问题也可以用 Predicate 模式改写成纯粹的 yes/no。

这一步最重要的收获是:Decisions API 不仅能处理文本,还能处理图像,并且三种输出类别与其他决策模型保持一致。
代码实战:文本分类与图像识别
在代码层面,调用方式与 Chat 接口不同。初始化客户端后,使用 client.decisions.create 发起请求,模型只能选 GPT-6 Luna——目前这是唯一支持的模型。
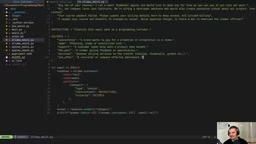
一次请求可以并行提出多个问题。博主以客服场景为例:用户输入「我上一单被扣了两次款」,然后同时附带两类问题——一个 Choice 类型的「这是什么类型的请求」(billing / technical / shipping / other,每个选项都带描述帮助模型判断),一个 Predicate 类型的「这条消息里有没有拼写错误」。
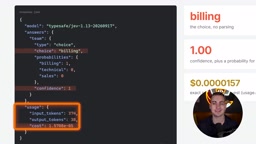
返回结果是一个包含多个答案的 decision.answers 集合。每个答案都带有 choice(或布尔结果)和 confidence 置信度,开发者可以据此写业务逻辑,比如「置信度高于 70% 时执行某操作」。实测中账单请求被正确识别为 billing、置信度接近 100%,而拼写错误检测在把 twice 故意写成 "twise" 后置信度从 0 跳到 1。
图像处理则需要先把图片用 base64 编码成文本再传入,消息格式采用 input_text + input_image 的组合。博主用一张维也纳的照片测试「这是不是欧洲城市」,模型返回了 99% 的置信度。
速度、成本与质量三方对决
这段对比是全文最有价值的部分。博主把同一批任务分别跑在 OpenAI Decisions API、Jev 和本地 Ollama 模型上。
成本方面,Decisions API 明显更贵:
- Jev:每百万输入 token 约 $0.04
- OpenAI(GPT-6 Luna):每百万输入 token 约 $0.10
- 两者的输出 token 都免费
- Ollama 自托管模型:完全免费
速度方面,在纯文本分类任务中:
- Ollama(模型加载进内存后):约 1.1 秒,最快且免费
- OpenAI Decisions API:约 2.5 秒
- Jev:约 2.9 秒,略慢
图像任务则是分水岭。Jev 不支持图像输入,所以无法参与多模态对比。在给视频缩略图分类(判断主题、是否有人脸、标题党程度打分)的测试中,OpenAI 约 3.4 秒完成,而本地运行 Qwen flash(文中识别为 "clef flash")的 Ollama 方案约 9.5 秒——不过后者运行在 Dell Pro Max/GB10(DGX Spark)设备上,更强硬件会更快。
值得强调的是打分(score)功能在图像场景下的实用性:博主用它给缩略图的「标题党程度」打分,结果与人的直觉基本一致,确实更夸张的缩略图得分更高。
Ollama 是一个允许在本地运行开源大语言模型的工具,支持 Llama、Qwen、Mistral 等主流开源模型,用户无需云端 API 即可完成推理。其速度表现高度依赖本地硬件——文中提到的 Dell Pro Max/GB10(即 NVIDIA DGX Spark)是一款面向开发者的桌面级 AI 计算设备,搭载 GB10 Grace Blackwell 超级芯片,具备较强的本地推理能力,因此 9.5 秒的图像处理时间并不代表 Ollama 方案的上限,在更高端的 GPU 上会显著缩短。对于没有专用 AI 硬件的普通开发者,本地 Ollama 方案在图像多模态任务上的延迟可能远高于测试值,这是将其与云端 API 做横向对比时需要考虑的隐性成本。
到底值不值得用?
博主的结论相当直白:Decisions API 在很大程度上就是一个更贵的 Jev,除非你需要图像输入。
决策逻辑可以这样梳理:
- 只处理文本且追求极致速度和零成本 → 自托管 Ollama 模型更划算
- 只处理文本但不想维护基础设施 → Jev 比 OpenAI 更便宜
- 需要多模态(图像)决策 → OpenAI Decisions API 是文中唯一开箱即用的选择
- 已经深度绑定 OpenAI 生态 → 用 Decisions API 省去接入成本,$0.10/百万 token 的绝对价格依然很低
对于已经在 OpenAI 体系内构建应用的团队,Decisions API 提供了一个标准化、低延迟的决策入口;但如果成本敏感、任务又局限于文本,开源模型和 Jev 仍然是更经济的方案。选型的核心,归根结底还是落在「是否需要图像」和「是否愿意自己运维硬件」这两个问题上。
Jev(文中发音常被转写为 "Jeff")是一个专注于结构化决策推理的模型服务,其定价策略($0.04/百万输入 token)明显低于 OpenAI,被视为决策场景下的轻量替代方案。值得注意的是,$0.10/百万 token 的绝对价格在 LLM API 市场中仍属极低区间——GPT-4o 等通用模型的输入定价通常在 $2.50 以上,因此即便 Decisions API 比 Jev 贵 2.5 倍,对于高频调用的生产场景(如每天数百万次分类请求),其成本依然远低于用通用模型完成同等任务。选型时应将「决策 API vs. 通用 LLM」的成本差距纳入考量,而非仅对比不同决策方案之间的差异。
相关推荐
实测Jev:只做决策不写文字的AI模型,比GPT便宜65倍
深度实测AI决策模型Jev:它不生成文本,只返回带概率的结构化决策,运行成本比GPT-5.5低65倍。通过工单路由、命令守卫、千条真实消息四项测试,解析其优势、局限与模型级联省钱策略。

MWE Emperor S2 评测:高度可调的全能工作站座椅
MWE Emperor S2 全能工作站座椅深度评测:电动可调显示器支架、多轴向人体工学调节、零重力后仰与多屏支持,适合长时间游戏与办公的重度用户。

田纳西州死刑执行失败:Christa Pike案与死刑制度之殇
田纳西州死刑犯Christa Pike在接受两剂致死注射后幸存,成为有史以来首例。Vox记者Pamela Koloff剖析这起执行失败案例背后,死刑制度在技术执行与司法公正上的深层问题。