OpenAI DevDay爆料:神秘智能体"o"与超高速API曝光
OpenAI DevDay前夕,全天候智能体"o"、超高速API、Sonnet 5.5等重磅产品密集曝光,AI迭代节奏持续加速。
距OpenAI DevDay正式召开72小时前,行业爆料密集涌现。最受关注的是代号"o"的全天候AI智能体,支持63种语言、专为长时间运行任务设计,对标Manus等自主智能体产品,底层疑似采用Aeon/Astra架构,可在云端自主工作数天乃至数周。与此同时,OpenAI超高速API服务层级(每秒750 Token)曝光,预示AI服务正进入"按延迟定价"时代。竞争对手方面,Anthropic Sonnet 5.5传闻维持原价却带来显著性能提升,MiniMax M3.1 Flash则从GitHub泄露到正式发布仅隔数小时。长周期编程智能体的能力跃升同样引人注目——某模型独立工作约25小时,生成了包含10万行代码的完整Minecraft克隆。上述内容大多来自第三方爆料,随着DevDay召开,真相很快揭晓。
AI圈的消息总是来得猝不及防。在OpenAI开发者日(DevDay)正式举办前的72小时内,大量爆料已经开始涌现,让外界得以提前窥见这家公司可能祭出的重磅内容。从神秘的全天候智能体,到针对开发者的超高速API,再到竞争对手Anthropic与MiniMax的同期动作,整个行业的节奏正在被明显拉快。
神秘智能体"o":对标Manus的长周期任务助手
目前DevDay最受关注的爆料,是一个代号为小写"o"的产品——它已经出现在ChatGPT的代码引用中。据爆料内容,"o"是OpenAI即将推出的全天候AI助手产品名,支持多达63种语言,另一个内部代号为AU1,并且显示多个服务提供商都能接入它。
OpenAI对此似乎并不避讳。官方账号持续发布疑似"o"标志的图片,产品负责人之一Timo也在X平台上反复暗示相关消息。更关键的线索是,"o"的字样曾短暂出现在ChatGPT的升级界面上,内部配置把"o"标注为显示名称,并以NegativeO作为邮件后缀——这意味着这个助手未来可能真正接管邮件处理等日常任务。
真正值得玩味的是它的产品定位。传闻"o"是OpenAI对标Grokbot、Manus和Hermes这类智能体的产品,专门围绕长时间运行任务设计。换句话说,你不再是给它一个任务后等几分钟拿结果,而是可以委派一个需要持续运行数小时、数天乃至数周的大活。底层系统据报道与代号Aeon相关,可能使用了针对长周期任务优化的Astra变体,"o"或将拥有自己的云端环境,在其中搭建环境、执行代码、做研究并持续工作直到目标完成。甚至有传闻称它可能涉及多个智能体协同沟通,共同完成同一任务。
Manus、Hermes、Grokbot均属于"自主智能体"(Autonomous Agent)赛道的代表产品。Manus由中国团队打造,2025年初以能独立完成网页操作、文件处理、代码执行等复杂任务引发广泛关注;Hermes是Nous Research推出的开源智能体框架;Grokbot则是xAI旗下面向自动化任务的产品探索方向。这类智能体的共同特征是:用户提交目标后,系统在沙盒环境中自主规划步骤、调用工具、循环执行,直至任务完成,全程无需人工干预。与传统聊天机器人"一问一答"的交互模式相比,自主智能体的设计重心在于持久性与目标导向性——它需要维护长期记忆、在出错时自我纠正,并能协调多个子任务的依赖关系。这也解释了为何"o"被设计为拥有独立云端环境:本地计算资源有限,而数小时乃至数天的任务必须在稳定的远程沙盒中持续运行。
超高速API:OpenAI在基础设施上押重注
另一个可能的重磅发布,是OpenAI把超高速API(Priority/超高速服务层级)扩展给更多开发者。有人在Response API的调试区里发现了新的速度选择器,提供"标准""快速""超高速"三个选项,OpenAI也已在API文档里把超高速列为需要全线控制的服务层级。
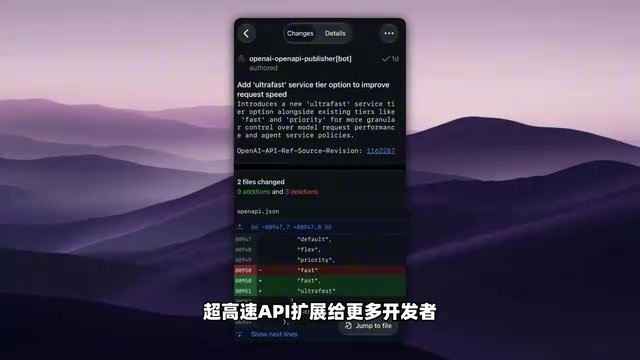
超高速本身并非全新事物。OpenAI此前已向部分客户预览过它,号称每秒最高可生成750个Token,比标准模式快约14倍,由专用服务器驱动,访问一直极为受限。结合近期被挖出的500美元ChatGPT Pro Max套餐(主打最快响应),OpenAI在速度和基础设施上的投入意图相当明显。
这背后透露出一个值得关注的趋势:AI服务可能正在进入"按延迟定价"的阶段——普通负载用标准模式,稍要求即时性用快速模式,需要秒回的前沿场景则用超高速模式,开发者可以自行决定愿意为延迟付出多少成本。如果基础设施最终成为本次DevDay的核心主题之一,并不令人意外。
Token是大语言模型处理文本的基本单位,大致对应英文中的半个单词或中文的一个字符。"每秒750个Token"这一指标衡量的是模型的推理吞吐量(Throughput),决定了用户感知到的响应速度。标准模式下,GPT-4类模型通常在每秒50-80 Token左右,而750 Token/秒意味着一篇千字文章可在约两秒内完成生成。实现超高速推理的核心手段包括:为客户预分配专用GPU服务器(避免多租户排队竞争)、使用投机解码(Speculative Decoding)等算法加速、以及针对特定模型尺寸进行硬件级优化。"按延迟定价"的商业逻辑早已存在于云计算领域(如AWS的Spot Instance与On-Demand Instance),OpenAI将其引入AI推理服务,实质上是在把基础设施能力本身变成一种可销售的差异化产品,而非仅仅比拼模型能力。
Anthropic的反击:Sonnet 5.5性价比成最大看点
另一边,Anthropic很可能会选在DevDay前后发布Sonnet 5.5,再度向OpenAI施压。官方已确认该模型将在未来几周内到来,而泄露称合作方已拿到一个更新的检查点,效果比第一个版本还要好。有报道称Sonnet 5.5已在Claude Code内部复测,测试者形容它"快得离谱、高效",并保留了此前Sonnet系列那种受欢迎的自然拟人化交流风格。
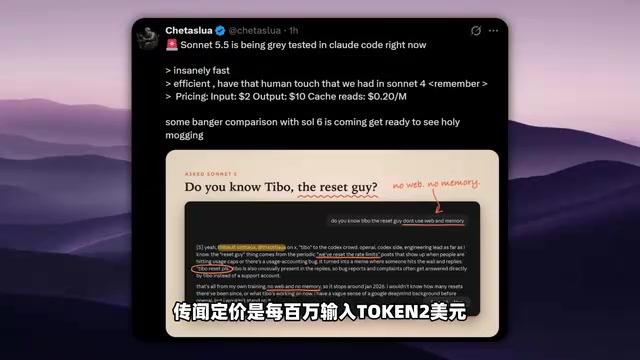
最关键的看点在于性价比。传闻定价为每百万输入Token 2美元、每百万输出Token 10美元、缓存费率20美分——而这恰好是当前Sonnet的价格水平。作为参照,Anthropic曾表示Opus 5.5在典型负载上比Opus速度快30%以上、成本低40%。如果Sonnet 5.5能拿到接近这种级别的性能提升,同时维持原有定价,它可能会成为一个"怪物级"产品。
视频作者基于自己的实测给出了相当激进的判断:认为Sonnet 5.5"全面优于GPT-6 Soul"。他展示的Minecraft克隆演示中,Sonnet 5.5 High版本不仅加上了光影包,还在右上角加了地图等额外功能,而对比模型的输出里完全看不到这些元素。需要提醒的是,这些测试说法大多未经官方确认,当作一家之言参考即可。
MiniMax M3.1 Flash:边录视频边发布的速度之战
一个颇具戏剧性的插曲是MiniMax M3.1 Flash的发布。起初它只是在MiniMax GitHub仓库的一个早期提交里被发现,相关引用在PR合并前被删掉,看起来像是一次意外泄露;而就在视频剪辑过程中,MiniMax正式发布了M3.1 Flash预览版,已通过MiniMax Code上线。从泄露到正式发布只隔了短短数小时,这本身就说明当下AI圈的迭代速度有多惊人。
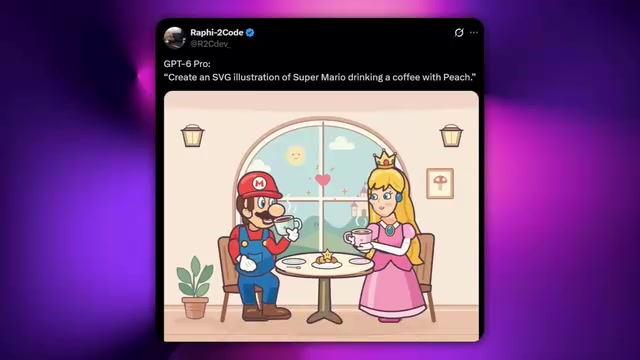
MiniMax把M3.1 Flash定位为最新的文本模型,专为日常开发打造,主打快速可靠,从修bug到构建完整功能都能覆盖。在"超级马里奥喝咖啡"的SVG插画生成对比中,GPT-6 Pro的细节水平明显更高,但作为一款极度专注速度和效率的Flash模型,M3.1 Flash仍生成了相当细致连贯的场景。作者的评价较为中肯:没有说它一次测试就超过GPT-6 Pro,但一款Flash级模型能做到这种程度,已经足够惊艳。
长周期编程智能体:从演示到"自动造游戏"
本轮爆料中最能体现趋势性的,是长时间运行的编程智能体展现出的能力跃升。作者用一个重磅演示收尾:某模型几乎完全靠代码从零搭建了一整个Minecraft克隆,项目规模相当离谱——约10万行游戏代码、2.6万行测试代码、1000个自动化测试、775个文件,智能体累计工作约25小时。更夸张的是,它还通过代码生成了783张图片、184个音效,甚至做了一份完整的游戏内上手指南。
这正是长周期编程智能体真正开始"有意思"的地方:从过去的小演示,跃升到模型能连续工作数小时、自动产出多文件完整项目。一份原本需要开发者花费数周的工作,如今可能几天就能完成。配合前文提到的"o"智能体对长周期任务的专门设计,这或许预示着智能体正从"问答工具"向"自主执行者"的方向演进。
需要强调的是,上述内容大多来自爆料与第三方测试,Aeon、Astra如何融入最终产品等细节仍停留在猜测阶段。随着DevDay正式召开,这些传闻的真伪很快就会揭晓。
10万行代码量是一个颇具参照意义的工程规模。作为对比,Linux内核0.01版本约有1万行代码,一个中型Web应用通常在5-15万行之间,而一款商业独立游戏的代码量往往在10-30万行。智能体在约25小时内独立完成这一规模的项目,涉及的挑战远不止"生成代码"本身:它需要维护全局架构一致性(跨越775个文件的模块依赖)、持续运行自动化测试并根据失败结果修复错误、管理图片与音频等异构资产的生成与集成,以及在上下文窗口有限的情况下实现跨会话的长期记忆。这些能力的组合,使得此类演示被视为智能体从"代码补全工具"向"软件工程师替代"方向演进的重要里程碑,也是学界讨论"AI软件工程师"(SWE-Agent)能力边界时的核心参照场景。
相关推荐

AI圈密集更新:Mistral Large新模型与Anthropic免费送初创公司Claude Team
AI圈近期密集更新:Mistral发布主打网络安全的Large新模型,Anthropic向初创公司免费送一年Claude Team套餐,谷歌DeepMind推多模态嵌入模型,OpenAI为ChatGPT文本加隐形水印。本文梳理七项关键进展与行业影响。

Google EmbeddingGemma 2 本地部署教程:四模态AI搜索实战
Google EmbeddingGemma 2 本地部署完整教程,支持文字、图片、视频、音频四模态跨模态语义搜索,模型仅1.49GB普通电脑可装。从Python环境安装到四模态搜索实测全流程详解。

英伟达Rubin让Devin吞吐提升4.8倍,但它真的更快了吗?
英伟达最新Vera Rubin服务器让Cognition的编程智能体Devin实现4.8倍token吞吐,但这到底意味着更快还是更便宜?本文拆解4.8倍的真实含义、GPU吞吐与速度的权衡,以及为何Devin任务不会同比例加速。